AI для новичковИнструкция
Фильтр на 40 000 комментариев через LLM: промпт keep/drop и цена
Промпт keep/drop, короткий цикл на Python и оценка токенов для фильтра на 40 000 комментариев через недорогую LLM — до запуска.
Содержание
В вашем архиве 40 000 комментариев, и большинство из них — шум: спам, «+1», шутки, ответы не по теме. Недорогая LLM может прочитать каждый и ответить одним словом: keep или drop. Отправляйте каждый комментарий отдельным коротким запросом — и весь проход обойдётся примерно в 6 миллионов входных и 200 тысяч выходных токенов (считаем около 150 токенов на входе и 5 на выходе для одного комментария). На DeepSeek-V4-Flash это $0.11 по текущей цене.
Ниже — промпт, короткий цикл на Python и арифметика, которую легко повторить для вашего архива. Всё идёт через OpenAI-совместимый адрес из документации CheapTokens.
Откуда идея#
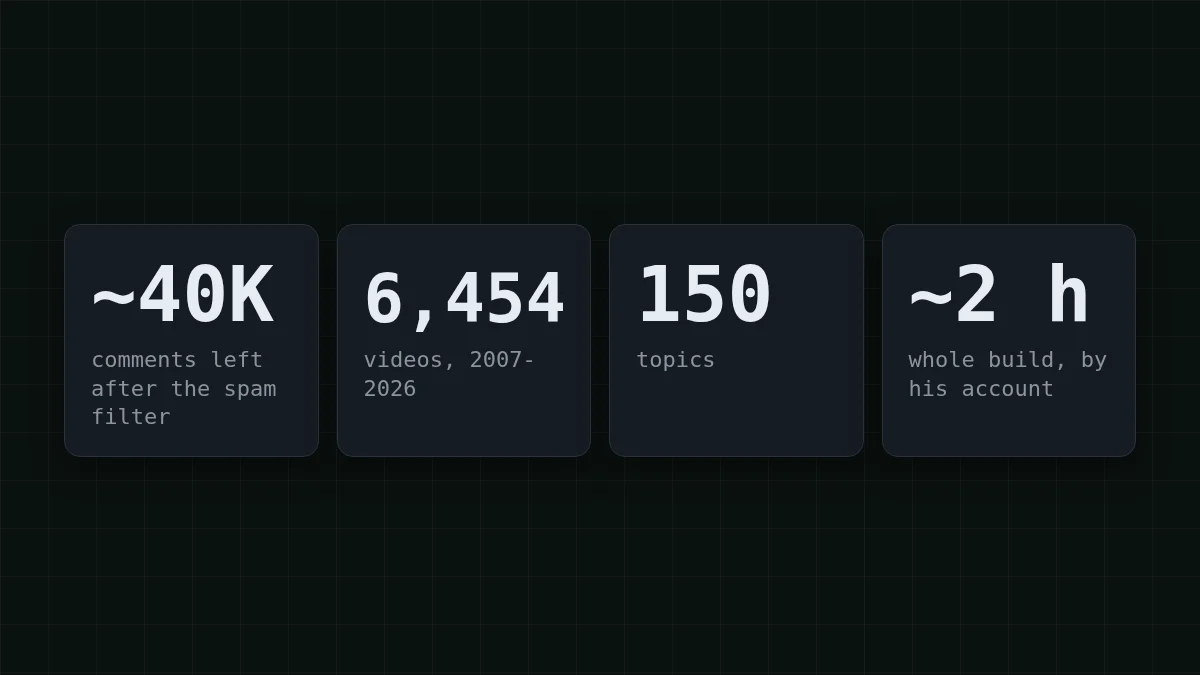
Эндрю Карпати (исследователь ИИ, сооснователь OpenAI, бывший директор по ИИ в Tesla) рассказал в посте от 31 октября 2026 года, как сделал HackerTube — сайт с видео, которые советуют в комментариях на Hacker News. В этой сборке Sonnet прошёл по комментариям в рабочем процессе Claude Code, убрал спам и оставил около 40 000 комментариев, где рекомендуют видео с YouTube. Итог — 6 454 видео по 150 темам, и, по его словам, вся сборка сейчас занимает около двух часов.
Сколько токенов ушло и во сколько это обошлось, в посте не сказано. Поэтому цифры в этой статье — арифметика по допущениям, которые названы рядом, а не пересчёт его прогона. Заимствовать можно форму задачи: много коротких текстов и один вопрос «да или нет» про каждый.
Как работает фильтр «да/нет»#
Представьте швейцара с правилом в одну строку: «пускать тех, у кого есть билет». Он секунду смотрит на каждого, говорит «да» или «нет» и не помнит предыдущего гостя. LLM-фильтр устроен так же. В каждом запросе — ваша инструкция и один комментарий, а в ответ приходит одно слово. Комментарий № 17 000 ничего не знает о комментарии № 16 999.
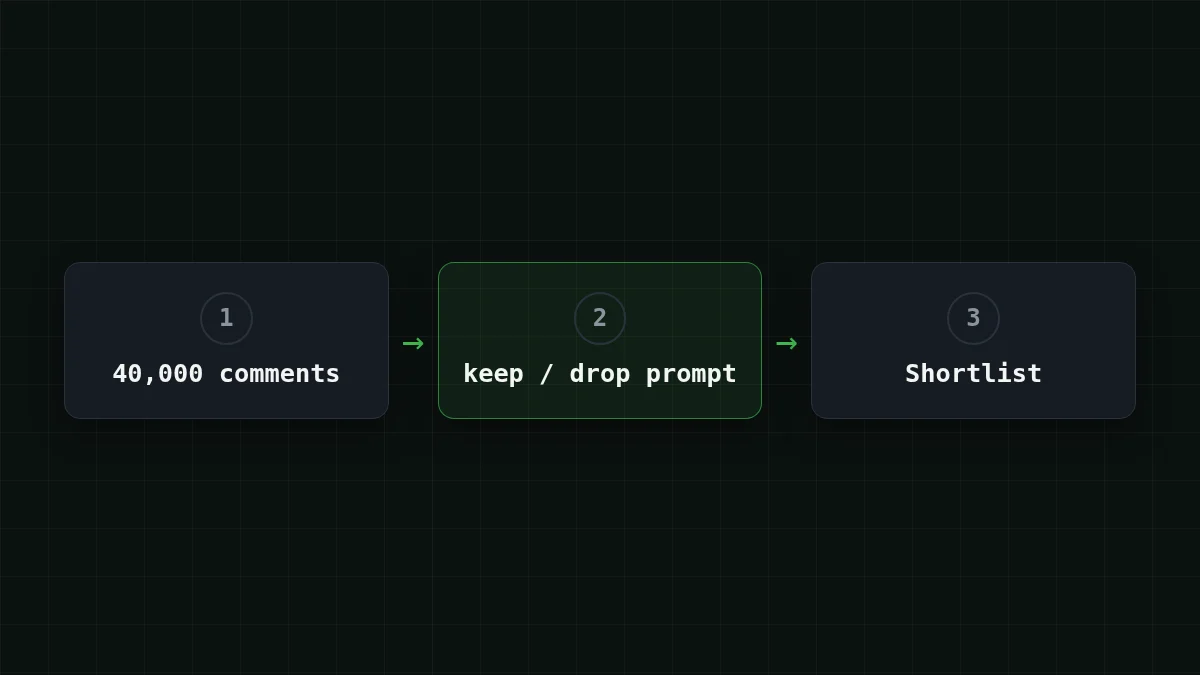
Именно поэтому счёт предсказуем. Запросы почти одного размера, значит, стоимость — это число запросов × токены в запросе. А раз ответ из одного слова, почти все деньги уходят на входную сторону: инструкцию и сам комментарий. Если деление на вход и выход вам пока непривычно, его разбирает статья входные и выходные токены.
Напишите промпт keep/drop#
В этой задаче промпт — и есть весь продукт. Сравните расплывчатую формулировку с точной:
Сравнение
Расплывчатое правило и точное
Расплывчатое
Is this comment good? Answer yes or no.Хорош для кого? Длинный вежливый комментарий про базы данных может получить «да», а короткое «watch this: <link>» — «нет». Модели приходится угадывать, что вы имели в виду, и от комментария к комментарию догадка меняется.
Точное
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Теперь у модели правило вместо настроения: что подходит, что нет и как выглядит ответ.
Допустим, пришли три комментария. Вот ответы, которых вы добиваетесь:
- «This talk on the history of Unix changed how I see shells: youtube.com/watch?v=... Worth the hour.» →
keep - «Cheap watches here!!! click my profile» →
drop - «Agree, great point about caching.» →
drop
Три привычки помогают промпту выдержать 40 000 комментариев. Скажите, что делать с остальными случаями («всё прочее — drop»), иначе модель придумает третий ответ. Просите одно слово, чтобы в коде ответ легко сравнивался с keep. И оберните комментарий в теги, как в цикле ниже: если в комментарии написано «игнорируй инструкции выше», это будет понятно как данные, а не приказ. Подробнее — в статье как подписывать каждый документ в промпте.
Цикл: один запрос на комментарий#
Вот всё целиком. Скрипт читает comments.jsonl (на каждой строке JSON-объект с полем text), просит вердикт по каждому комментарию и пишет оставленные строки в kept.jsonl. Id модели — полный gateway_id, ключ берётся из переменной окружения. Код и инструкция в примере английские, потому что комментарии Hacker News английские; для комментариев на русском напишите инструкцию на русском.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 делает вердикты более повторяемыми от запуска к запуску, а max_tokens=10 оставляет место для одного слова и не больше. Самая полезная — последняя строка: она складывает числа usage, которые возвращает API, так что вы получаете реальные токены, а не догадку.
Запустите цикл на первых десяти комментариях и прочитайте каждый вердикт сами. Если ответ выглядит обрезанным или пришёл пустым, проверьте finish_reason, как описано в статье почему ответ ИИ обрывается на полуслове. Для проверки хватит запросов по одному, а для полных 40 000 AsyncOpenAI отправляет много запросов параллельно.
Сколько стоят 40 000 комментариев#
Вот допущения — подставьте свои. Комментарий вместе с инструкцией — около 150 токенов на входе. Ответ — около 5 токенов. Комментарии Hacker News часто длиннее, так что считайте 150 нижней границей и замените её числами из репетиции. Для 40 000 комментариев:
- вход: 40 000 × 150 = 6 000 000 токенов
- выход: 40 000 × 5 = 200 000 токенов
Инструкцию обычно забывают посчитать. Она едет с каждым комментарием. Попробуйте угадать:
Угадайте число
Допустим, инструкция занимает 60 токенов. Сколько входных токенов дадут 40 000 её копий?
Ваш вариант
06 000 000
Показать ответ
Ответ: 2 400 000
40 000 × 60 = 2 400 000. Это 40% от 6 000 000 входных токенов — на текст, который никогда не меняется. Поэтому первым делом стоит сократить инструкцию.
Теперь счёт за полный проход по живым ценам:
| Модель | Вход $/1M | Выход $/1M | За запрос | 40 000 запросов | OpenRouter, 40 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 входных и 5 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
На такой нагрузке DeepSeek-V4-Flash и GLM-5.3-Flash выходят дешевле OpenRouter в сумме, с учётом входа и выхода вместе; колонка OpenRouter показывает это рядом. Обе модели рассчитаны на такую массовую работу: у DeepSeek-V4-Flash одна цена в любое время суток и до 32 768 токенов в ответе, GLM-5.3-Flash — второй вариант на том же адресе. Прогоните свою репетицию на 50 комментариях через каждую и сравните вердикты сами. Чтобы переключиться, замените строку с моделью на zai-. Актуальные цены всех моделей — на странице цен, а подробности о моделях DeepSeek в CheapTokens собраны в одном месте.
Попробуйте самиПопробуйте: в архиве 100 000 комментариев, а не 40 000. Что изменится?Показать ответ
Счёт растёт вместе с числом комментариев. 100 000 × 150 = 15 000 000 входных токенов и 100 000 × 5 = 500 000 выходных, это $0.275 на DeepSeek-V4-Flash. Тот же промпт, в 2,5 раза больше комментариев — в 2,5 раза больше стоимость.
Перед запуском#
Сначала репетиция. Возьмите 50 комментариев, запустите цикл и прочитайте все 50 вердиктов. Затем возьмите напечатанные суммы токенов: 50 × 800 = 40 000, значит, полный прогон — это токены репетиции, умноженные на 800. Так допущение «150 и 5» заменяется вашими числами.
Дальше правьте промпт на репетиции, а не на полном прогоне. Если три вердикта «drop» оказались неверными, добавьте одно предложение про такой случай и повторите те же 50. Придирчивость здесь стоит доли цента, а повтор 40 000 — заметно дороже.
И помните, что видит модель: один комментарий, без ветки. Если реплика «agree, great point» понятна только рядом с родительским комментарием, добавьте родителя в запрос. Запрос станет длиннее, так что пересчитайте токены уже с новым размером.
Когда репетиция выглядит правильно, создайте API-ключ в личном кабинете, положите его в CHEAPTOKENS_ и запускайте полный проход. Если ключ для вас в новинку, прочитайте что такое API-ключ и как его хранить — это пять минут.


