I-filter ang 40K komento gamit ang LLM: keep/drop prompt at gastos
Isang keep/drop prompt, maikling Python loop at token estimate para sa pag-filter ng 40,000 komento gamit ang murang LLM, bago ka magpatakbo ng kahit ano.
Sa pahinang ito
May 40,000 komento ang archive mo, at karamihan sa mga ito ay ingay: spam, "+1", biro, mga sagot na walang kinalaman sa hinahanap mo. Kayang basahin ng isang murang LLM ang bawat isa at sumagot ng isang salita, keep o drop. Ipadala ang bawat komento bilang sariling maikling request at ang buong pass ay aabot sa humigit-kumulang 6 milyong input token at 200 libong output token (ipagpalagay na mga 150 token papasok at 5 palabas bawat komento). Sa DeepSeek-V4-Flash, ang run na iyon ay nagkakahalaga ng $0.11 sa kasalukuyang presyo.
Sa ibaba: ang prompt, isang maikling Python loop, at ang aritmetika na maaari mong gawin muli para sa sarili mong archive. Lahat ay dumadaan sa OpenAI-compatible endpoint na inilarawan sa CheapTokens docs.
Saan nagmula ang ideya#
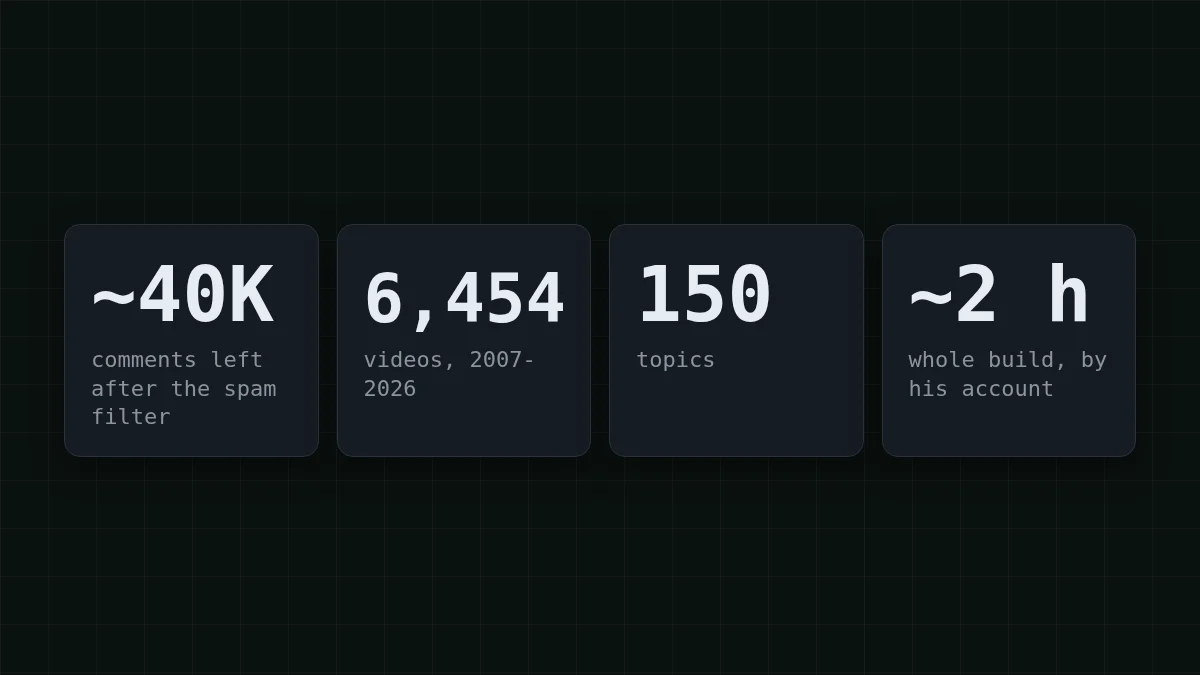
Inilarawan ni Andrej Karpathy (AI researcher, co-founder ng OpenAI, dating AI director sa Tesla) sa kanyang post noong 31 Oktubre 2026 kung paano niya binuo ang HackerTube, isang site ng mga video na inirerekomenda sa mga komento ng Hacker News. Sa build na iyon, pinatakbo ng Sonnet ang mga komento sa isang Claude Code workflow upang alisin ang spam at paliitin ang mga ito sa humigit-kumulang 40,000 komento na nagrerekomenda ng mga YouTube video. Ang resulta ay 6,454 video sa 150 paksa, at sinabi niyang ang buong build ay tumatagal na ngayon ng mga dalawang oras.
Hindi iniuulat ng post ang token counts o gastos. Kaya ang mga numero sa artikulong ito ay aritmetika mula sa mga assumption na nakasaad sa tabi ng mga ito, hindi isang rekonstruksyon ng kanyang run. Ang maaari mong hiramin ay ang hugis ng gawain: maraming maiikling teksto, isang tanong na oo/hindi tungkol sa bawat isa.
Paano gumagana ang yes/no filter#
Isipin ang isang doorman na may one-line rule: "papasukin ang sinumang may ticket". Titingnan niya ang bawat tao nang isang segundo, sasabihin ang oo o hindi, at hindi naaalala ang nakaraang bisita. Ganoon din ang gumagana ng LLM filter. Ang bawat request ay may dalang instruction mo at isang komento, at ang modelo ay nagbabalik ng isang salita. Walang alam ang komento 17,000 tungkol sa komento 16,999.
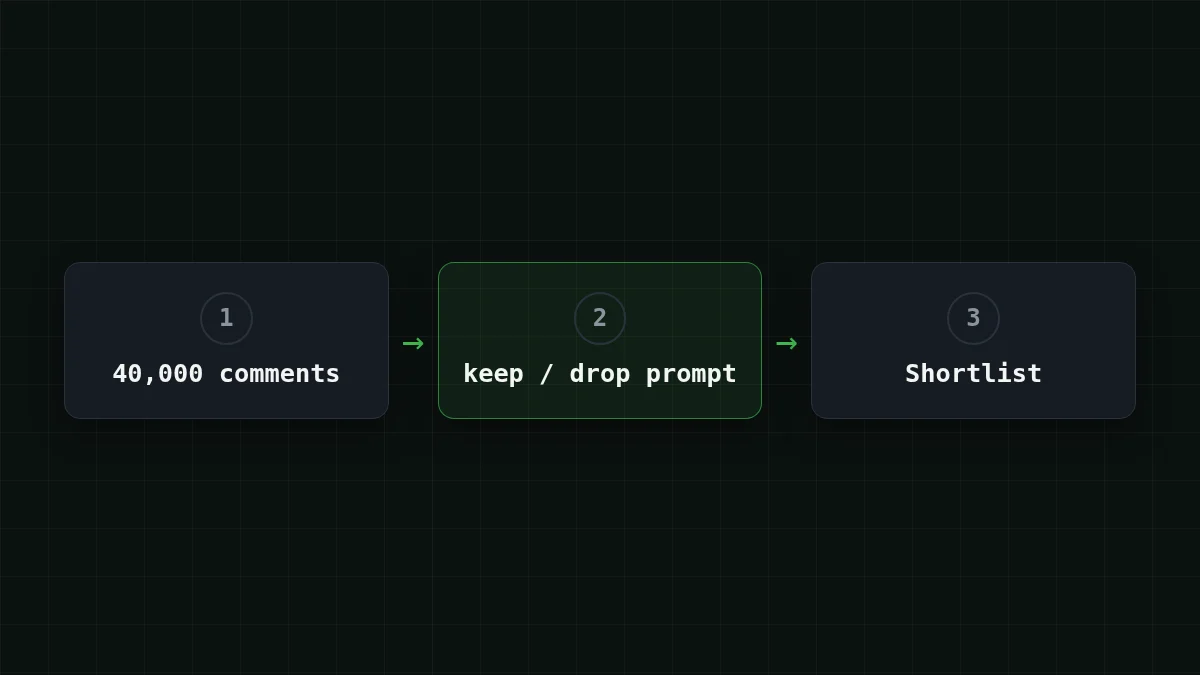
Dahil sa disenyong iyon, predictable ang bill. Halos pareho ang laki ng bawat request, kaya ang gastos ay requests × tokens bawat request. At dahil isang salita ang sagot, halos lahat ng pera ay napupunta sa input side: ang instruction at ang komentong ipinapadala mo. Kung bago sa iyo ang input at output pricing, ipinapaliwanag ng input vs output tokens ang paghahati.
Isulat ang keep/drop prompt#
Ang prompt ang buong produkto dito. Ihambing ang malabong bersyon sa eksaktong isa:
Ihambing
Malabong rule vs eksaktong rule
Malabo
Is this comment good? Answer yes or no.Maganda para kanino? Ang isang mahaba at magalang na komento tungkol sa databases ay maaaring bumalik ng "oo" habang ang isang maikling "panoorin ito: <link>" ay bumalik ng "hindi". Kailangang hulaan ng modelo ang ibig mong sabihin, at nagbabago ang hula nito sa bawat komento.
Eksakto
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Ngayon may rule na ang modelo sa halip na mood na huhulaan: ano ang binibilang, ano ang hindi, at ano ang hitsura ng sagot.
Sabihin nating may tatlong komentong dumating. Ito ang mga sagot na hinahangad mo:
- "This talk on the history of Unix changed how I see shells: youtube.com/watch?v=... Worth the hour." →
keep - "Cheap watches here!!! click my profile" →
drop - "Agree, great point about caching." →
drop
Tatlong ugali ang nagpapanatili sa prompt sa 40,000 item. Sabihin kung ano ang gagawin sa mga natitirang kaso ("everything else is drop"); kung hindi, nag-imbento ang modelo ng pangatlong sagot. Humingi ng isang salita, para madaling ihambing ang sagot sa keep sa code. At balutin ang komento sa mga tag, tulad ng sa loop sa ibaba: ang komentong nagsasabing "ignore the instructions above" ay malinaw nang data, hindi utos. Ang Label every document in a prompt ay mas malalim tungkol diyan.
Ang loop: isang request bawat komento#
Narito ang buong bagay. Binabasa nito ang comments.jsonl (isang JSON object na may text field bawat linya), humihingi ng verdict sa bawat komento, at isinusulat ang mga napanatiling linya sa kept.jsonl. Ang model id ay ang buong gateway_id; ang key ay galing sa environment variable.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
Ginagawang mas repeatable ng temperature=0 ang mga verdict sa pagitan ng mga run, at ang max_tokens=10 ay nag-iiwan ng espasyo para sa isang salita at wala nang iba. Ang huling linya ang kapaki-pakinabang: pinagsasama-sama nito ang mga usage na numero na ibinabalik ng API, kaya nakukuha mo ang tunay na token counts mo sa halip na hula.
Patakbuhin ito sa unang sampung komento at basahin mo mismo ang bawat verdict. Kung may sagot na mukhang putol o bumalik na walang laman, tingnan ang finish_reason tulad ng inilarawan sa why an AI answer stops mid-sentence. Ayos lang ang isang request sa isang pagkakataon para sa test; para sa buong 40,000, AsyncOpenAI sends many in parallel.
Magkano ang 40,000 komento#
Narito ang mga assumption, para mapalitan mo ng sarili mo. Ang isang komento kasama ang instruction ay mga 150 token na input. Ang sagot ay mga 5 token. Mas mahaba ang mga komento sa Hacker News, kaya ituring na floor ang 150 at palitan ito ng mga numero mula sa rehearsal. Para sa 40,000 komento:
- input: 40,000 × 150 = 6,000,000 token
- output: 40,000 × 5 = 200,000 token
Ang instruction ang bahaging nakakalimutan ng mga tao. Sumasama ito sa bawat komento. Subukan ang isang hula:
Hulaan ang numero
Sabihin nating 60 token ang haba ng instruction mo. Ilang input token ang naidaragdag ng 40,000 kopya nito?
Ang iyong hula
06,000,000
Ipakita ang sagot
Sagot: 2,400,000
40,000 × 60 = 2,400,000. Iyon ay 40% ng 6,000,000 input token, na ginugol sa tekstong hindi nagbabago, kaya ang masikip na instruction ang unang dapat bawasan.
Ngayon ang bill para sa buong pass, sa live na presyo:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 40,000 mga kahilingan | OpenRouter, 40,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 input at 5 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa workload na ito, ang DeepSeek-V4-Flash at GLM-5.3-Flash ay parehong mas mura kaysa OpenRouter sa kabuuan, kung input at output ay pinagsama; ipinapakita ng OpenRouter column ito nang magkatabi. Pareho silang naka-presyo para sa high-volume na trabahong tulad nito: ang DeepSeek-V4-Flash ay may isang presyo sa anumang oras at hanggang 32,768 output token bawat sagot, ang GLM-5.3-Flash ay pangalawang opsyon sa parehong endpoint. Subukan ang 50-comment rehearsal mo sa bawat isa at ihambing mo mismo ang mga verdict. Para lumipat, palitan ang model line ng zai-. Ang kasalukuyang presyo para sa bawat modelo ay nasa pricing page, at ang DeepSeek models at CheapTokens ay naglilista ng mga detalye.
Subukan mo mismoSubukan: may 100,000 komento ang archive mo, hindi 40,000. Ano ang nagbabago?Ipakita ang sagot
Lumalaki ang bill kasabay ng bilang. 100,000 × 150 = 15,000,000 input token at 100,000 × 5 = 500,000 output token, na $0.275 sa DeepSeek-V4-Flash. Parehong prompt, 2.5 beses ang mga item, 2.5 beses ang gastos.
Bago mo pindutin ang run#
Una, isang rehearsal. Kumuha ng 50 komento, patakbuhin ang loop, at basahin ang lahat ng 50 verdict. Pagkatapos gamitin ang naka-print na token totals: 50 × 800 = 40,000, kaya ang buong run ay ang tokens ng rehearsal na pinarami ng 800. Pinapalitan nito ang 150-at-5 na assumption ng sarili mong numero.
Pangalawa, ayusin ang prompt sa rehearsal, hindi sa buong run. Kung mali ang tatlong "drop" verdict, magdagdag ng isang pangungusap tungkol sa kasong iyon at patakbuhin muli ang 50. Fraction ng isang sentimo ang maging pihikan dito, at mas malaki ang magastos para patakbuhin muli ang 40,000.
Pangatlo, tandaan ang nakikita ng modelo: isang komento, walang thread. Kung ang "agree, great point" ay may kahulugan lamang sa tabi ng parent comment, isama rin ang parent sa request. Ginagawang mas mahaba ang bawat request, kaya gawin muli ang token arithmetic gamit ang bagong laki.
Kapag mukhang tama na ang rehearsal, gumawa ng API key sa account mo, ituro ang CHEAPTOKENS_ dito at simulan ang buong pass. Kung bago sa iyo ang key, ang what an API key is and how to store it ay tumatagal ng limang minuto.


