AI cho người mớiHướng dẫn
Lọc 40K bình luận bằng LLM: prompt giữ/bỏ và chi phí
Một prompt giữ/bỏ, một vòng lặp Python ngắn và ước tính token để lọc 40.000 bình luận bằng một LLM giá rẻ, trước khi bạn chạy bất cứ thứ gì.
Trên trang này
Kho lưu trữ của bạn có 40.000 bình luận, và phần lớn trong số đó là nhiễu: spam, "+1", chuyện đùa, những câu trả lời chẳng liên quan gì đến thứ bạn đang tìm. Một LLM giá rẻ có thể đọc từng bình luận và trả lời bằng một từ duy nhất, keep hoặc drop. Gửi mỗi bình luận thành một yêu cầu ngắn riêng và cả lượt chạy tốn khoảng 6 triệu token đầu vào và 200 nghìn token đầu ra (giả sử mỗi bình luận khoảng 150 token vào và 5 token ra). Trên DeepSeek-V4-Flash, lượt chạy đó tốn $0.11 theo giá hiện tại.
Dưới đây: prompt, một vòng lặp Python ngắn, và phép tính bạn có thể làm lại cho kho lưu trữ của riêng mình. Mọi thứ đều đi qua endpoint tương thích OpenAI được mô tả trong tài liệu CheapTokens.
Ý tưởng này đến từ đâu#
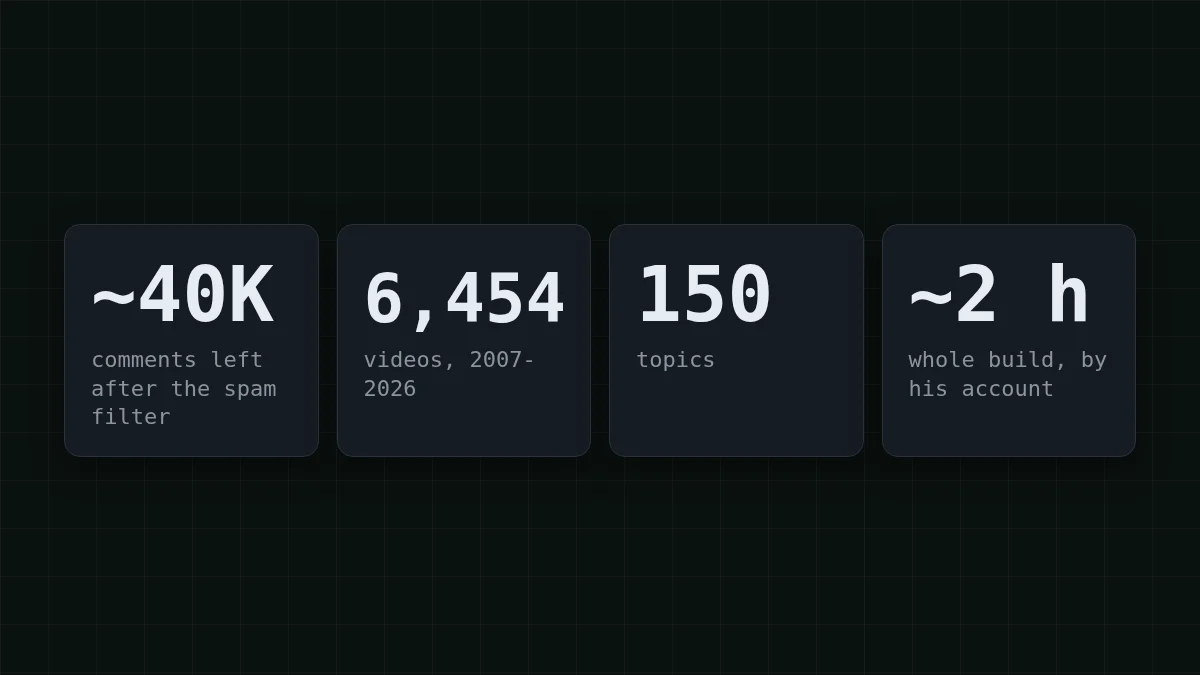
Andrej Karpathy (nhà nghiên cứu AI, đồng sáng lập OpenAI, cựu giám đốc AI tại Tesla) đã mô tả trong bài đăng ngày 31 tháng 10 năm 2026 cách anh ấy xây dựng HackerTube, một trang tổng hợp video được gợi ý trong các bình luận trên Hacker News. Trong lần xây dựng đó, Sonnet chạy qua các bình luận trong một quy trình Claude Code để loại bỏ spam và thu hẹp xuống còn khoảng 40.000 bình luận có gợi ý video YouTube. Kết quả là 6.454 video thuộc 150 chủ đề, và anh ấy nói toàn bộ quá trình xây dựng giờ chỉ mất khoảng hai giờ.
Bài đăng không báo cáo số token hay chi phí. Vì vậy các con số trong bài viết này là phép tính từ những giả định được nêu ngay bên cạnh, không phải dựng lại lượt chạy của anh ấy. Thứ bạn có thể mượn là hình dạng của nhiệm vụ: rất nhiều đoạn văn bản ngắn, mỗi đoạn một câu hỏi có/không.
Bộ lọc có/không hoạt động thế nào#
Hãy nghĩ đến một người gác cửa với quy tắc một dòng: "cho bất kỳ ai có vé vào". Anh ta nhìn từng người trong một giây, nói có hoặc không, và không bao giờ nhớ vị khách trước đó. Bộ lọc LLM hoạt động theo cùng cách. Mỗi yêu cầu mang theo chỉ dẫn của bạn cộng với một bình luận, và mô hình trả về một từ. Bình luận thứ 17.000 không biết gì về bình luận thứ 16.999.
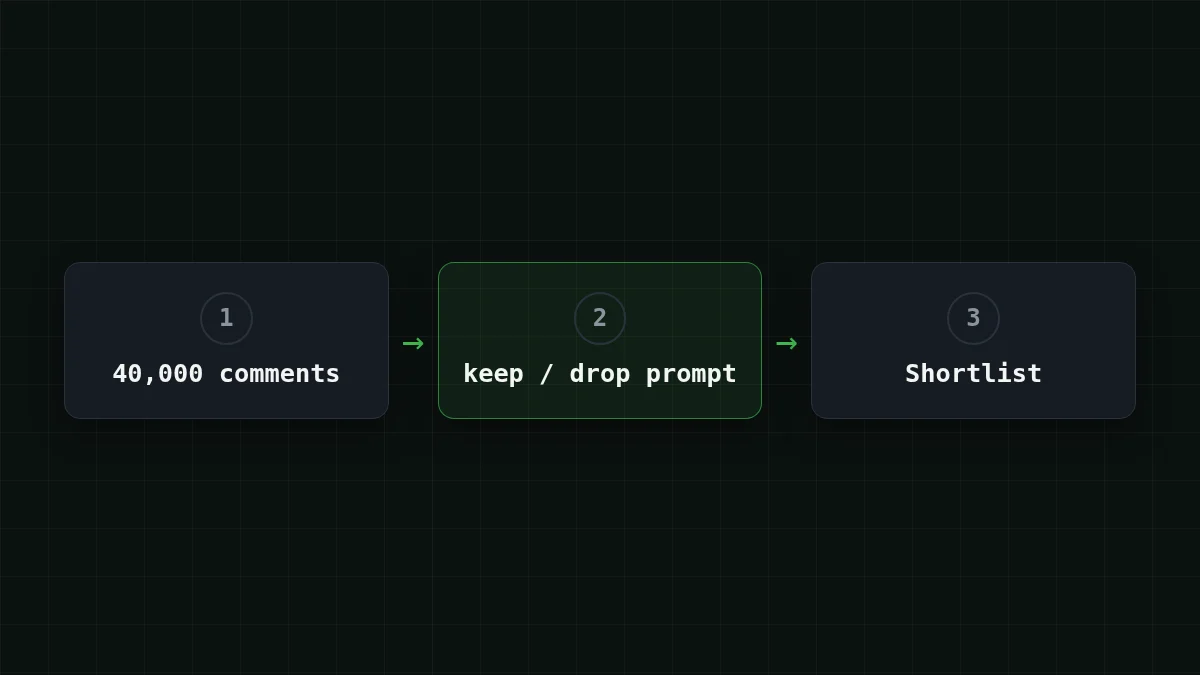
Thiết kế đó là lý do hóa đơn có thể dự đoán được. Mỗi yêu cầu có kích thước gần như nhau, nên chi phí là số yêu cầu × số token mỗi yêu cầu. Và vì câu trả lời chỉ là một từ, gần như toàn bộ tiền đổ vào phía đầu vào: chỉ dẫn và bình luận bạn gửi. Nếu giá đầu vào và đầu ra còn mới với bạn, token đầu vào so với đầu ra giải thích sự phân chia này.
Viết prompt giữ/bỏ#
Prompt chính là toàn bộ sản phẩm ở đây. Hãy so sánh một phiên bản mơ hồ với một phiên bản chính xác:
So sánh
Quy tắc mơ hồ so với quy tắc chính xác
Mơ hồ
Is this comment good? Answer yes or no.Tốt cho ai? Một bình luận dài, lịch sự về cơ sở dữ liệu có thể trả về "yes" trong khi một câu ngắn "xem cái này: <link>" trả về "no". Mô hình phải đoán ý bạn, và phỏng đoán của nó thay đổi từ bình luận này sang bình luận khác.
Chính xác
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Giờ mô hình có một quy tắc thay vì một tâm trạng để đoán: cái gì được tính, cái gì không, và câu trả lời trông như thế nào.
Giả sử có ba bình luận đến. Đây là những câu trả lời bạn nhắm tới:
- "Bài nói này về lịch sử Unix đã thay đổi cách tôi nhìn về shell: youtube.com/watch?v=... Đáng một giờ đồng hồ." →
keep - "Đồng hồ rẻ đây!!! click vào profile tôi" →
drop - "Đồng ý, ý hay về caching." →
drop
Ba thói quen giúp prompt đứng vững qua 40.000 mục. Nói rõ phải làm gì với các trường hợp còn lại ("mọi thứ khác là drop"); nếu không mô hình sẽ tự phát minh ra câu trả lời thứ ba. Yêu cầu một từ, để câu trả lời dễ so sánh với keep trong code. Và bọc bình luận trong thẻ, như trong vòng lặp bên dưới: khi đó một bình luận nói "bỏ qua các chỉ dẫn ở trên" rõ ràng là dữ liệu, không phải mệnh lệnh. Gắn nhãn cho mọi tài liệu trong prompt đi sâu hơn về điều này.
Vòng lặp: mỗi bình luận một yêu cầu#
Đây là toàn bộ. Nó đọc comments.jsonl (mỗi dòng một đối tượng JSON với trường text), hỏi phán quyết cho từng bình luận, và ghi các dòng được giữ vào kept.jsonl. Id mô hình là gateway_id đầy đủ; khóa lấy từ một biến môi trường.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 làm cho các phán quyết lặp lại được hơn giữa các lần chạy, và max_tokens=10 để chỗ cho một từ và không hơn. Dòng cuối là dòng hữu ích: nó cộng các số usage mà API trả về, nên bạn có số token thực thay vì phỏng đoán.
Chạy nó trên mười bình luận đầu và tự đọc từng phán quyết. Nếu một câu trả lời trông bị cắt cụt hoặc trả về rỗng, hãy kiểm tra finish_reason như mô tả trong vì sao câu trả lời của AI dừng giữa câu. Mỗi lần một yêu cầu là ổn cho một bài kiểm tra; với đủ 40.000, AsyncOpenAI gửi nhiều yêu cầu song song.
40.000 bình luận tốn bao nhiêu#
Đây là các giả định, để bạn có thể thay bằng số của mình. Một bình luận cộng với chỉ dẫn là khoảng 150 token đầu vào. Câu trả lời khoảng 5 token. Bình luận trên Hacker News thường dài hơn, nên hãy coi 150 là mức sàn và thay bằng số từ lần chạy thử. Với 40.000 bình luận:
- đầu vào: 40.000 × 150 = 6.000.000 token
- đầu ra: 40.000 × 5 = 200.000 token
Chỉ dẫn là phần người ta hay quên. Nó đi kèm với từng bình luận một. Thử đoán xem:
Đoán số
Giả sử chỉ dẫn của bạn dài 60 token. 40.000 bản sao của nó cộng lại thành bao nhiêu token đầu vào?
Dự đoán của bạn
06.000.000
Hiện đáp án
Trả lời: 2.400.000
40.000 × 60 = 2.400.000. Đó là 40% của 6.000.000 token đầu vào, tiêu vào đoạn văn bản không bao giờ thay đổi, nên một chỉ dẫn gọn hơn là thứ đầu tiên cần cắt gọt.
Giờ là hóa đơn cho cả lượt chạy, theo giá trực tiếp:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 40.000 yêu cầu | OpenRouter, 40.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 token đầu vào và 5 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Với khối lượng công việc này, DeepSeek-V4-Flash và GLM-5.3-Flash đều rẻ hơn OpenRouter về tổng cộng, khi tính gộp cả đầu vào và đầu ra; cột OpenRouter hiển thị để so sánh song song. Cả hai đều được định giá cho một công việc khối lượng lớn như thế này: DeepSeek-V4-Flash có một mức giá ở mọi giờ và tối đa 32.768 token đầu ra mỗi câu trả lời, GLM-5.3-Flash là lựa chọn thứ hai trên cùng endpoint. Hãy chạy thử 50 bình luận trên từng mô hình và tự so sánh các phán quyết. Để chuyển đổi, đổi dòng mô hình thành zai-. Giá hiện tại của mọi mô hình nằm trên trang giá, và các mô hình DeepSeek tại CheapTokens liệt kê chi tiết.
Tự mình thử xemThử xem: kho lưu trữ của bạn có 100.000 bình luận, không phải 40.000. Điều gì thay đổi?Hiện đáp án
Hóa đơn tăng theo tỷ lệ với số lượng. 100.000 × 150 = 15.000.000 token đầu vào và 100.000 × 5 = 500.000 token đầu ra, tức là $0.275 trên DeepSeek-V4-Flash. Cùng prompt, gấp 2,5 lần số mục, gấp 2,5 lần chi phí.
Trước khi bấm chạy#
Đầu tiên, chạy thử. Lấy 50 bình luận, chạy vòng lặp, và đọc cả 50 phán quyết. Sau đó dùng tổng token được in ra: 50 × 800 = 40.000, nên lượt chạy đầy đủ là số token của lần chạy thử nhân với 800. Điều đó thay giả định 150-và-5 bằng số của chính bạn.
Thứ hai, sửa prompt trên lần chạy thử, không phải trên lượt chạy đầy đủ. Nếu ba phán quyết "drop" bị sai, hãy thêm một câu về trường hợp đó và chạy lại 50 bình luận. Việc kỹ tính ở đây tốn một phần nhỏ của một xu, còn chạy lại 40.000 thì tốn nhiều hơn hẳn.
Thứ ba, hãy nhớ mô hình thấy gì: một bình luận, không có luồng thảo luận. Nếu "đồng ý, ý hay" chỉ có nghĩa khi đứng cạnh bình luận cha, hãy đưa cả bình luận cha vào yêu cầu. Điều đó làm mỗi yêu cầu dài hơn, nên hãy làm lại phép tính token với kích thước mới.
Khi lần chạy thử trông ổn, hãy tạo một API key trong tài khoản của bạn, trỏ CHEAPTOKENS_ vào nó và bắt đầu lượt chạy đầy đủ. Nếu khóa còn mới với bạn, API key là gì và cách lưu trữ nó mất năm phút.


