AI 入门指南
用 LLM 过滤 4 万条评论:保留/丢弃提示词与成本
一个保留/丢弃提示词、一段简短的 Python 循环,以及在运行任何东西之前用便宜 LLM 过滤 40,000 条评论的 token 估算。
你的存档里有 40,000 条评论,其中大部分都是噪音:垃圾信息、"+1"、玩笑,以及与你目标毫无关系的回复。一个便宜的 LLM 可以逐条阅读,并用一个词作答:keep 或 drop。把每条评论作为单独的短请求发送,整个流程大约消耗 600 万输入 token 和 20 万输出 token(假设每条评论约 150 token 输入、5 token 输出)。在 DeepSeek-V4-Flash 上,按当前价格这次运行花费 $0.11。
下面包括:提示词、一段简短的 Python 循环,以及你可以为自己的存档重新计算的算术。所有内容都通过 CheapTokens 文档中描述的 OpenAI 兼容端点进行。
这个想法的来源#
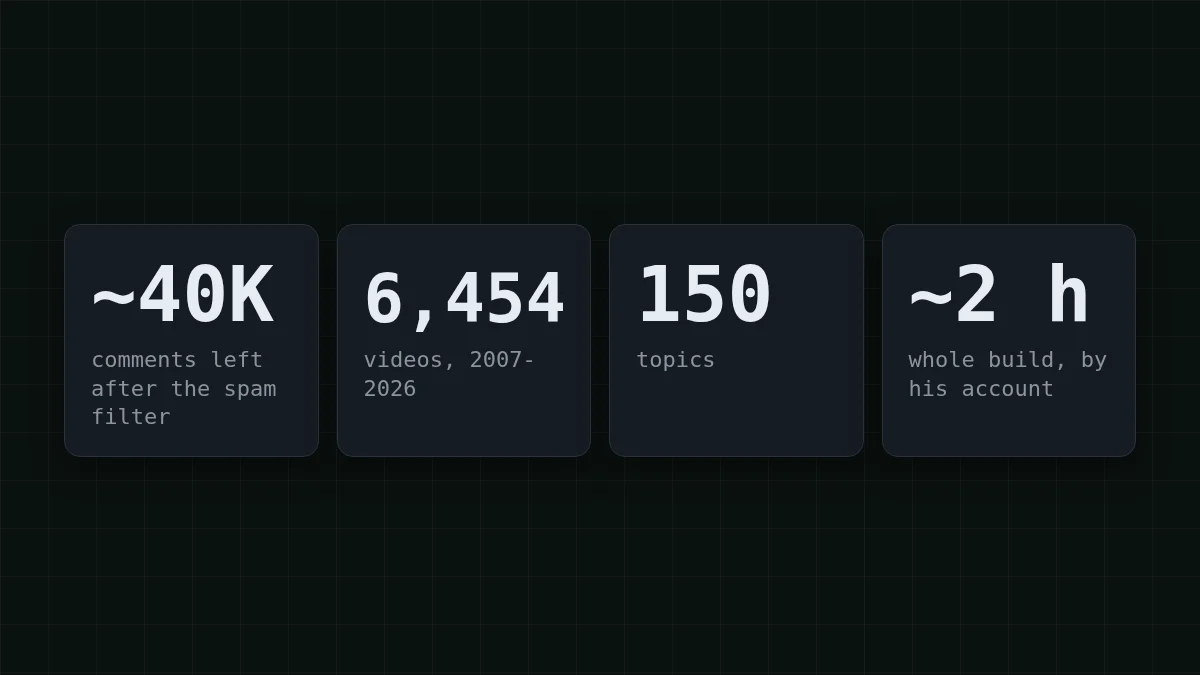
Andrej Karpathy(AI 研究员、OpenAI 联合创始人、特斯拉前 AI 总监)在他 2026 年 10 月 31 日的帖子中描述了他如何构建 HackerTube——一个收录 Hacker News 评论中推荐视频的网站。在那次构建中,Sonnet 在 Claude Code 工作流中遍历评论,去除垃圾信息,并筛选出约 40,000 条推荐 YouTube 视频的评论。结果是 150 个主题下的 6,454 个视频,他说整个构建现在大约需要两小时。
该帖子没有报告 token 数量或成本。因此本文中的数字是根据紧挨着它们列出的假设计算出来的,并非对他那次运行的还原。你可以借鉴的是任务的形态:大量短文本,每条一个是/否问题。
是/否过滤器如何工作#
想象一个门卫,规则只有一行:"有票的人都可以进"。他看每个人一秒钟,说可以或不可以,而且从不记得上一位客人。LLM 过滤器的工作方式相同。每个请求携带你的指令加一条评论,模型返回一个词。第 17,000 条评论对第 16,999 条评论一无所知。
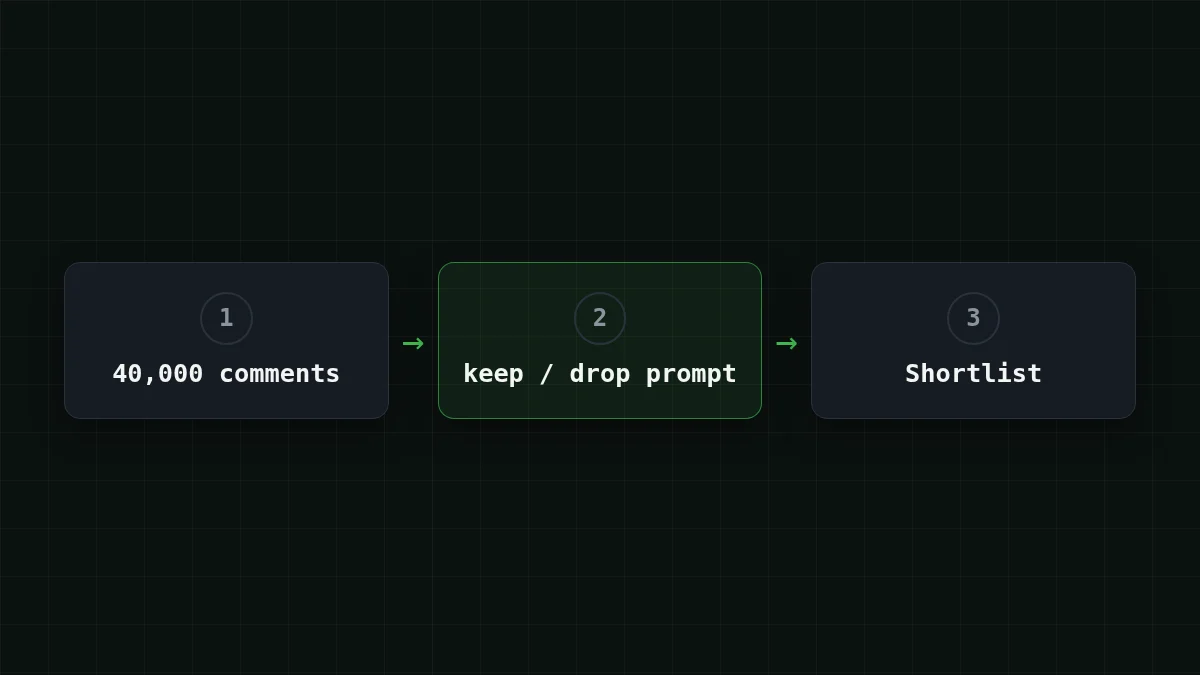
这种设计正是账单可预测的原因。每个请求的大小大致相同,所以成本 = 请求数 × 每个请求的 token 数。而且因为答案只有一个词,几乎所有的钱都花在输入侧:你发送的指令和评论。如果你对输入和输出定价还不熟悉,输入 vs 输出 token解释了这种划分。
编写保留/丢弃提示词#
在这里,提示词就是全部产品。比较一个模糊版本和一个精确版本:
比较
模糊规则 vs 精确规则
模糊
Is this comment good? Answer yes or no.对谁好?一条关于数据库的长而礼貌的评论可能返回 "yes",而一条简短的 "watch this: <link>" 却返回 "no"。模型不得不猜测你的意思,而它的猜测会因评论而异。
精确
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.现在模型有了一条规则,而不是一种需要猜测的情绪:什么算数、什么不算数,以及回复长什么样。
假设来了三条评论。这些是你期望的答案:
- "This talk on the history of Unix changed how I see shells: youtube.com/watch?v=... Worth the hour." →
keep - "Cheap watches here!!! click my profile" →
drop - "Agree, great point about caching." →
drop
三个习惯能让提示词在 40,000 个条目上保持可靠。说明剩余情况怎么处理("其他一切均为丢弃");否则模型会发明第三种答案。要求只回一个词,这样回复在代码中很容易与 keep 比较。并且像下面的循环那样,把评论包裹在标签中:这样一条写着 "ignore the instructions above" 的评论就明确是数据,而不是命令。在提示词中标记每个文档对此有更深入的讨论。
循环:每条评论一个请求#
这就是全部内容。它读取 comments.jsonl(每行一个带有 text 字段的 JSON 对象),对每条评论请求一个判定,并将保留的行写入 kept.jsonl。模型 id 是完整的 gateway_id;密钥来自环境变量。
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 使判定在多次运行之间更具可重复性,而 max_tokens=10 为一个词留出空间,仅此而已。最后一行是有用的:它累加 API 返回的 usage 数字,这样你得到的是真实的 token 计数,而不是猜测。
在前十条评论上运行它,并亲自阅读每一个判定。如果某个答案看起来被截断或返回为空,请检查 finish_reason,如为什么 AI 回答会在句子中间停止中所述。一次一个请求对于测试来说没问题;对于完整的 40,000 条,AsyncOpenAI 会并行发送许多请求。
40,000 条评论的成本#
以下是假设,你可以替换成自己的。一条评论加上指令大约是 150 token 输入。回复大约是 5 token。Hacker News 评论通常更长,所以把 150 当作下限,并用试运行的数字替换它。对于 40,000 条评论:
- 输入:40,000 × 150 = 6,000,000 token
- 输出:40,000 × 5 = 200,000 token
指令是人们容易忘记的部分。它随每一条评论一起传输。试着猜一下:
猜数字
假设你的指令有 60 token 长。40,000 份指令加起来是多少输入 token?
你的猜测
06,000,000
显示答案
答案: 2,400,000
40,000 × 60 = 2,400,000。这是 6,000,000 输入 token 的 40%,花在从不改变的文本上,所以精简指令是首先要削减的地方。
现在按实时价格计算整个流程的账单:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 40,000 次请求 | OpenRouter,40,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
每次请求 150 个输入 token 和 5 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
在这个工作负载上,DeepSeek-V4-Flash 和 GLM-5.3-Flash 的总成本都比 OpenRouter 便宜(输入和输出合计);OpenRouter 列并排展示。两者都针对这种高流量任务定价:DeepSeek-V4-Flash 在任何时段都是同一价格,每次回答最多 32,768 输出 token;GLM-5.3-Flash 是同一端点上的第二个选择。在你的 50 条评论试运行上分别试用,并亲自比较判定结果。要切换,把模型行改为 zai-。每个模型的最新价格在定价页面上,CheapTokens 上的 DeepSeek 模型列出了详细信息。
自己试试试一试:你的存档有 100,000 条评论,而不是 40,000 条。会有什么变化?显示答案
账单随数量同步增长。100,000 × 150 = 15,000,000 输入 token,100,000 × 5 = 500,000 输出 token,在 DeepSeek-V4-Flash 上为 $0.275。同样的提示词,2.5 倍的条目,2.5 倍的成本。
在按下运行之前#
第一,先试运行。取 50 条评论,运行循环,并阅读全部 50 个判定。然后使用打印出的 token 总数:50 × 800 = 40,000,所以完整运行是试运行 token 数乘以 800。这用你自己的数字替换了 150 和 5 的假设。
第二,在试运行上修正提示词,而不是在完整运行上。如果三个 "丢弃" 判定是错误的,就针对那种情况加一句话,然后重新运行这 50 条。在这里挑剔只花不到一美分,而重新运行 40,000 条则要贵得多。
第三,记住模型看到的是什么:一条评论,没有上下文线程。如果 "agree, great point" 只有在父评论旁边才有意义,那就把父评论也放进请求中。这会使每个请求更长,所以用新的规模重新计算 token 算术。
当试运行看起来正确时,在你的账户中创建一个 API 密钥,将 CHEAPTOKENS_ 指向它,然后开始完整流程。如果你对密钥还不熟悉,什么是 API 密钥以及如何存储它只需五分钟。


