AI для початківцівПосібник
Фільтруйте 40 тис. коментарів за допомогою LLM: промпт keep/drop і вартість
Промпт keep/drop, короткий цикл Python і оцінка токенів для фільтрації 40 000 коментарів за допомогою дешевої LLM, перш ніж щось запускати.
На цій сторінці
У вашому архіві 40 000 коментарів, і більшість із них — шум: спам, «+1», жарти, відповіді, які не мають нічого спільного з тим, що вам потрібно. Дешева LLM може прочитати кожен і відповісти одним словом, keep або drop. Надішліть кожен коментар як окремий короткий запит, і весь прохід коштуватиме близько 6 мільйонів вхідних токенів і 200 тисяч вихідних (припускаючи приблизно 150 токенів на вході та 5 на виході на коментар). На DeepSeek-V4-Flash цей запуск коштує $0.11 за поточною ціною.
Нижче: промпт, короткий цикл Python і арифметика, яку ви можете повторити для свого архіву. Усе проходить через OpenAI-сумісний ендпоінт, описаний у документації CheapTokens.
Звідки взялася ідея#
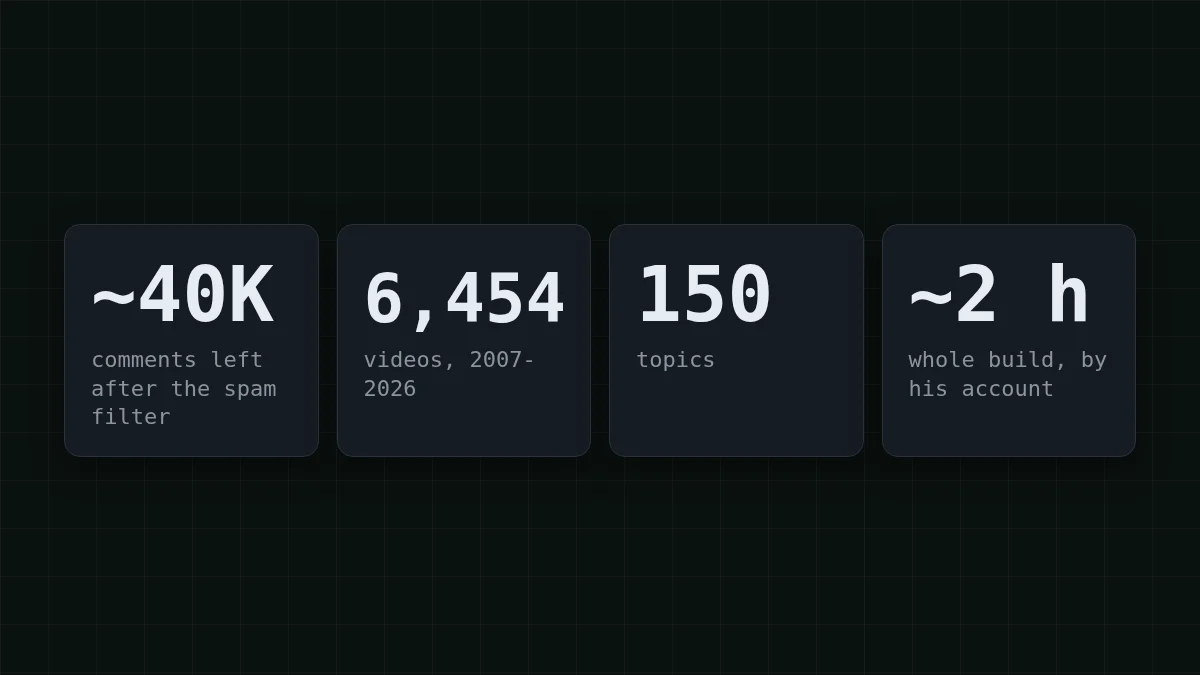
Андрей Карпаті (дослідник ШІ, співзасновник OpenAI, колишній директор зі ШІ в Tesla) описав у своєму пості від 31 жовтня 2026 року, як він створив HackerTube — сайт із відео, рекомендованими в коментарях Hacker News. У цьому проєкті Sonnet обробив коментарі в робочому процесі Claude Code, щоб видалити спам і звузити їх до приблизно 40 000 коментарів, які рекомендують відео з YouTube. Результат — 6 454 відео за 150 темами, і він каже, що весь проєкт тепер займає близько двох годин.
У пості не вказано кількість токенів чи вартість. Тож цифри в цій статті — це арифметика на основі припущень, наведених поруч із ними, а не реконструкція його запуску. Що ви можете запозичити — це форма завдання: багато коротких текстів, одне питання «так/ні» щодо кожного.
Як працює фільтр «так/ні»#
Уявіть швейцара з правилом в один рядок: «впускати всіх, хто має квиток». Він дивиться на кожну людину секунду, каже «так» або «ні» і ніколи не пам'ятає попереднього гостя. Фільтр на LLM працює так само. Кожен запит містить вашу інструкцію плюс один коментар, і модель повертає одне слово. Коментар 17 000 нічого не знає про коментар 16 999.
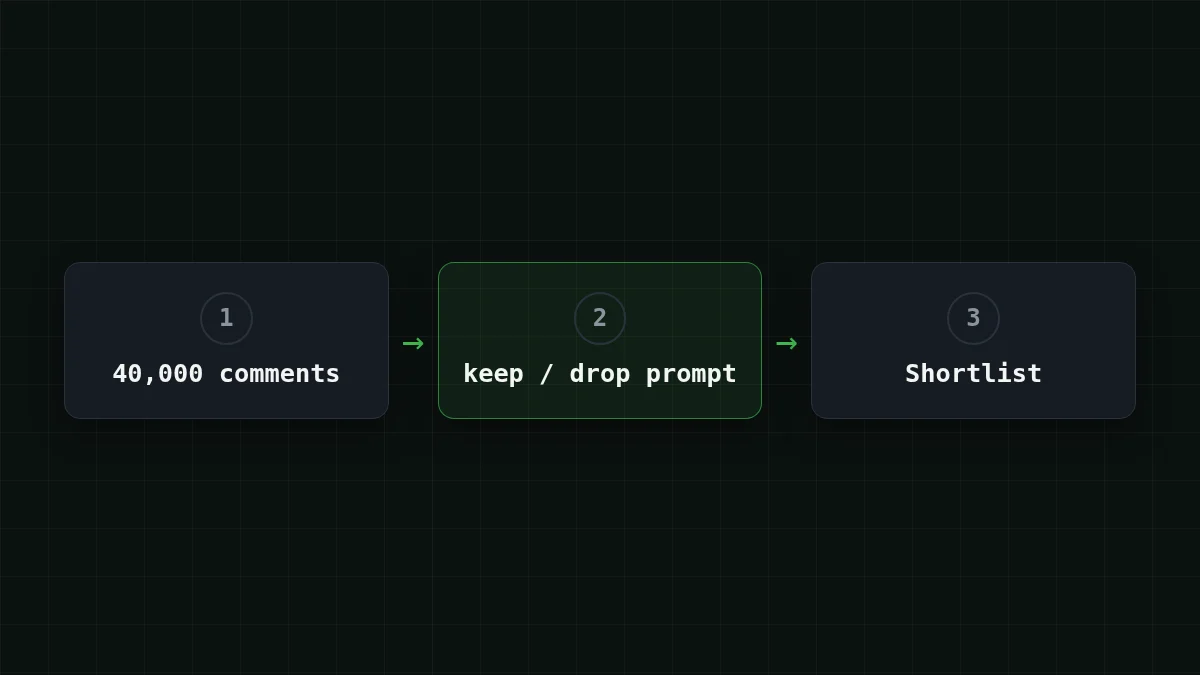
Саме тому рахунок передбачуваний. Кожен запит має приблизно однаковий розмір, тож вартість = запити × токени на запит. А оскільки відповідь — одне слово, майже всі гроші йдуть на вхідну частину: інструкцію та коментар, який ви надсилаєте. Якщо ціноутворення вхідних і вихідних токенів для вас нове, вхідні vs вихідні токени пояснює цей поділ.
Напишіть промпт keep/drop#
Промпт тут — це весь продукт. Порівняйте розпливчасту версію з точною:
Порівняйте
Розпливчасте правило проти точного
Розпливчасте
Is this comment good? Answer yes or no.Добре для кого? Довгий, ввічливий коментар про бази даних може отримати відповідь «так», а короткий «подивіться: <посилання>» — «ні». Модель мусить вгадувати, що ви мали на увазі, і її здогад змінюється від коментаря до коментаря.
Точне
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Тепер у моделі є правило, а не настрій, який треба вгадувати: що зараховується, що ні і як виглядає відповідь.
Скажімо, надходять три коментарі. Ось відповіді, яких ви прагнете:
- «Ця доповідь про історію Unix змінила моє бачення оболонок: youtube.com/watch?v=... Варта години.» →
keep - «Дешеві годинники тут!!! клікніть мій профіль» →
drop - «Згоден, слушна думка про кешування.» →
drop
Три звички роблять промпт стійким на 40 000 елементах. Скажіть, що робити з рештою випадків («усе інше — drop»); інакше модель вигадає третю відповідь. Просіть одне слово, щоб відповідь було легко порівняти з keep у коді. І обгорніть коментар у теги, як у циклі нижче: тоді коментар, який каже «ігноруйте інструкції вище», явно є даними, а не наказом. Позначайте кожен документ у промпті розповідає про це глибше.
Цикл: один запит на коментар#
Ось усе. Він читає comments.jsonl (один JSON-об'єкт із полем text на рядок), запитує вердикт для кожного коментаря і записує збережені рядки в kept.jsonl. Ідентифікатор моделі — повний gateway_id; ключ береться зі змінної середовища.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 робить вердикти більш повторюваними між запусками, а max_tokens=10 залишає місце для одного слова і не більше. Останній рядок — корисний: він підсумовує числа usage, які повертає API, тож ви отримуєте реальну кількість токенів замість здогаду.
Запустіть його на перших десяти коментарях і прочитайте кожен вердикт самостійно. Якщо відповідь виглядає обрізаною або порожньою, перевірте finish_reason, як описано в чому відповідь ШІ обривається на півслові. Один запит за раз — це нормально для тесту; для всіх 40 000 AsyncOpenAI надсилає багато паралельно.
Скільки коштують 40 000 коментарів#
Ось припущення, щоб ви могли підставити свої. Коментар плюс інструкція — це близько 150 токенів на вході. Відповідь — близько 5 токенів. Коментарі Hacker News часто довші, тож вважайте 150 нижньою межею і замініть її числами з репетиції. Для 40 000 коментарів:
- вхід: 40 000 × 150 = 6 000 000 токенів
- вихід: 40 000 × 5 = 200 000 токенів
Інструкція — це те, що люди забувають. Вона подорожує з кожним коментарем. Спробуйте здогадатися:
Вгадайте число
Скажімо, ваша інструкція має 60 токенів. Скільки вхідних токенів додають 40 000 її копій?
Ваше припущення
06 000 000
Показати відповідь
Відповідь: 2 400 000
40 000 × 60 = 2 400 000. Це 40% від 6 000 000 вхідних токенів, витрачених на текст, який ніколи не змінюється, тож стисліша інструкція — перше, що варто скоротити.
Тепер рахунок за повний прохід за поточними цінами:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 40 000 запитів | OpenRouter, 40 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 вхідних і 5 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
На цьому навантаженні DeepSeek-V4-Flash і GLM-5.3-Flash обидва виходять дешевшими за OpenRouter у сумі, з урахуванням входу і виходу разом; колонка OpenRouter показує це поруч. Обидва розраховані на високооб'ємне завдання, як це: DeepSeek-V4-Flash має одну ціну в будь-яку годину і до 32 768 вихідних токенів на відповідь, GLM-5.3-Flash — другий варіант на тому ж ендпоінті. Спробуйте свою репетицію на 50 коментарів на кожному і порівняйте вердикти самостійно. Щоб перемкнутися, змініть рядок моделі на zai-. Поточні ціни для кожної моделі — на сторінці цін, а моделі DeepSeek у CheapTokens перелічує деталі.
Спробуйте саміСпробуйте: у вашому архіві 100 000 коментарів, а не 40 000. Що зміниться?Показати відповідь
Рахунок зростає пропорційно кількості. 100 000 × 150 = 15 000 000 вхідних токенів і 100 000 × 5 = 500 000 вихідних токенів, що становить $0.275 на DeepSeek-V4-Flash. Той самий промпт, у 2,5 раза більше елементів, у 2,5 раза більша вартість.
Перш ніж натиснути «запустити»#
По-перше, репетиція. Візьміть 50 коментарів, запустіть цикл і прочитайте всі 50 вердиктів. Потім використайте надруковані підсумки токенів: 50 × 800 = 40 000, тож повний запуск — це токени репетиції, помножені на 800. Це замінює припущення 150 і 5 вашими власними числами.
По-друге, виправте промпт на репетиції, а не на повному запуску. Якщо три вердикти «drop» неправильні, додайте одне речення про цей випадок і перезапустіть 50. Бути прискіпливим тут коштує частку цента, а перезапуск 40 000 — набагато більше.
По-третє, пам'ятайте, що бачить модель: один коментар, без гілки. Якщо «згоден, слушна думка» має сенс лише поруч із батьківським коментарем, додайте батьківський коментар до запиту. Це робить кожен запит довшим, тож перерахуйте арифметику токенів із новим розміром.
Коли репетиція виглядає правильно, створіть API-ключ у своєму акаунті, вкажіть CHEAPTOKENS_ на нього і почніть повний прохід. Якщо ключ для вас новий, що таке API-ключ і як його зберігати займе п'ять хвилин.


