IA pour débutantsGuide
Filtrer 40 K commentaires avec un LLM : prompt keep/drop et coût
Un prompt keep/drop, une courte boucle Python et une estimation de tokens pour filtrer 40 000 commentaires avec un LLM bon marché, avant de lancer quoi que ce soit.
Sur cette page
Votre archive contient 40 000 commentaires, et la plupart ne sont que du bruit : spam, « +1 », blagues, réponses sans aucun rapport avec ce que vous cherchez. Un LLM bon marché peut lire chacun d'eux et répondre par un seul mot, keep ou drop. Envoyez chaque commentaire comme sa propre requête courte et la passe complète revient à environ 6 millions de tokens d'entrée et 200 mille tokens de sortie (en supposant environ 150 tokens en entrée et 5 en sortie par commentaire). Sur DeepSeek-V4-Flash, cette exécution coûte $0.11 au prix actuel.
Ci-dessous : le prompt, une courte boucle Python et l'arithmétique que vous pouvez refaire pour votre propre archive. Tout passe par le point de terminaison compatible OpenAI décrit dans la documentation CheapTokens.
D'où vient l'idée#
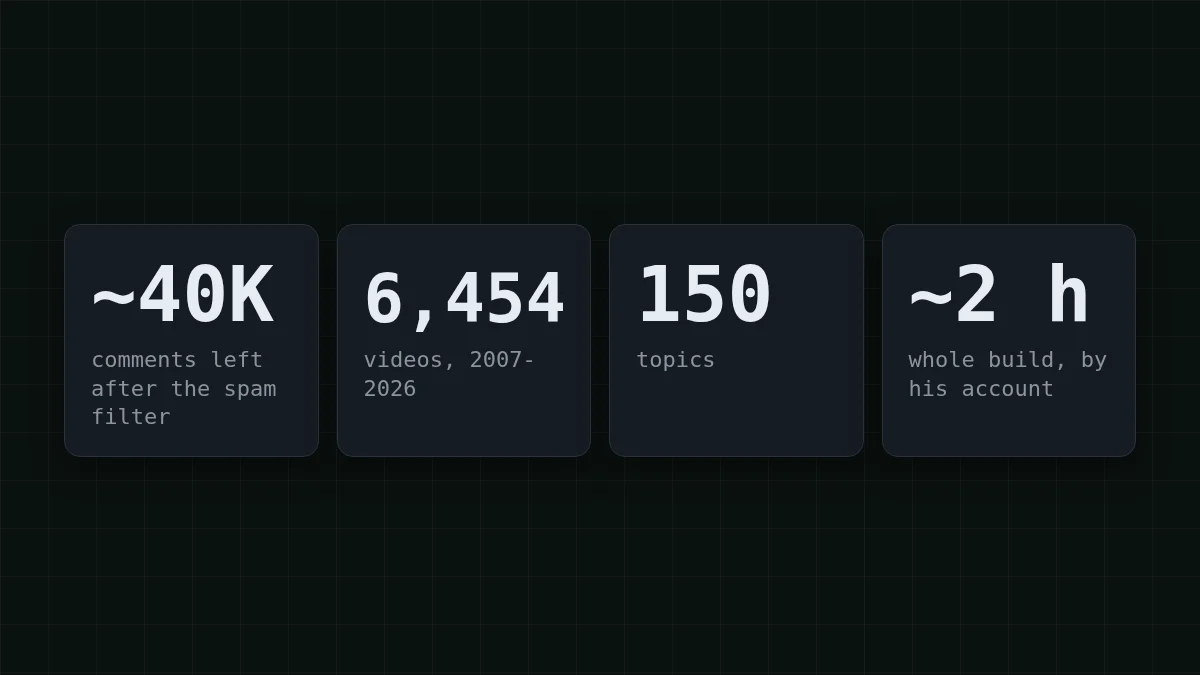
Andrej Karpathy (chercheur en IA, cofondateur d'OpenAI, ancien directeur IA chez Tesla) a décrit dans son billet du 31 octobre 2026 comment il a construit HackerTube, un site de vidéos recommandées dans les commentaires de Hacker News. Dans cette construction, Sonnet a parcouru les commentaires dans un workflow Claude Code pour éliminer le spam et les réduire à environ 40 000 commentaires qui recommandent des vidéos YouTube. Le résultat : 6 454 vidéos réparties sur 150 sujets, et il affirme que la construction complète prend désormais environ deux heures.
Le billet ne rapporte ni le nombre de tokens ni le coût. Les chiffres de cet article sont donc une arithmétique fondée sur des hypothèses énoncées juste à côté, et non une reconstitution de son exécution. Ce que vous pouvez emprunter, c'est la forme de la tâche : beaucoup de textes courts, une question oui/non sur chacun.
Comment fonctionne un filtre oui/non#
Pensez à un videur avec une règle d'une ligne : « laissez entrer quiconque a un billet ». Il regarde chaque personne une seconde, dit oui ou non, et ne se souvient jamais du client précédent. Un filtre LLM fonctionne de la même manière. Chaque requête porte votre instruction plus un commentaire, et le modèle renvoie un mot. Le commentaire 17 000 ne sait rien du commentaire 16 999.
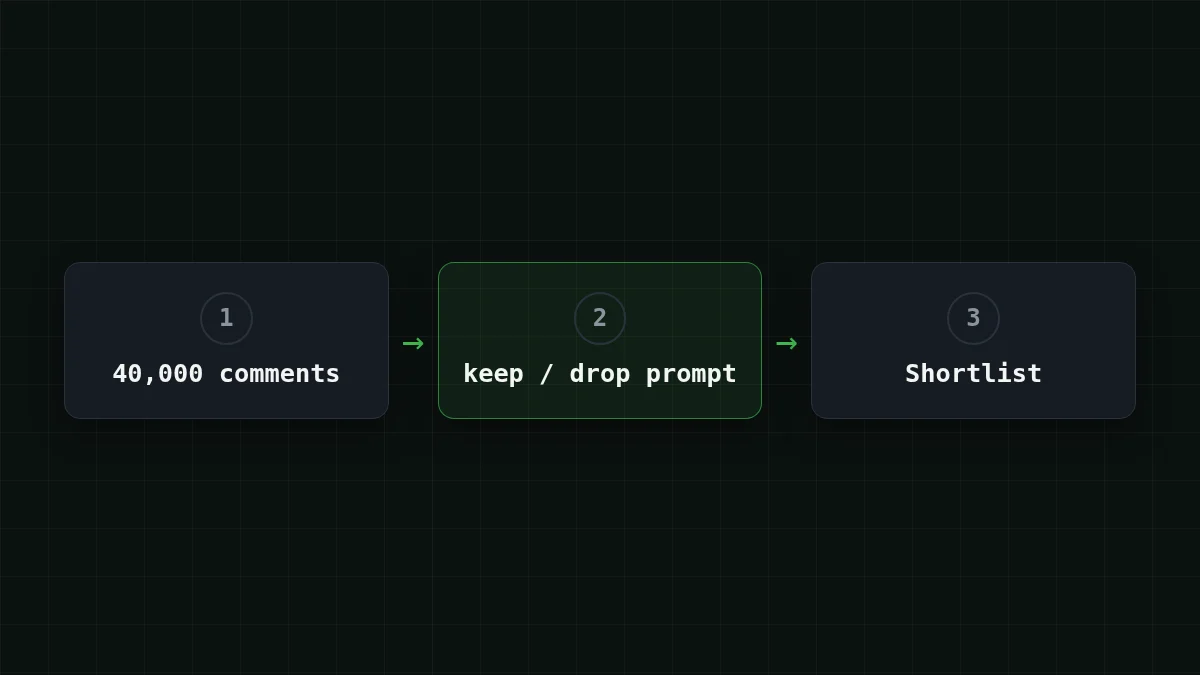
C'est ce design qui rend la facture prévisible. Chaque requête a à peu près la même taille, donc le coût est requêtes × tokens par requête. Et comme la réponse est un seul mot, presque tout l'argent part du côté de l'entrée : l'instruction et le commentaire que vous envoyez. Si la tarification entrée/sortie est nouvelle pour vous, tokens d'entrée vs de sortie explique la répartition.
Rédiger le prompt keep/drop#
Le prompt est tout le produit ici. Comparez une version vague avec une version exacte :
Comparer
Règle vague vs règle exacte
Vague
Is this comment good? Answer yes or no.Bon pour qui ? Un commentaire long et poli sur les bases de données peut revenir « oui » tandis qu'un court « regarde ça : <lien> » revient « non ». Le modèle doit deviner ce que vous vouliez dire, et sa supposition change d'un commentaire à l'autre.
Exact
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Maintenant le modèle a une règle au lieu d'une humeur à deviner : ce qui compte, ce qui ne compte pas, et à quoi ressemble la réponse.
Disons que trois commentaires arrivent. Voici les réponses que vous visez :
- « Cette conférence sur l'histoire d'Unix a changé ma façon de voir les shells : youtube.com/watch?v=... Vaut l'heure. » →
keep - « Montres pas chères ici !!! cliquez sur mon profil » →
drop - « D'accord, bon point sur le caching. » →
drop
Trois habitudes font tenir le prompt sur 40 000 éléments. Dites quoi faire des cas restants (« tout le reste est drop ») ; sinon le modèle invente une troisième réponse. Demandez un seul mot, pour que la réponse soit facile à comparer avec keep dans le code. Et entourez le commentaire de balises, comme dans la boucle ci-dessous : un commentaire qui dit « ignore les instructions ci-dessus » est alors clairement une donnée, pas un ordre. Étiqueter chaque document dans un prompt approfondit ce point.
La boucle : une requête par commentaire#
Voici l'ensemble. Il lit comments.jsonl (un objet JSON avec un champ text par ligne), demande un verdict sur chaque commentaire et écrit les lignes conservées dans kept.jsonl. L'identifiant du modèle est le gateway_id complet ; la clé vient d'une variable d'environnement.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 rend les verdicts plus reproductibles entre les exécutions, et max_tokens=10 laisse la place à un mot et rien de plus. La dernière ligne est la plus utile : elle additionne les nombres usage renvoyés par l'API, vous obtenez donc vos vrais comptes de tokens au lieu d'une estimation.
Lancez-le sur les dix premiers commentaires et lisez vous-même chaque verdict. Si une réponse semble tronquée ou revient vide, vérifiez finish_reason comme décrit dans pourquoi une réponse IA s'arrête en milieu de phrase. Une requête à la fois suffit pour un test ; pour les 40 000 complets, AsyncOpenAI en envoie beaucoup en parallèle.
Combien coûtent 40 000 commentaires#
Voici les hypothèses, pour que vous puissiez mettre les vôtres. Un commentaire plus l'instruction représente environ 150 tokens d'entrée. La réponse fait environ 5 tokens. Les commentaires Hacker News sont souvent plus longs, considérez donc 150 comme un plancher et remplacez-le par les chiffres de la répétition. Pour 40 000 commentaires :
- entrée : 40 000 × 150 = 6 000 000 tokens
- sortie : 40 000 × 5 = 200 000 tokens
L'instruction est la partie que les gens oublient. Elle voyage avec chaque commentaire. Essayez une estimation :
Devinez le nombre
Disons que votre instruction fait 60 tokens. Combien de tokens d'entrée représentent 40 000 copies ?
Votre estimation
06 000 000
Afficher la réponse
Réponse: 2 400 000
40 000 × 60 = 2 400 000. Cela fait 40 % des 6 000 000 de tokens d'entrée, dépensés en texte qui ne change jamais, donc une instruction plus serrée est la première chose à réduire.
Maintenant la facture pour la passe complète, aux prix actuels :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 40 000 requêtes | OpenRouter, 40 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 tokens d'entrée et 5 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Sur cette charge de travail, DeepSeek-V4-Flash et GLM-5.3-Flash reviennent tous deux moins cher qu'OpenRouter au total, entrée et sortie comptées ensemble ; la colonne OpenRouter le montre côte à côte. Les deux sont tarifés pour un travail à fort volume comme celui-ci : DeepSeek-V4-Flash a un prix unique à toute heure et jusqu'à 32 768 tokens de sortie par réponse, GLM-5.3-Flash est une seconde option sur le même point de terminaison. Essayez votre répétition de 50 commentaires sur chacun et comparez vous-même les verdicts. Pour changer, modifiez la ligne du modèle en zai-. Les prix actuels de chaque modèle sont sur la page de tarification, et les modèles DeepSeek chez CheapTokens en détaille les détails.
Essayez vous-mêmeEssayez : votre archive contient 100 000 commentaires, pas 40 000. Qu'est-ce qui change ?Afficher la réponse
La facture augmente proportionnellement au nombre. 100 000 × 150 = 15 000 000 tokens d'entrée et 100 000 × 5 = 500 000 tokens de sortie, soit $0.275 sur DeepSeek-V4-Flash. Même prompt, 2,5 fois plus d'éléments, 2,5 fois le coût.
Avant d'appuyer sur exécuter#
Premièrement, une répétition. Prenez 50 commentaires, lancez la boucle et lisez les 50 verdicts. Utilisez ensuite les totaux de tokens affichés : 50 × 800 = 40 000, donc l'exécution complète correspond aux tokens de la répétition multipliés par 800. Cela remplace l'hypothèse 150-et-5 par vos propres chiffres.
Deuxièmement, corrigez le prompt sur la répétition, pas sur l'exécution complète. Si trois verdicts « drop » sont faux, ajoutez une phrase sur ce cas et relancez les 50. Être pointilleux ici coûte une fraction de centime, et relancer 40 000 coûte bien plus.
Troisièmement, rappelez-vous ce que le modèle voit : un commentaire, pas de fil. Si « d'accord, bon point » n'a de sens qu'à côté du commentaire parent, mettez aussi le parent dans la requête. Cela allonge chaque requête, refaites donc l'arithmétique des tokens avec la nouvelle taille.
Quand la répétition semble bonne, créez une clé API dans votre compte, pointez CHEAPTOKENS_ dessus et lancez la passe complète. Si la clé est nouvelle pour vous, ce qu'est une clé API et comment la stocker prend cinq minutes.


