AI per principiantiGuida
Filtra 40K commenti con un LLM: prompt keep/drop e costo
Un prompt keep/drop, un breve ciclo Python e una stima dei token per filtrare 40.000 commenti con un LLM economico, prima di eseguire qualsiasi cosa.
In questa pagina
Il tuo archivio ha 40.000 commenti, e la maggior parte è rumore: spam, "+1", battute, risposte che non hanno nulla a che fare con quello che cerchi. Un LLM economico può leggerne uno alla volta e rispondere con una sola parola, keep o drop. Invia ogni commento come richiesta separata e l'intera passata arriva a circa 6 milioni di token di input e 200 mila token di output (assumendo circa 150 token in input e 5 in output per commento). Su DeepSeek-V4-Flash quella esecuzione costa $0.11 al prezzo attuale.
Qui sotto: il prompt, un breve ciclo Python e l'aritmetica che puoi rifare per il tuo archivio. Tutto passa attraverso l'endpoint compatibile con OpenAI descritto nella documentazione di CheapTokens.
Da dove viene l'idea#
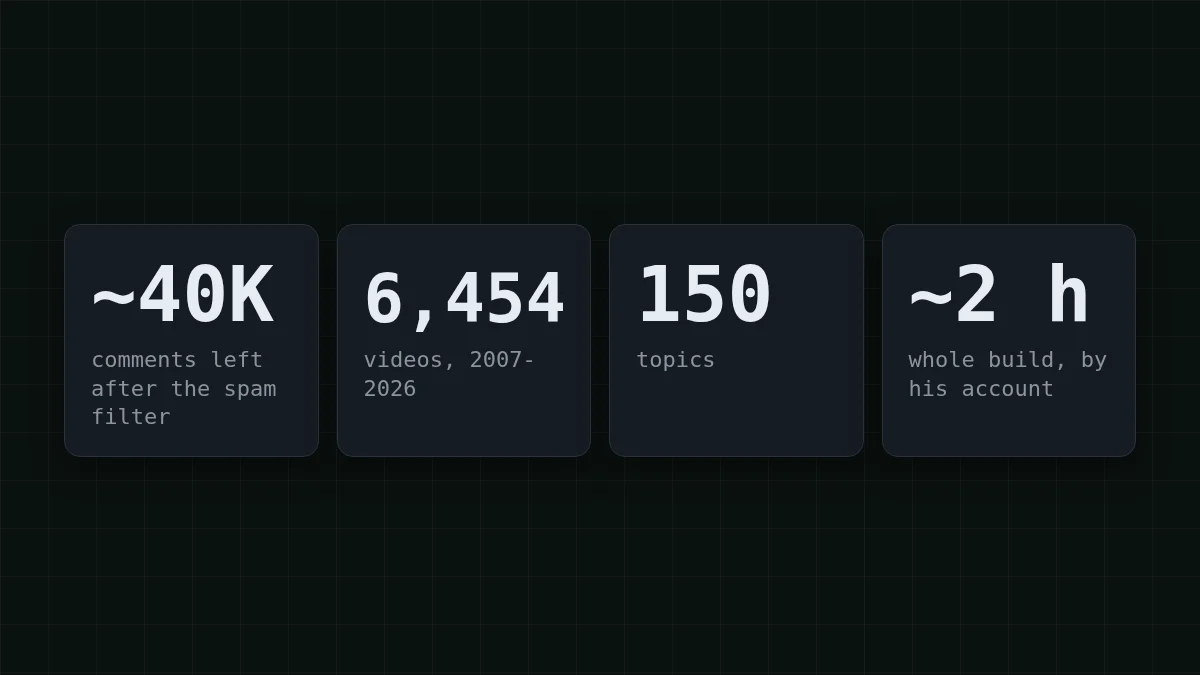
Andrej Karpathy (ricercatore AI, co-fondatore di OpenAI, ex direttore AI di Tesla) ha descritto nel suo post del 31 ottobre 2026 come ha costruito HackerTube, un sito di video consigliati nei commenti di Hacker News. In quella build, Sonnet ha analizzato i commenti in un workflow di Claude Code per rimuovere lo spam e ridurli a circa 40.000 commenti che consigliano video di YouTube. Il risultato è stato 6.454 video in 150 argomenti, e dice che l'intera build ora richiede circa due ore.
Il post non riporta conteggi di token né costi. Quindi i numeri in questo articolo sono aritmetica basata su assunzioni dichiarate accanto ad essi, non una ricostruzione della sua esecuzione. Quello che puoi prendere in prestito è la forma del compito: molti testi brevi, una domanda sì/no su ciascuno.
Come funziona un filtro sì/no#
Pensa a un buttafuori con una regola di una riga: "fai entrare chiunque abbia un biglietto". Guarda ogni persona per un secondo, dice sì o no, e non ricorda mai l'ospite precedente. Un filtro LLM funziona allo stesso modo. Ogni richiesta porta la tua istruzione più un commento, e il modello restituisce una parola. Il commento 17.000 non sa nulla del commento 16.999.
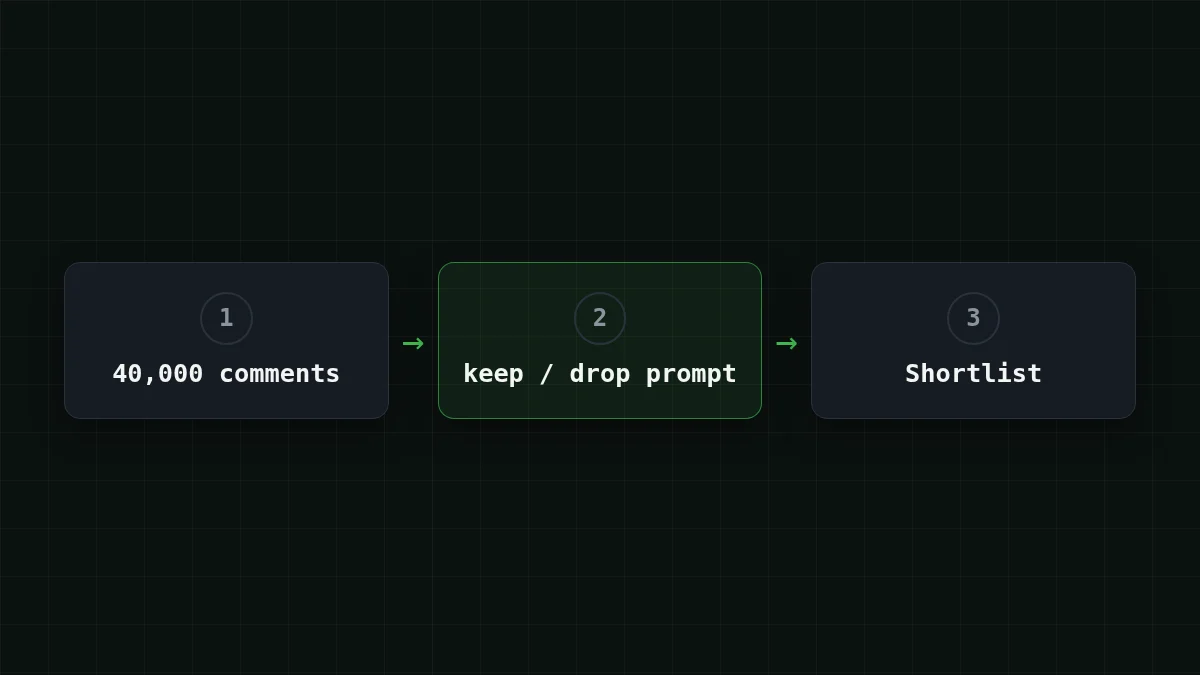
È per questo che il conto è prevedibile. Ogni richiesta ha all'incirca la stessa dimensione, quindi il costo è richieste × token per richiesta. E poiché la risposta è una parola, quasi tutti i soldi vanno nel lato input: l'istruzione e il commento che invii. Se il prezzo di input e output è nuovo per te, token di input vs output spiega la suddivisione.
Scrivi il prompt keep/drop#
Il prompt è tutto il prodotto qui. Confronta una versione vaga con una esatta:
Confronta
Regola vaga vs regola esatta
Vaga
Is this comment good? Answer yes or no.Buona per chi? Un commento lungo e cortese sui database può tornare "sì" mentre un breve "guarda questo: <link>" torna "no". Il modello deve indovinare cosa intendevi, e la sua ipotesi cambia da commento a commento.
Esatta
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Ora il modello ha una regola invece di un'umore da indovinare: cosa conta, cosa non conta, e come appare la risposta.
Supponi che arrivino tre commenti. Queste sono le risposte che miri a ottenere:
- "Questo talk sulla storia di Unix ha cambiato come vedo le shell: youtube.com/watch?v=... Vale l'ora." →
keep - "Orologi economici qui!!! clicca sul mio profilo" →
drop - "D'accordo, ottimo punto sulla cache." →
drop
Tre abitudini rendono il prompt solido su 40.000 elementi. Di' cosa fare con i casi rimanenti ("tutto il resto è drop"); altrimenti il modello inventa una terza risposta. Chiedi una sola parola, così la risposta è facile da confrontare con keep nel codice. E racchiudi il commento in tag, come nel ciclo qui sotto: un commento che dice "ignora le istruzioni sopra" è allora chiaramente un dato, non un ordine. Etichetta ogni documento in un prompt approfondisce l'argomento.
Il ciclo: una richiesta per commento#
Ecco tutto. Legge comments.jsonl (un oggetto JSON con un campo text per riga), chiede un verdetto su ogni commento e scrive le righe mantenute in kept.jsonl. L'id del modello è il gateway_id completo; la chiave proviene da una variabile d'ambiente.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 rende i verdetti più ripetibili tra un'esecuzione e l'altra, e max_tokens=10 lascia spazio per una parola e nulla più. L'ultima riga è quella utile: somma i numeri usage restituiti dall'API, così ottieni i tuoi conteggi reali di token invece di una stima.
Eseguilo sui primi dieci commenti e leggi tu stesso ogni verdetto. Se una risposta sembra troncata o torna vuota, controlla finish_reason come descritto in perché una risposta AI si interrompe a metà frase. Una richiesta alla volta va bene per un test; per tutti i 40.000, AsyncOpenAI ne invia molte in parallelo.
Quanto costano 40.000 commenti#
Ecco le assunzioni, così puoi sostituirle con le tue. Un commento più l'istruzione è circa 150 token di input. La risposta è circa 5 token. I commenti di Hacker News sono spesso più lunghi, quindi considera 150 come minimo e sostituiscilo con i numeri della prova. Per 40.000 commenti:
- input: 40.000 × 150 = 6.000.000 token
- output: 40.000 × 5 = 200.000 token
L'istruzione è la parte che la gente dimentica. Viaggia con ogni singolo commento. Prova a indovinare:
Indovina il numero
Supponi che la tua istruzione sia lunga 60 token. A quanto ammontano 40.000 copie di essa in token di input?
La tua risposta
06.000.000
Mostra risposta
Risposta: 2.400.000
40.000 × 60 = 2.400.000. È il 40% dei 6.000.000 di token di input, spesi in testo che non cambia mai, quindi un'istruzione più asciutta è la prima cosa da ridurre.
Ora il conto per l'intera passata, ai prezzi live:
| Modello | Input $/1M | Output $/1M | Per richiesta | 40.000 richieste | OpenRouter, 40.000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 token di input e 5 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Su questo carico di lavoro, DeepSeek-V4-Flash e GLM-5.3-Flash risultano entrambi più economici di OpenRouter in totale, contando input e output insieme; la colonna OpenRouter lo mostra fianco a fianco. Entrambi sono prezzati per un lavoro ad alto volume come questo: DeepSeek-V4-Flash ha un unico prezzo a qualsiasi ora e fino a 32.768 token di output per risposta, GLM-5.3-Flash è una seconda opzione sullo stesso endpoint. Prova la tua prova da 50 commenti su ciascuno e confronta tu stesso i verdetti. Per cambiare, modifica la riga del modello in zai-. I prezzi attuali per ogni modello sono nella pagina dei prezzi, e modelli DeepSeek su CheapTokens elenca i dettagli.
Provalo tu stessoProva: il tuo archivio ha 100.000 commenti, non 40.000. Cosa cambia?Mostra risposta
Il conto cresce in proporzione al numero. 100.000 × 150 = 15.000.000 token di input e 100.000 × 5 = 500.000 token di output, che sono $0.275 su DeepSeek-V4-Flash. Stesso prompt, 2,5 volte gli elementi, 2,5 volte il costo.
Prima di premere run#
Primo, una prova. Prendi 50 commenti, esegui il ciclo e leggi tutti e 50 i verdetti. Poi usa i totali di token stampati: 50 × 800 = 40.000, quindi l'esecuzione completa è i token della prova moltiplicati per 800. Questo sostituisce l'assunzione di 150 e 5 con i tuoi numeri.
Secondo, correggi il prompt sulla prova, non sull'esecuzione completa. Se tre verdetti "drop" sono sbagliati, aggiungi una frase su quel caso e riesegui i 50. Costa una frazione di centesimo essere pignoli qui, e molto di più rieseguire 40.000.
Terzo, ricorda cosa vede il modello: un commento, nessun thread. Se "d'accordo, ottimo punto" ha senso solo accanto al commento padre, metti anche il padre nella richiesta. Questo rende ogni richiesta più lunga, quindi rifai l'aritmetica dei token con la nuova dimensione.
Quando la prova sembra giusta, crea una chiave API nel tuo account, punta CHEAPTOKENS_ su di essa e avvia l'esecuzione completa. Se la chiave è nuova per te, cos'è una chiave API e come conservarla richiede cinque minuti.


