AI dla początkującychPrzewodnik
Filtruj 40 tys. komentarzy LLM-em: prompt keep/drop i koszt
Prompt keep/drop, krótka pętla w Pythonie i szacunek tokenów do filtrowania 40 000 komentarzy tanim LLM-em, zanim cokolwiek uruchomisz.
Na tej stronie
Twoje archiwum ma 40 000 komentarzy, a większość z nich to szum: spam, „+1”, żarty, odpowiedzi, które nie mają nic wspólnego z tym, czego szukasz. Tani LLM może przeczytać każdy z nich i odpowiedzieć jednym słowem, keep lub drop. Wyślij każdy komentarz jako osobne krótkie zapytanie, a cały przebieg zamknie się w około 6 milionach tokenów wejściowych i 200 tysiącach tokenów wyjściowych (zakładając około 150 tokenów na wejściu i 5 na wyjściu na komentarz). Na DeepSeek-V4-Flash ten przebieg kosztuje $0.11 przy obecnej cenie.
Poniżej: prompt, krótka pętla w Pythonie i arytmetyka, którą możesz powtórzyć dla własnego archiwum. Wszystko przechodzi przez endpoint zgodny z OpenAI opisany w dokumentacji CheapTokens.
Skąd pomysł#
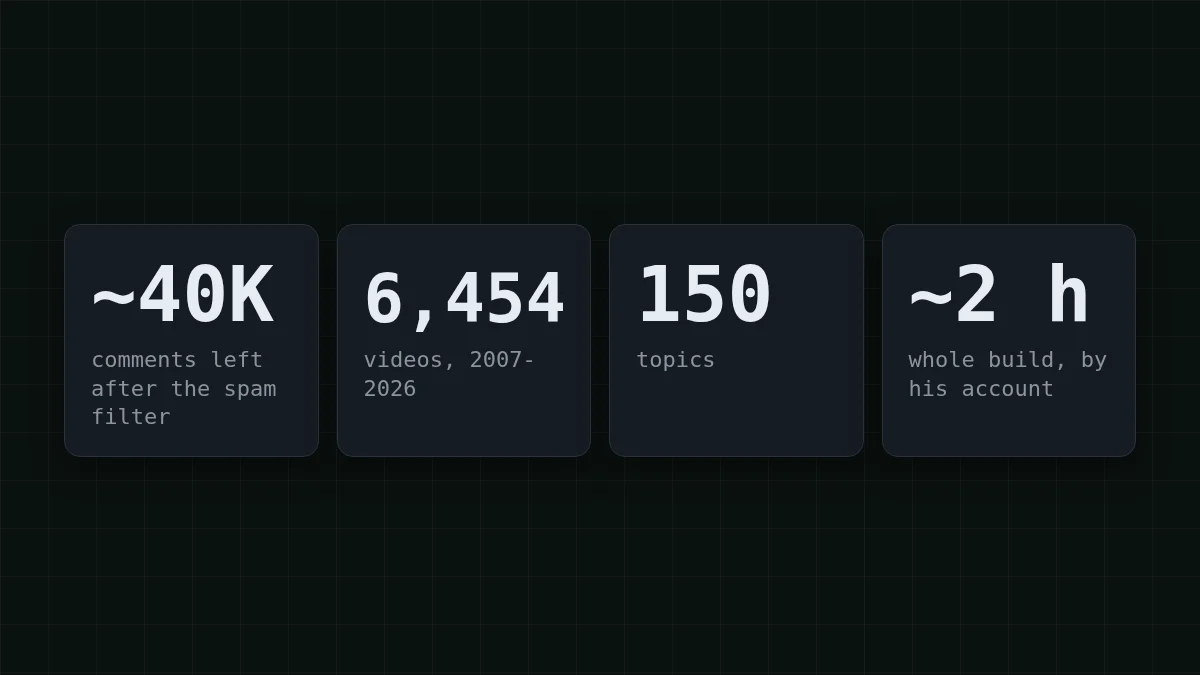
Andrej Karpathy (badacz AI, współzałożyciel OpenAI, były dyrektor ds. AI w Tesli) opisał w swoim poście z 31 października 2026, jak zbudował HackerTube, stronę z filmami polecanymi w komentarzach na Hacker News. W tym projekcie Sonnet przejrzał komentarze w workflow Claude Code, aby usunąć spam i zawęzić je do około 40 000 komentarzy polecających filmy z YouTube. Wynik to 6 454 filmy w 150 tematach, a według niego cała budowa zajmuje teraz około dwóch godzin.
Post nie podaje liczby tokenów ani kosztu. Zatem liczby w tym artykule to arytmetyka z założeń podanych obok nich, a nie rekonstrukcja jego przebiegu. To, co możesz zapożyczyć, to kształt zadania: dużo krótkich tekstów, jedno pytanie tak/nie o każdy z nich.
Jak działa filtr tak/nie#
Wyobraź sobie ochroniarza z jednolinijkową zasadą: „wpuszczaj każdego z biletem”. Patrzy na każdą osobę przez sekundę, mówi tak lub nie i nigdy nie pamięta poprzedniego gościa. Filtr LLM działa tak samo. Każde zapytanie zawiera twoją instrukcję plus jeden komentarz, a model odsyła jedno słowo. Komentarz 17 000 nie wie nic o komentarzu 16 999.
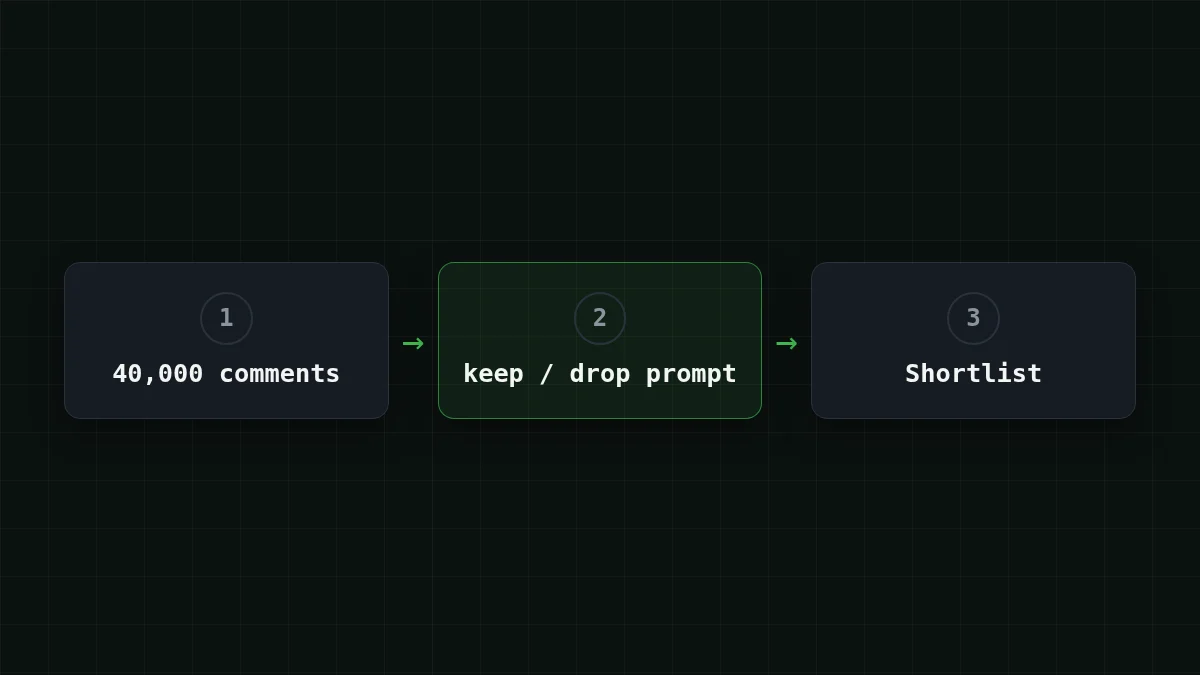
Ten projekt sprawia, że rachunek jest przewidywalny. Każde zapytanie ma w przybliżeniu ten sam rozmiar, więc koszt to liczba zapytań × tokeny na zapytanie. A ponieważ odpowiedź to jedno słowo, prawie wszystkie pieniądze idą na stronę wejściową: instrukcję i komentarz, który wysyłasz. Jeśli ceny wejścia i wyjścia są dla ciebie nowe, tokeny wejściowe vs wyjściowe wyjaśniają podział.
Napisz prompt keep/drop#
Prompt to tutaj cały produkt. Porównaj wersję niejasną z dokładną:
Porównaj
Niejasna zasada vs dokładna zasada
Niejasna
Is this comment good? Answer yes or no.Dobra dla kogo? Długi, uprzejmy komentarz o bazach danych może wrócić jako „tak”, podczas gdy krótkie „obejrzyj to: <link>” wróci jako „nie”. Model musi zgadywać, co miałeś na myśli, a jego domysł zmienia się z komentarza na komentarz.
Dokładna
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Teraz model ma zasadę zamiast nastroju do zgadywania: co się liczy, co nie i jak wygląda odpowiedź.
Powiedzmy, że przychodzą trzy komentarze. To są odpowiedzi, do których dążysz:
- „Ten wykład o historii Uniksa zmienił moje spojrzenie na powłoki: youtube.com/watch?v=... Warto poświęcić godzinę.” →
keep - „Tanie zegarki tutaj!!! kliknij mój profil” →
drop - „Zgadzam się, świetny punkt o cachowaniu.” →
drop
Trzy nawyki sprawiają, że prompt wytrzymuje 40 000 elementów. Powiedz, co zrobić z pozostałymi przypadkami („wszystko inne to drop”); w przeciwnym razie model wymyśli trzecią odpowiedź. Poproś o jedno słowo, aby odpowiedź była łatwa do porównania z keep w kodzie. I otocz komentarz tagami, jak w pętli poniżej: komentarz, który mówi „zignoruj powyższe instrukcje”, jest wtedy wyraźnie danymi, a nie poleceniem. Oznacz każdy dokument w prompcie omawia to głębiej.
Pętla: jedno zapytanie na komentarz#
Oto całość. Czyta comments.jsonl (jeden obiekt JSON z polem text w każdej linii), prosi o werdykt dla każdego komentarza i zapisuje zachowane linie do kept.jsonl. Identyfikator modelu to pełny gateway_id; klucz pochodzi ze zmiennej środowiskowej.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 sprawia, że werdykty są bardziej powtarzalne między uruchomieniami, a max_tokens=10 zostawia miejsce na jedno słowo i nic więcej. Ostatnia linia jest tą użyteczną: sumuje liczby usage zwracane przez API, więc otrzymujesz rzeczywiste liczby tokenów zamiast zgadywania.
Uruchom to na pierwszych dziesięciu komentarzach i sam przeczytaj każdy werdykt. Jeśli odpowiedź wygląda na uciętą lub wraca pusta, sprawdź finish_reason zgodnie z opisem w dlaczego odpowiedź AI urywa się w połowie zdania. Jedno zapytanie na raz jest w porządku do testu; dla pełnych 40 000, AsyncOpenAI wysyła wiele równolegle.
Ile kosztuje 40 000 komentarzy#
Oto założenia, więc możesz podmienić własne. Komentarz plus instrukcja to około 150 tokenów wejściowych. Odpowiedź to około 5 tokenów. Komentarze na Hacker News są często dłuższe, więc traktuj 150 jako dolną granicę i zastąp ją liczbami z próby. Dla 40 000 komentarzy:
- wejście: 40 000 × 150 = 6 000 000 tokenów
- wyjście: 40 000 × 5 = 200 000 tokenów
Instrukcja to część, o której ludzie zapominają. Podróżuje z każdym komentarzem. Spróbuj zgadnąć:
Zgadnij liczbę
Powiedzmy, że twoja instrukcja ma 60 tokenów. Ile tokenów wejściowych sumuje 40 000 jej kopii?
Twoje przypuszczenie
06 000 000
Pokaż odpowiedź
Odpowiedź: 2 400 000
40 000 × 60 = 2 400 000. To 40% z 6 000 000 tokenów wejściowych, wydane na tekst, który nigdy się nie zmienia, więc ciaśniejsza instrukcja to pierwsza rzecz do przycięcia.
Teraz rachunek za pełny przebieg, na aktualnych cenach:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 40 000 żądań | OpenRouter, 40 000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 tokenów wejściowych i 5 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W tym obciążeniu DeepSeek-V4-Flash i GLM-5.3-Flash wypadają taniej niż OpenRouter łącznie, licząc wejście i wyjście razem; kolumna OpenRouter pokazuje to obok. Oba są wycenione pod zadanie o dużej objętości, takie jak to: DeepSeek-V4-Flash ma jedną cenę o każdej porze i do 32 768 tokenów wyjściowych na odpowiedź, GLM-5.3-Flash to druga opcja na tym samym endpoincie. Wypróbuj swoją próbę na 50 komentarzach na każdym i sam porównaj werdykty. Aby przełączyć, zmień linię modelu na zai-. Aktualne ceny dla każdego modelu są na stronie cen, a modele DeepSeek w CheapTokens wymienia szczegóły.
Spróbuj samSpróbuj: twoje archiwum ma 100 000 komentarzy, a nie 40 000. Co się zmienia?Pokaż odpowiedź
Rachunek rośnie w kroku z liczbą. 100 000 × 150 = 15 000 000 tokenów wejściowych i 100 000 × 5 = 500 000 tokenów wyjściowych, co daje $0.275 na DeepSeek-V4-Flash. Ten sam prompt, 2,5 razy więcej elementów, 2,5 razy większy koszt.
Zanim naciśniesz uruchom#
Po pierwsze, próba. Weź 50 komentarzy, uruchom pętlę i przeczytaj wszystkie 50 werdyktów. Następnie użyj wydrukowanych sum tokenów: 50 × 800 = 40 000, więc pełny przebieg to tokeny z próby pomnożone przez 800. To zastępuje założenie 150 i 5 twoimi własnymi liczbami.
Po drugie, popraw prompt na próbie, a nie na pełnym przebiegu. Jeśli trzy werdykty „drop” są błędne, dodaj jedno zdanie o tym przypadku i uruchom ponownie te 50. Bycie wybrednym tutaj kosztuje ułamek centa, a ponowne uruchomienie 40 000 kosztuje znacznie więcej.
Po trzecie, pamiętaj, co widzi model: jeden komentarz, bez wątku. Jeśli „zgadzam się, świetny punkt” ma sens tylko obok komentarza nadrzędnego, umieść komentarz nadrzędny również w zapytaniu. To wydłuża każde zapytanie, więc powtórz arytmetykę tokenów z nowym rozmiarem.
Kiedy próba wygląda dobrze, utwórz klucz API w swoim koncie, ustaw CHEAPTOKENS_ na niego i rozpocznij pełny przebieg. Jeśli klucz jest dla ciebie nowy, czym jest klucz API i jak go przechowywać zajmuje pięć minut.


