KI für EinsteigerAnleitung
40K Kommentare mit einem LLM filtern: Keep/Drop-Prompt und Kosten
Ein Keep/Drop-Prompt, eine kurze Python-Schleife und eine Token-Schätzung zum Filtern von 40.000 Kommentaren mit einem günstigen LLM, bevor du irgendetwas startest.
Auf dieser Seite
Dein Archiv hat 40.000 Kommentare, und die meisten davon sind Rauschen: Spam, „+1“, Witze, Antworten, die nichts mit dem zu tun haben, wonach du suchst. Ein günstiges LLM kann jeden einzelnen lesen und mit einem einzigen Wort antworten, keep oder drop. Schick jeden Kommentar als eigene kurze Anfrage, und der ganze Durchlauf kommt auf etwa 6 Millionen Input-Tokens und 200 Tausend Output-Tokens (bei grob 150 Tokens rein und 5 raus pro Kommentar). Auf DeepSeek-V4-Flash kostet dieser Lauf $0.11 zum aktuellen Preis.
Unten: der Prompt, eine kurze Python-Schleife und die Arithmetik, die du für dein eigenes Archiv nachrechnen kannst. Alles läuft über den OpenAI-kompatiblen Endpoint, der in der CheapTokens-Doku beschrieben ist.
Woher die Idee kommt#
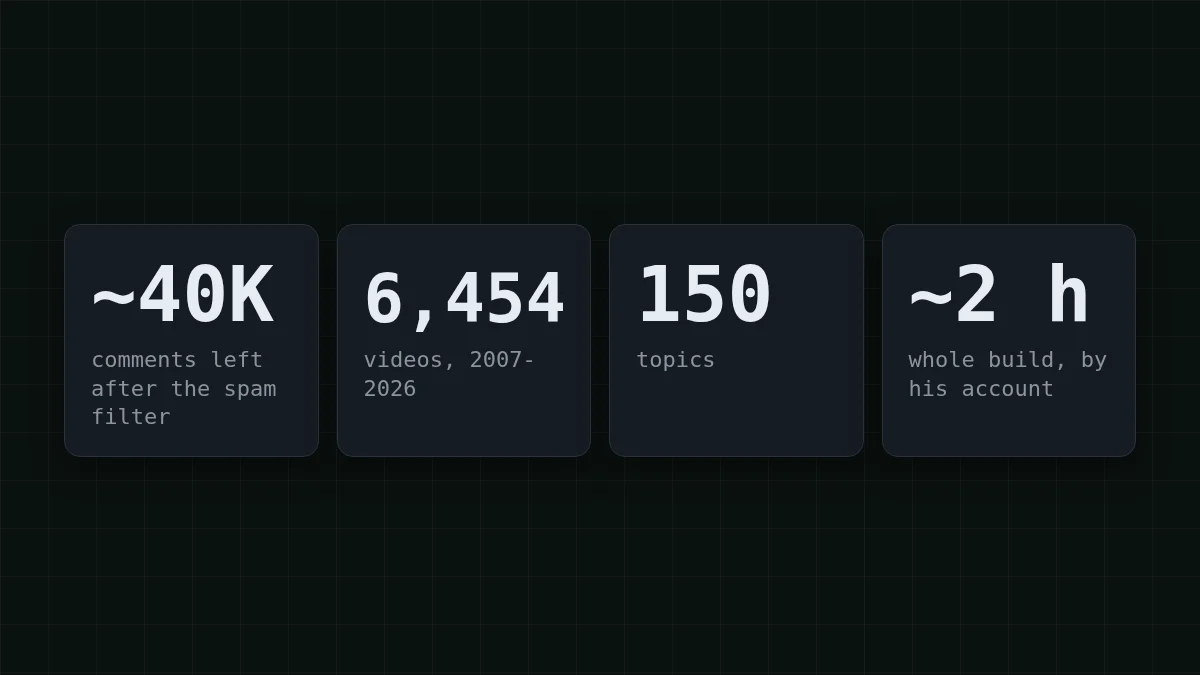
Andrej Karpathy (KI-Forscher, OpenAI-Mitgründer, ehemaliger KI-Direktor bei Tesla) beschrieb in seinem Beitrag vom 31. Oktober 2026, wie er HackerTube gebaut hat, eine Seite mit Videos, die in Hacker-News-Kommentaren empfohlen werden. In diesem Build ließ er Sonnet in einem Claude-Code-Workflow über die Kommentare laufen, um Spam zu entfernen und sie auf etwa 40.000 Kommentare einzugrenzen, die YouTube-Videos empfehlen. Das Ergebnis waren 6.454 Videos zu 150 Themen, und er sagt, der ganze Build dauere inzwischen etwa zwei Stunden.
Der Beitrag nennt keine Token-Zahlen oder Kosten. Die Zahlen in diesem Artikel sind also Arithmetik aus Annahmen, die direkt daneben stehen, keine Rekonstruktion seines Laufs. Was du übernehmen kannst, ist die Form der Aufgabe: viele kurze Texte, eine Ja/Nein-Frage zu jedem.
Wie ein Ja/Nein-Filter funktioniert#
Stell dir einen Türsteher mit einer Ein-Satz-Regel vor: „Lass jeden rein, der ein Ticket hat“. Er schaut sich jede Person eine Sekunde an, sagt ja oder nein und erinnert sich nie an den vorherigen Gast. Ein LLM-Filter funktioniert genauso. Jede Anfrage trägt deine Anweisung plus einen Kommentar, und das Modell schickt ein Wort zurück. Kommentar 17.000 weiß nichts von Kommentar 16.999.
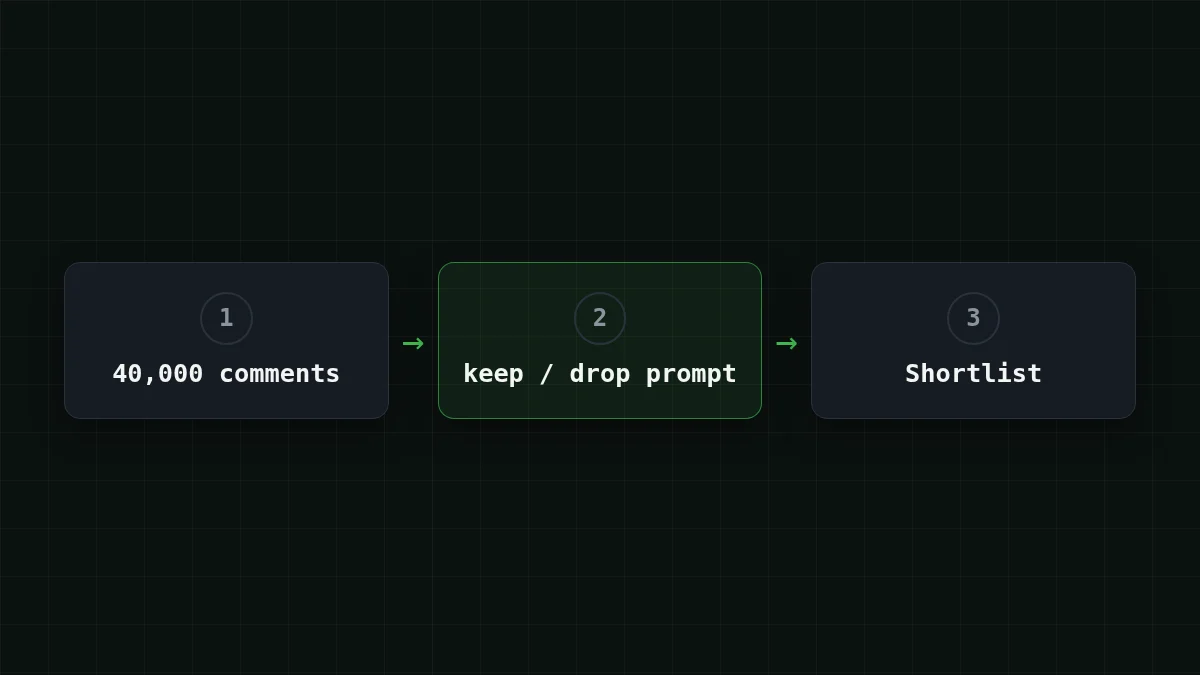
Dieses Design ist der Grund, warum die Rechnung vorhersehbar ist. Jede Anfrage hat ungefähr dieselbe Größe, also ist der Preis Anfragen × Tokens pro Anfrage. Und weil die Antwort ein Wort ist, geht fast das ganze Geld in die Input-Seite: die Anweisung und den Kommentar, den du schickst. Wenn Input- und Output-Preise neu für dich sind, erklärt Input vs Output Tokens die Aufteilung.
Schreib den Keep/Drop-Prompt#
Der Prompt ist hier das ganze Produkt. Vergleiche eine vage Version mit einer exakten:
Vergleichen
Vage Regel vs exakte Regel
Vage
Is this comment good? Answer yes or no.Gut für wen? Ein langer, höflicher Kommentar über Datenbanken kann „yes“ zurückgeben, während ein kurzes „watch this: <link>“ „no“ zurückgibt. Das Modell muss raten, was du gemeint hast, und seine Vermutung ändert sich von Kommentar zu Kommentar.
Exakt
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Jetzt hat das Modell eine Regel statt einer Stimmung zum Raten: was zählt, was nicht, und wie die Antwort aussieht.
Sagen wir, drei Kommentare kommen an. Das sind die Antworten, auf die du abzielst:
- „This talk on the history of Unix changed how I see shells: youtube.com/watch?v=... Worth the hour.“ →
keep - „Cheap watches here!!! click my profile“ →
drop - „Agree, great point about caching.“ →
drop
Drei Gewohnheiten sorgen dafür, dass der Prompt über 40.000 Einträge hinweg hält. Sag, was mit den Restfällen passieren soll („everything else is drop“); sonst erfindet das Modell eine dritte Antwort. Frag nach einem Wort, damit die Antwort im Code leicht mit keep verglichen werden kann. Und pack den Kommentar in Tags, wie in der Schleife unten: ein Kommentar, der sagt „ignore the instructions above“, ist dann eindeutig Daten, kein Befehl. Label every document in a prompt geht tiefer darauf ein.
Die Schleife: eine Anfrage pro Kommentar#
Hier ist das Ganze. Es liest comments.jsonl (ein JSON-Objekt mit einem text-Feld pro Zeile), fragt für jeden Kommentar ein Urteil ab und schreibt die behaltenen Zeilen nach kept.jsonl. Die Modell-ID ist die vollständige gateway_id; der Key kommt aus einer Umgebungsvariable.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 macht die Urteile zwischen Läufen wiederholbarer, und max_tokens=10 lässt Platz für ein Wort und nichts weiter. Die letzte Zeile ist die nützliche: Sie summiert die usage-Zahlen, die die API zurückgibt, sodass du deine echten Token-Zahlen bekommst statt einer Schätzung.
Lass es auf den ersten zehn Kommentaren laufen und lies jedes Urteil selbst. Wenn eine Antwort abgeschnitten aussieht oder leer zurückkommt, prüfe finish_reason wie in why an AI answer stops mid-sentence beschrieben. Eine Anfrage nach der anderen ist für einen Test in Ordnung; für die vollen 40.000 sendet AsyncOpenAI viele parallel.
Was 40.000 Kommentare kosten#
Hier sind die Annahmen, damit du deine eigenen einsetzen kannst. Ein Kommentar plus die Anweisung sind etwa 150 Input-Tokens. Die Antwort sind etwa 5 Tokens. Hacker-News-Kommentare sind oft länger, also behandle 150 als Untergrenze und ersetze sie durch die Zahlen aus der Probe. Für 40.000 Kommentare:
- Input: 40.000 × 150 = 6.000.000 Tokens
- Output: 40.000 × 5 = 200.000 Tokens
Die Anweisung ist der Teil, den Leute vergessen. Sie reist mit jedem einzelnen Kommentar mit. Probier eine Schätzung:
Zahl erraten
Sag, deine Anweisung ist 60 Tokens lang. Wie viele Input-Tokens ergeben 40.000 Kopien davon?
Deine Schätzung
06.000.000
Antwort anzeigen
Antwort: 2.400.000
40.000 × 60 = 2.400.000. Das sind 40 % der 6.000.000 Input-Tokens, ausgegeben für Text, der sich nie ändert, also ist eine straffere Anweisung das Erste, was du kürzen solltest.
Jetzt die Rechnung für den ganzen Durchlauf, zu Live-Preisen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 40.000 Anfragen | OpenRouter, 40.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 Input- und 5 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Bei dieser Arbeitslast kommen DeepSeek-V4-Flash und GLM-5.3-Flash in Summe beide günstiger als OpenRouter, wenn man Input und Output zusammenzählt; die OpenRouter-Spalte zeigt es daneben. Beide sind für einen Job mit hohem Volumen wie diesen bepreist: DeepSeek-V4-Flash hat zu jeder Stunde einen Preis und bis zu 32.768 Output-Tokens pro Antwort, GLM-5.3-Flash ist eine zweite Option am selben Endpoint. Probier deine 50-Kommentar-Probe mit jedem aus und vergleiche die Urteile selbst. Zum Wechseln änderst du die Modellzeile auf zai-. Aktuelle Preise für jedes Modell stehen auf der Preisseite, und DeepSeek models at CheapTokens listet die Details.
Probier es selbstProbier es: Dein Archiv hat 100.000 Kommentare, nicht 40.000. Was ändert sich?Antwort anzeigen
Die Rechnung wächst im Gleichschritt mit der Anzahl. 100.000 × 150 = 15.000.000 Input-Tokens und 100.000 × 5 = 500.000 Output-Tokens, das sind $0.275 auf DeepSeek-V4-Flash. Gleicher Prompt, 2,5-mal so viele Einträge, 2,5-mal die Kosten.
Bevor du auf Start drückst#
Erstens, eine Probe. Nimm 50 Kommentare, lass die Schleife laufen und lies alle 50 Urteile. Dann nutze die ausgegebenen Token-Summen: 50 × 800 = 40.000, also ist der volle Lauf die Tokens der Probe mal 800. Das ersetzt die Annahme von 150 und 5 durch deine eigenen Zahlen.
Zweitens, fixiere den Prompt anhand der Probe, nicht am vollen Lauf. Wenn drei „drop“-Urteile falsch sind, füge einen Satz zu diesem Fall hinzu und lass die 50 erneut laufen. Hier wählerisch zu sein kostet einen Bruchteil eines Cents, und 40.000 erneut laufen zu lassen deutlich mehr.
Drittens, denk daran, was das Modell sieht: einen Kommentar, keinen Thread. Wenn „agree, great point“ nur neben dem Elternkommentar Sinn ergibt, pack den Elternkommentar ebenfalls in die Anfrage. Das macht jede Anfrage länger, also rechne die Token-Arithmetik mit der neuen Größe neu.
Wenn die Probe gut aussieht, erstelle einen API-Key in deinem Konto, richte CHEAPTOKENS_ darauf aus und starte den vollen Durchlauf. Wenn der Key neu für dich ist, dauert what an API key is and how to store it fünf Minuten.


