AI入門ガイド
100万トークンあたりの価格 vs タスクあたりのコスト: AIモデルの比較方法
100万トークンあたりの価格が低いモデルでも、完了したタスクあたりではより高くつくことがあります。入力トークン、出力トークン、試行回数からタスクあたりのコストを計算する方法を学びましょう。
モデルを比較するときは、100万トークンあたりの価格ではなく、タスクを1つ完了させるのにいくらかかるかで見てください。タスクのコストは、入力トークン数 × 入力価格 + 出力トークン数 × 出力価格に、試行回数を掛けたものです。つまり、トークン単価が半分のモデルでも、請求額が大きくなることがあります。
よくある驚きはこれです。エージェントは完了した、価格表は安く見えた、それなのに請求額はタスクに見合わないほど大きい。その差がどこに隠れているのか見ていきましょう。
トークン単価はキロあたりの値段#
小麦粉のキロあたりの値段だけでは、夕食のコストはわかりません。レシピに何キロ必要か、最初の一皿を焦がして作り直すかどうかを知る必要があります。
AIモデルも同じです。100万トークンあたりの価格はキロあたりの値段です。タスクは夕食です。リクエストはすべて2つの側面で課金されます。送信するトークン(入力)と、モデルが書き戻すトークン(出力)です。どちらの数値も、https:/ の CheapTokens API のような OpenAI 互換 API のすべてのレスポンスの usage フィールドで返される(2026年10月29日時点で確認)ので、推測する必要はありません。
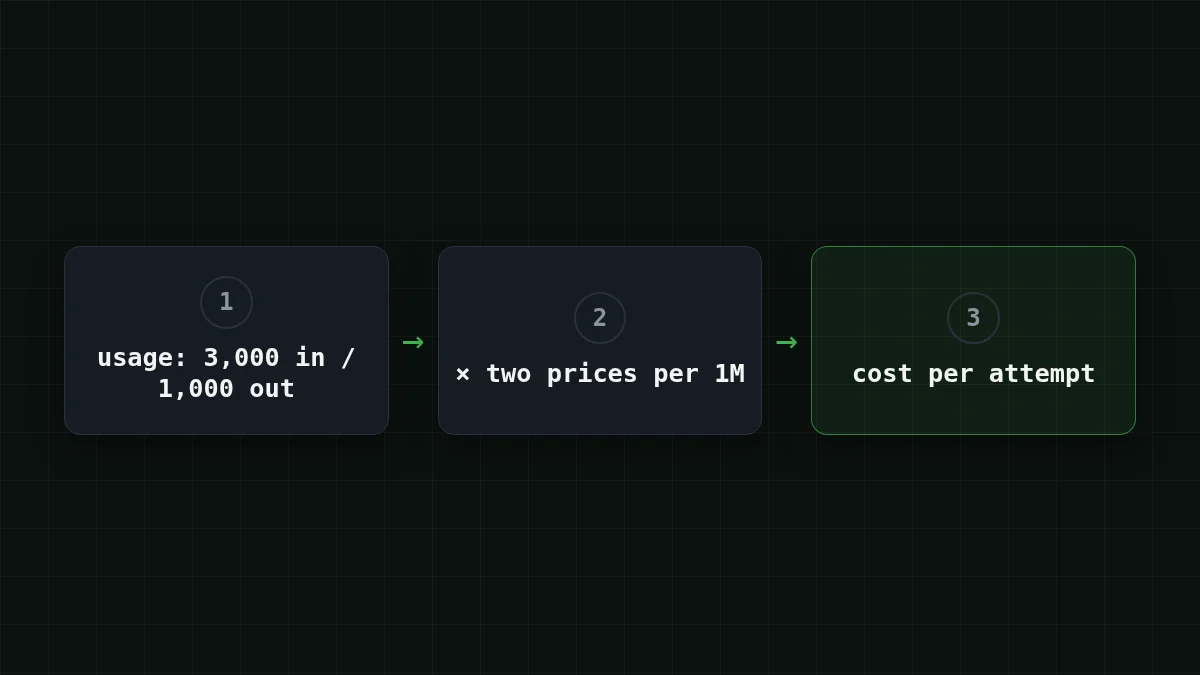
式はこれだけです。
cost per task = attempts × (tokens in × input price + tokens out × output price)あるタスクが3,000トークンを送信し、1,000トークンを受け取るとします。モデルAは入力が100万トークンあたり$1、出力が$5です。モデルBはその半分で、$0.50と$2.50です。(これらは計算用の架空の丸い価格であり、誰かの価格表ではありません。)
モデルA、1回の試行:
- 3,000 × $1 ÷ 1,000,000 = 入力に$0.003
- 1,000 × $5 ÷ 1,000,000 = 出力に$0.005
- $0.003 + $0.005 = タスクあたり$0.008
モデルBはお買い得に見えます。しかし、使える結果を得るのに3回の試行が必要で、毎回同じコストがかかるとします。
- 3,000 × $0.50 ÷ 1,000,000 = 入力に$0.0015
- 1,000 × $2.50 ÷ 1,000,000 = 出力に$0.0025
- $0.0015 + $0.0025 = 試行あたり$0.004
- 3 × $0.004 = タスクあたり$0.012
トークン単価は半分なのに、タスクあたりの価格は1.5倍です。リトライがなくても、Bが単に長い回答を書くなら同じことが起こります。1回の試行で3,000出力トークンなら、3,000 × $2.50 ÷ 1,000,000 = $0.0075、$0.0015 + $0.0075 = $0.009です。それでもAの$0.008より高いです。
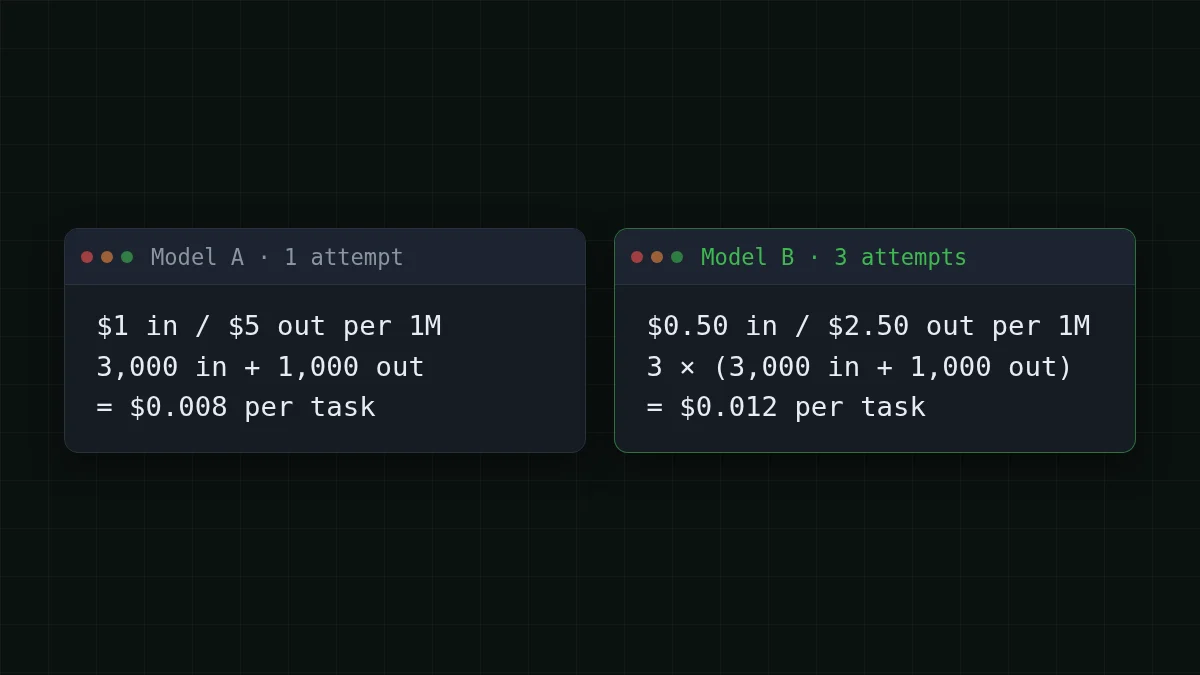
逆もまた然りです。Bが一発で正解すれば、タスクあたり$0.004で、Aの半分です。トークン単価が勝つのは、トークン数と試行回数がほぼ同じときだけです。まさにそこを確認すべきなのです。
フラッシュカード
どのAPIドキュメントでも出会う言葉
カードをタップしてめくる
タスクあたりのトークンは実際どこへ行くのか#
トークン数を動かす要因は3つあり、どれも価格表には現れません。
- 回答の長さ。 長々と説明するモデルは、1行で答えるモデルより多くの出力トークンを書きます。
- リトライ。 失敗した、または使えない回答にもトークンがかかり、次の試行でまた支払います。
- 再送されるコンテキスト。 APIは記憶しません。エージェントの各ステップが指示、ファイル、履歴を再送します。これが初めてなら、長いチャットが高くつく理由で仕組みを説明しています。
3つ目がエージェントにとって最大の要因です。20ステップで動くコーディングエージェントを考えます。重いエージェントステップとして、入力20,000トークン、出力1,000トークンを想定します。実際のステップごとの数値を使った軽い実行については、AIエージェントがなぜそんなに多くのトークンを使うのかをご覧ください。回答は短い。入力は短くありません。
数字を当てる
各ステップが20,000トークンを送信する場合、20ステップのエージェントは合計で何入力トークンを送信するか?
あなたの予想
01,000,000
答えを表示
答え: 400,000
20 × 20,000 = 400,000。各ステップがコンテキストを再送するので、各回答が短くても入力は積み上がる。
つまりこの作業では入力側が請求額を決め、出力側はほとんど関係ありません。入力価格が安いモデルは、出力価格が普通に見えてもここで勝てます。それは、自分のタスクを念頭に置いて読んで初めて価格表からわかることです。
これがまさにその作業です。20ステップ、入力20,000、出力1,000を、CheapTokensで利用可能なモデルで実行します。表はライブなので、数値は現在の価格に従い、OpenRouter列は比較用にあります。入力と出力を合計すると、3つとも合計でOpenRouterより安くなります。
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 20 リクエスト | OpenRouter、20 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
リクエストあたり 20,000 入力トークンと 1,000 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
このようなエージェントループには、DeepSeek-V4-Flashが自然に合います。380Kコンテキスト、回答あたり最大32,768出力トークン、そして時間帯を問わず1つの価格なので、夜間の実行も日中と同じコストです。これで20ステップ全体の作業は$0.008になります。詳細はモデルページ、すべてのモデルは価格表をご覧ください。
チャットボットは逆の話#
次にサポートボットを考えます。1日1,000リクエストで、各リクエストはコンテキスト込みの2,000トークンの質問と500トークンの回答だとします。ループなし、成長する履歴なし、1回の試行です。
ここではトークン単価がほぼタスクあたりのコストです。なぜなら何もそれを掛け算しないからです。GLM-5.3-Flashでは、390Kコンテキスト、回答あたり最大8,192出力トークンで、1リクエストのコストは$0.00006、1日1,000リクエスト全体では$0.06です。
経験則は単純です。短い単発のタスクなら、トークン単価は妥当な目安です。ループ、リトライしがちな作業、長い回答の作業なら、選ぶ前にタスク全体の価格を計算してください。
自分のタスクを10分で測定する#
自分の数値は、ここにあるどんな例よりも勝ります。以下のスクリプトは1つのリクエストを送信し、実際に使用した量とそのコストを出力します。スクリプト内の価格は例です。価格表から現在の価格に置き換えてください。
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
うまく動けば、1行に3つの数値が得られます。入力トークン、出力トークン、その試行のコストです。次に:
- おもちゃではなく、自分の実際のタスクを20個実行します。
- 捨てた試行も含め、すべての試行のコストを合計します。
- 20で割ります。それがタスクあたりのコストです。
- 別のモデルで繰り返し、2つの結果を比較します。
より長い実行には、Pythonでエージェントのトークンコストを追跡するが同じ考え方に予算と停止を追加し、リクエストが使うトークン数が出発点となる典型的なサイズを示します。
クイックチェック#
クイックチェック
モデルBのトークンあたりのコストはモデルAの半分です。Bが完了したタスクあたりでより高くつくのはどんなときか?
答えを表示
答え: より多くの試行が必要なとき、またははるかに長い回答を書くとき
タスクあたりのコスト = 試行回数 × トークン数 × 価格。価格を半分にして試行回数を3倍にすると、1.5倍支払うことになる。
次に、入力トークンと出力トークンが2つの側面で価格が異なる理由を説明し、ドキュメントがキーから最初のリクエストまで導きます。


