400 após uma chamada de ferramenta: reenvie reasoning_content
Por que a segunda requisição de um loop de chamada de ferramenta retorna 400 em um modelo de raciocínio, uma correção em Python que anexa a mensagem inteira e quando você pode pular isso.
Nesta página
Seu loop de agente funciona na primeira requisição e falha na segunda com um 400. Em um modelo de raciocínio, uma causa documentada é um campo ausente: a mensagem do assistente que você envia de volta perdeu seu reasoning_. Se essa for a causa, anexar a mensagem inteira exatamente como a API a retornou resolve o problema.
O guia do modo de raciocínio do DeepSeek (docs, verificado em 8 de novembro de 2026) resume a regra em uma frase: quando a requisição tem o parâmetro tools, reasoning_ precisa ser reenviado por completo em todas as requisições seguintes, incluindo turnos sem chamada de ferramenta. Caso contrário, a API retorna 400. A mesma página diz que o raciocínio vem ativado por padrão, com esforço high. Então um loop que você escreveu para um modelo sem raciocínio pode quebrar sem que uma única linha mude.
O que acontece entre a primeira e a segunda requisição#
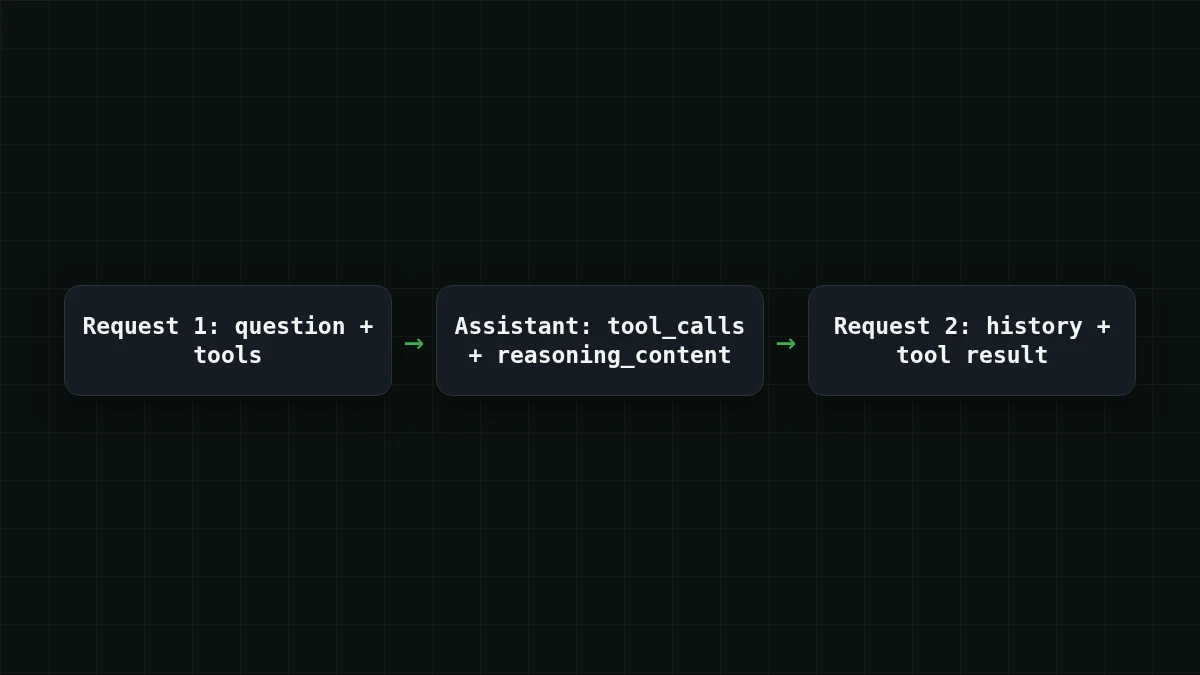
No modo de raciocínio, a cadeia de pensamento volta em reasoning_, um campo no mesmo nível de content. Imagine o loop:
- Você envia a pergunta e a lista
tools. - O modelo responde com
tool_calls(ereasoning_ao lado deles).content - Você executa a ferramenta e envia tudo de volta: o histórico, a mensagem do assistente e uma mensagem
toolcom o resultado.
O 400 aparece na requisição do passo 3 se a mensagem do assistente nela não tiver reasoning_.
A página do DeepSeek documenta o 400 apenas para este caso de chamada de ferramenta e não cita um texto de erro, então observe o status HTTP, não uma mensagem específica, ao verificar se você tem esse problema.
A correção: anexar a mensagem como retornada#
A atitude mais segura é não reconstruir a mensagem do assistente de forma alguma. Pegue-a da resposta e anexe-a inteira. Aqui está um loop completo com o SDK Python da OpenAI apontado para o CheapTokens. A ferramenta de clima é um stub, então você pode executá-lo como está.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
A única linha que importa é messages.. O SDK mantém campos que não conhece, então tudo o que a API colocou na mensagem, reasoning_ incluído, viaja de volta com ela. A resposta final também é anexada, que é o que a regra pede: após a primeira chamada de ferramenta, toda requisição posterior carrega o raciocínio dos turnos anteriores do assistente.
A mecânica da chamada de ferramenta em si (schema, tool_call_id, parsing de argumentos) está em Function calling in Python with an OpenAI-compatible API. A URL base, a chave e o id do modelo estão na página de docs do CheapTokens; o modelo usado aqui é descrito na página do DeepSeek: contexto de 380K e até 32.768 tokens de saída por resposta, o que deixa espaço para raciocínio longo mais uma resposta.
Um culpado comum: uma mensagem reconstruída à mão#
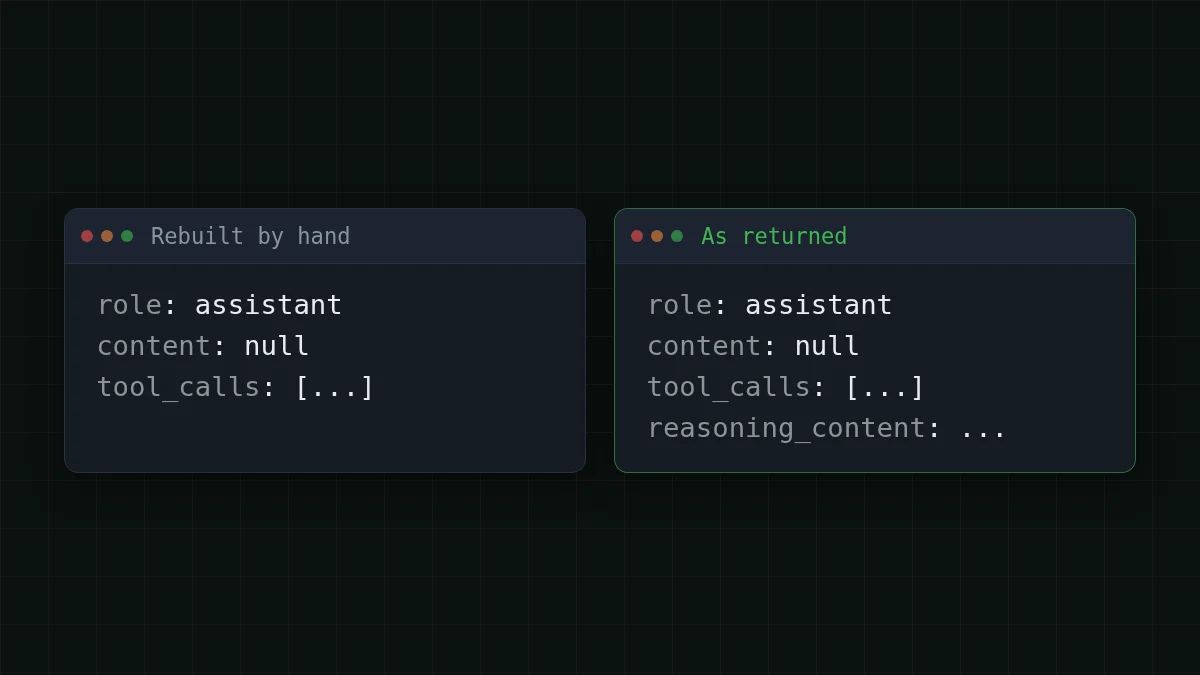
Uma forma comum de perder o campo é um código que não anexa o objeto da resposta, mas monta um novo dict. Parece inofensivo: role, content, tool calls. Frameworks e wrappers fazem o mesmo quando armazenam o histórico em seu próprio formato. O único campo de que nunca ouviram falar é justamente o que desaparece.
Comparar
Reconstruída à mão vs anexada inteira
Reconstruída à mão (quebra)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Anexada inteira (funciona)
messages.append(msg.model_dump(exclude_none=True))Se você usa um framework e não consegue tocar nessa linha, verifique como ele armazena os turnos do assistente. Um histórico que passa por um serializador que mantém apenas content e tool_calls tem o mesmo bug, só uma camada abaixo.
Quando você não precisa disso#
Nem toda chamada a um modelo de raciocínio precisa desse cuidado extra. Para chat multi-turno sem ferramentas, o guia do DeepSeek diz que reasoning_ não precisa ser reenviado; se você enviar mesmo assim, ele é ignorado e o raciocínio anterior não é adicionado ao contexto. Então um chat simples pode continuar descartando-o e nada quebra.
Escolha o seu caso
Qual é o seu caso?
Escolha uma opção para ver a resposta
A requisição tem tools, o modelo está raciocinando
Anexe a mensagem inteira do assistente a cada turno, tanto turnos de ferramenta quanto respostas finais.
Chat simples, sem o parâmetro tools
Nenhuma correção necessária. Você pode descartar reasoning_ do histórico ou enviá-lo; ele é ignorado.
Um framework monta o histórico para você
Encontre onde ele serializa as mensagens do assistente e garanta que reasoning_ sobreviva. Se não for possível, chame a API com seu próprio loop para a parte de ferramentas.
Um efeito colateral a ter em mente: o histórico que você reenvia é entrada em toda requisição, então raciocínio longo em um loop longo se acumula. Como os tokens de raciocínio são contados está em Reasoning effort and thinking tokens, e o que fazer quando uma requisição cresce além dos limites do modelo está em Request too long: 400 vs 413.
Se ainda retornar 400#
Percorra isto em ordem:
- Imprima
messageslogo antes da chamada que falha. Toda mensagem do assistente que veio do modelo temreasoning_, se a resposta tinha?content - Você reconstrói alguma mensagem em algum lugar: um helper, uma classe de histórico, um
json.dumpse volta com uma lista fixa de chaves? - A mensagem
toolpara cadatool_call_idestá presente, com o mesmo id? - É realmente o comprimento? Uma requisição acima do limite de contexto é um 400 diferente, descrito no artigo acima.
Verificação rápida
O que você anexa depois que o modelo pede uma ferramenta?
Mostrar resposta
Resposta: A mensagem inteira do assistente como retornada, reasoning_content incluído
As tool_calls são o que suas mensagens de ferramenta respondem, e com ferramentas na requisição o raciocínio precisa ir junto com elas.
Essa é a correção inteira: um append, sem reconstrução. Adicione o limite de passos do exemplo a qualquer loop que você colocar em produção, para que um turno ruim custe cinco requisições, não quinhentas.


