Khắc phục sự cốHướng dẫn
400 sau một tool call: gửi lại reasoning_content
Vì sao request thứ hai của một vòng lặp tool-call trả về 400 trên thinking model, một cách khắc phục bằng Python nối nguyên vẹn message, và khi nào bạn có thể bỏ qua.
Trên trang này
Vòng lặp agent của bạn chạy được ở request đầu tiên và lỗi ở request thứ hai với mã 400. Trên một thinking model, một nguyên nhân đã được ghi nhận là thiếu một trường: assistant message bạn gửi lại đã mất reasoning_. Nếu đúng là nguyên nhân này, việc nối nguyên vẹn message đúng như API trả về sẽ khắc phục được.
Hướng dẫn chế độ thinking của DeepSeek (tài liệu, kiểm tra ngày 8 tháng 11 năm 2026) tóm gọn quy tắc trong một câu: khi request có tham số tools, reasoning_ phải được truyền lại đầy đủ trong tất cả các request tiếp theo, kể cả những lượt không có tool call. Nếu không, API trả về 400. Cùng trang đó nói rằng thinking được bật mặc định, với mức effort high. Vì vậy một vòng lặp bạn viết cho model không-thinking có thể hỏng mà không cần đổi một dòng nào.
Điều gì xảy ra giữa request một và request hai#
Ở chế độ thinking, chuỗi suy luận được trả về trong reasoning_, một trường cùng cấp với content. Hãy hình dung vòng lặp:
- Bạn gửi câu hỏi và danh sách
tools. - Model trả lời bằng
tool_calls(vàreasoning_bên cạnh chúng).content - Bạn chạy tool và gửi lại mọi thứ: lịch sử, assistant message, và một message
toolchứa kết quả.
Lỗi 400 xuất hiện ở request trong bước 3 nếu assistant message trong đó không có reasoning_.
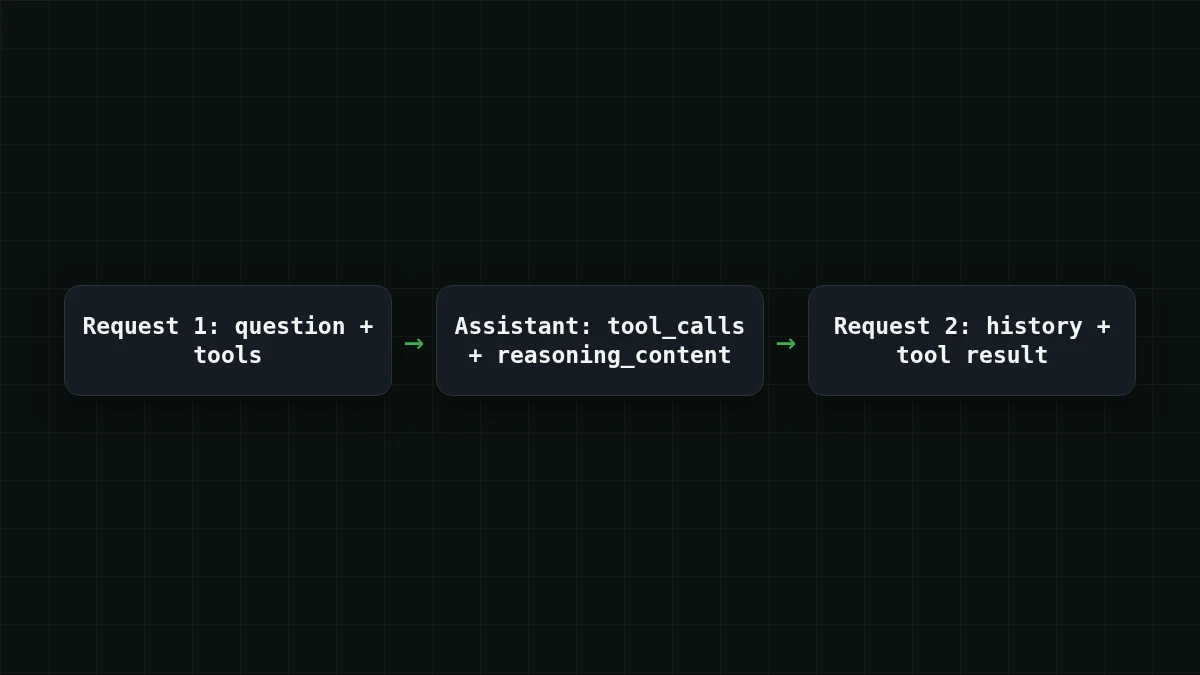
Trang DeepSeek chỉ ghi nhận lỗi 400 cho trường hợp tool-call này và không trích dẫn nội dung lỗi, nên hãy nhìn vào HTTP status, không phải một message cụ thể, khi bạn kiểm tra xem mình có gặp vấn đề này không.
Cách khắc phục: nối message đúng như được trả về#
Động thái an toàn nhất là không dựng lại assistant message chút nào. Hãy lấy nó từ response và nối nguyên vẹn. Dưới đây là một vòng lặp hoàn chỉnh với OpenAI Python SDK trỏ tới CheapTokens. Tool thời tiết là một stub, nên bạn có thể chạy nguyên như vậy.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
Dòng quan trọng duy nhất là messages.. SDK giữ lại những trường nó không biết, nên bất cứ thứ gì API đặt lên message, kể cả reasoning_, đều đi theo khi gửi lại. Câu trả lời cuối cùng cũng được nối vào, đúng như quy tắc yêu cầu: sau tool call đầu tiên, mọi request về sau đều mang theo reasoning của các lượt assistant trước đó.
Cơ chế tool-call (schema, tool_call_id, phân tích arguments) nằm trong Function calling in Python with an OpenAI-compatible API. Base URL, key và model id có trên trang tài liệu CheapTokens; model dùng ở đây được mô tả trên trang DeepSeek: context 380K và tối đa 32.768 output token mỗi câu trả lời, đủ chỗ cho thinking dài cộng với câu trả lời.
Thủ phạm phổ biến: một message bị dựng lại bằng tay#
Một cách phổ biến để làm mất trường này là code không nối đối tượng response mà dựng một dict mới. Nó trông vô hại: role, content, tool calls. Các framework và wrapper cũng làm vậy khi chúng lưu lịch sử theo định dạng riêng. Trường duy nhất chúng chưa từng nghe tới chính là trường bị mất.
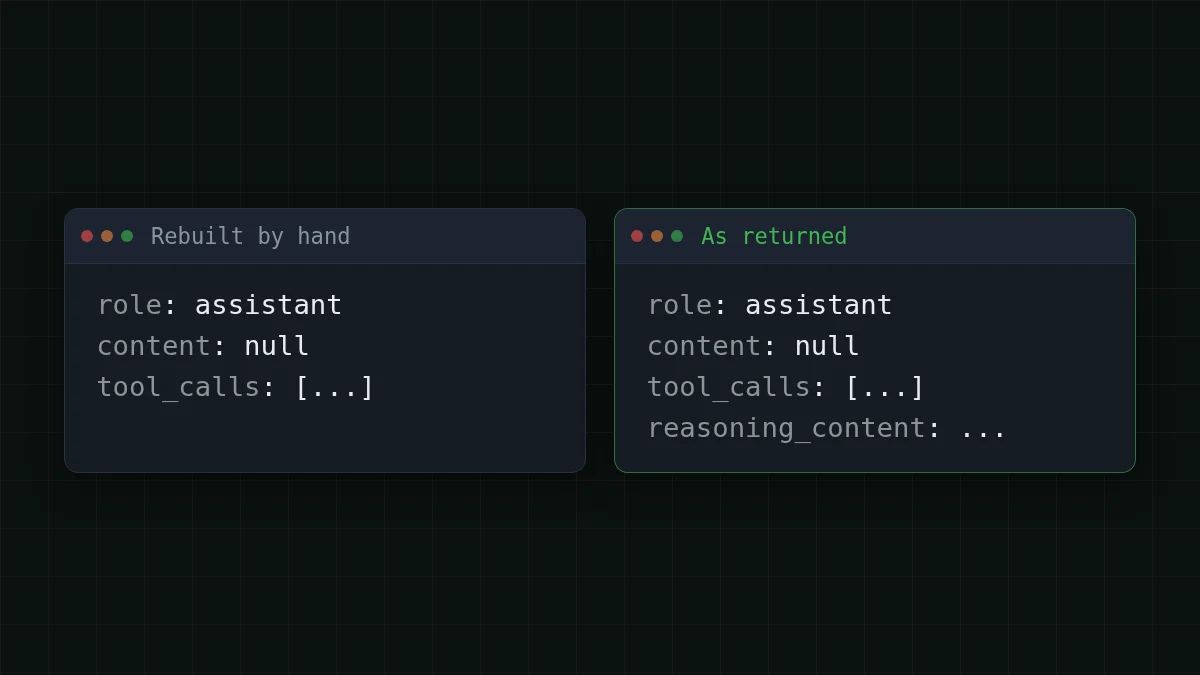
So sánh
Dựng lại bằng tay vs nối nguyên vẹn
Dựng lại bằng tay (hỏng)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Nối nguyên vẹn (chạy được)
messages.append(msg.model_dump(exclude_none=True))Nếu bạn dùng một framework và không thể sửa dòng đó, hãy kiểm tra cách nó lưu các lượt assistant. Một lịch sử đi qua serializer chỉ giữ content và tool_calls cũng có cùng lỗi, chỉ là ở một tầng thấp hơn.
Khi nào bạn không cần điều này#
Không phải mọi lần gọi thinking model đều cần sự cẩn thận thêm này. Với chat nhiều lượt không có tool, hướng dẫn của DeepSeek nói rằng reasoning_ không cần được truyền lại; nếu bạn vẫn gửi, nó bị bỏ qua và reasoning trước đó không được thêm vào context. Vậy một cuộc chat thường có thể tiếp tục bỏ nó mà không hỏng gì.
Chọn trường hợp của bạn
Trường hợp của bạn là gì?
Chọn một tùy chọn để xem đáp án
Request có tools, model đang thinking
Nối nguyên vẹn assistant message ở mọi lượt, cả lượt tool lẫn câu trả lời cuối.
Chat thường, không có tham số tools
Không cần sửa. Bạn có thể bỏ reasoning_ khỏi lịch sử, hoặc gửi nó; nó bị bỏ qua.
Một framework dựng lịch sử cho bạn
Tìm nơi nó serialize assistant message và đảm bảo reasoning_ còn sống sót. Nếu không được, hãy gọi API bằng vòng lặp của riêng bạn cho phần tool.
Một tác dụng phụ cần lưu ý: lịch sử bạn gửi lại là input ở mọi request, nên reasoning dài trong một vòng lặp dài sẽ cộng dồn. Cách đếm thinking token được trình bày trong Reasoning effort and thinking tokens, và việc cần làm khi một request vượt quá giới hạn của model nằm trong Request too long: 400 vs 413.
Nếu vẫn trả về 400#
Hãy đi qua theo thứ tự:
- In
messagesngay trước lần gọi bị lỗi. Mọi assistant message đến từ model córeasoning_không, nếu response có nó?content - Bạn có dựng lại message ở đâu đó không: một helper, một class lịch sử, một
json.dumpsrồi quay lại với danh sách key cố định? - Message
toolcho mọitool_call_idcó hiện diện không, với cùng id? - Có thực sự là do độ dài không? Một request vượt giới hạn context là một lỗi 400 khác, được mô tả trong bài viết ở trên.
Kiểm tra nhanh
Bạn nối gì sau khi model yêu cầu một tool?
Hiện đáp án
Trả lời: Nguyên vẹn assistant message đúng như được trả về, gồm cả reasoning_content
tool_calls là thứ mà các tool message của bạn trả lời, và khi request có tool thì reasoning phải đi kèm với chúng.
Đó là toàn bộ cách khắc phục: một lần nối, không dựng lại. Hãy thêm giới hạn số bước từ ví dụ vào mọi vòng lặp bạn triển khai, để một lượt hỏng chỉ tốn năm request, chứ không phải năm trăm.


