トラブルシューティングガイド
ツール呼び出し後の400:reasoning_contentを返送する
シンキングモデルでツール呼び出しループの2回目のリクエストが400を返す理由、メッセージ全体を追加するPythonの修正、そして省略できる場合について。
エージェントループが最初のリクエストでは動作し、2回目で400エラーになる。シンキングモデルでは、文書化された原因の1つにフィールドの欠落がある。返送するアシスタントメッセージからreasoning_が失われているのだ。これが原因なら、APIが返したとおりにメッセージ全体を追加すれば解決する。
DeepSeekのシンキングモードガイド(docs、2026年11月8日確認)は、このルールを一文で示している。リクエストにtoolsパラメータがある場合、reasoning_は以降のすべてのリクエストで完全に返送しなければならない。ツール呼び出しのないターンも含む。そうでなければAPIは400を返す。同じページには、シンキングはデフォルトで有効で、effortはhighだと書かれている。つまり、非シンキングモデル向けに書いたループは、一行も変えていないのに壊れる可能性がある。
リクエスト1とリクエスト2の間で何が起きるか#
シンキングモードでは、思考の連鎖はreasoning_で返される。これはcontentと同じ階層のフィールドだ。ループを思い浮かべてほしい。
- 質問と
toolsリストを送信する。 - モデルは
tool_calls(およびその隣のreasoning_)で応答する。content - ツールを実行し、すべてを返送する。履歴、アシスタントメッセージ、そして結果を含む
toolメッセージだ。
ステップ3のリクエストで、その中のアシスタントメッセージにreasoning_がない場合に400が返る。
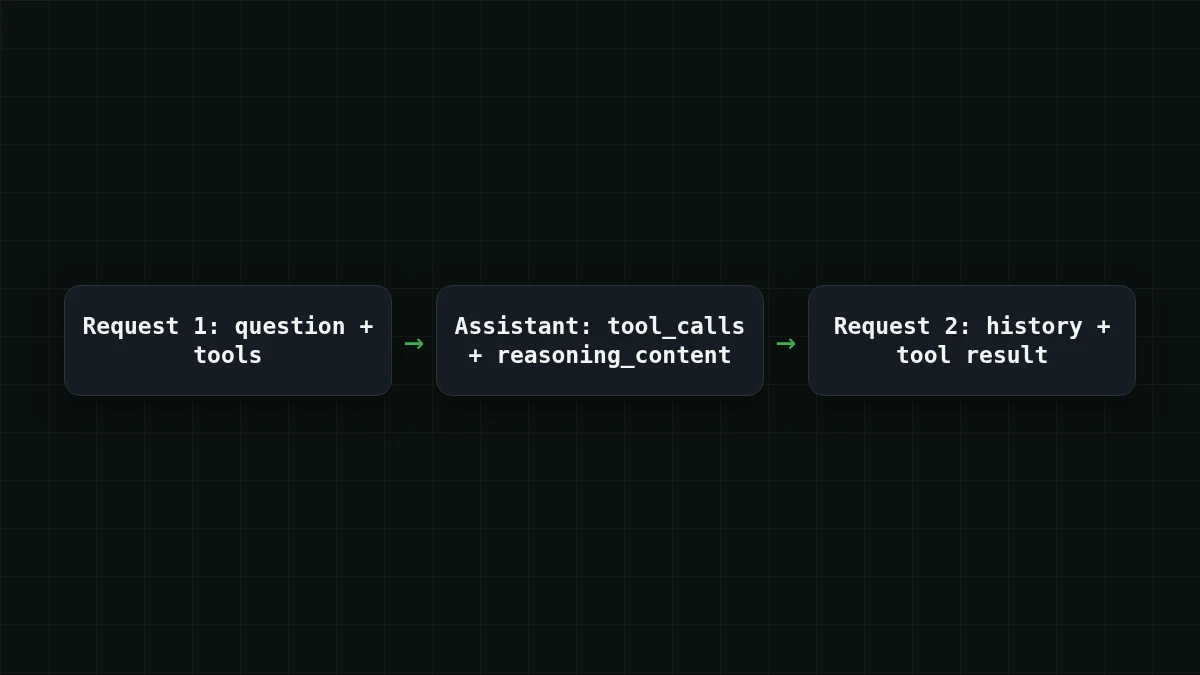
DeepSeekのページはこのツール呼び出しのケースについてのみ400を文書化しており、エラーテキストは引用していない。そのため、この問題に該当するか確認するときは、特定のメッセージではなくHTTPステータスを見ること。
修正:返されたとおりにメッセージを追加する#
最も安全な方法は、アシスタントメッセージを再構築しないことだ。レスポンスから取り出し、そのまま全体を追加する。以下は、OpenAI Python SDKをCheapTokensに向けた完全なループだ。天気ツールはスタブなので、そのまま実行できる。
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
})重要なのはmessages.の一行だ。SDKは未知のフィールドを保持するので、APIがメッセージに付けたものはreasoning_を含めてそのまま返送される。最終回答も追加される。これはルールが求めるとおりだ。最初のツール呼び出し以降、すべてのリクエストが以前のアシスタントターンの推論を運ぶ。
ツール呼び出しの仕組み自体(スキーマ、tool_call_id、引数のパース)はFunction calling in Python with an OpenAI-compatible APIにある。ベースURL、キー、モデルIDはCheapTokens docs pageにあり、ここで使うモデルはDeepSeek pageで説明されている。コンテキスト380K、回答あたり最大32,768出力トークンで、長い思考と回答のための余裕がある。
よくある原因:手作業で再構築されたメッセージ#
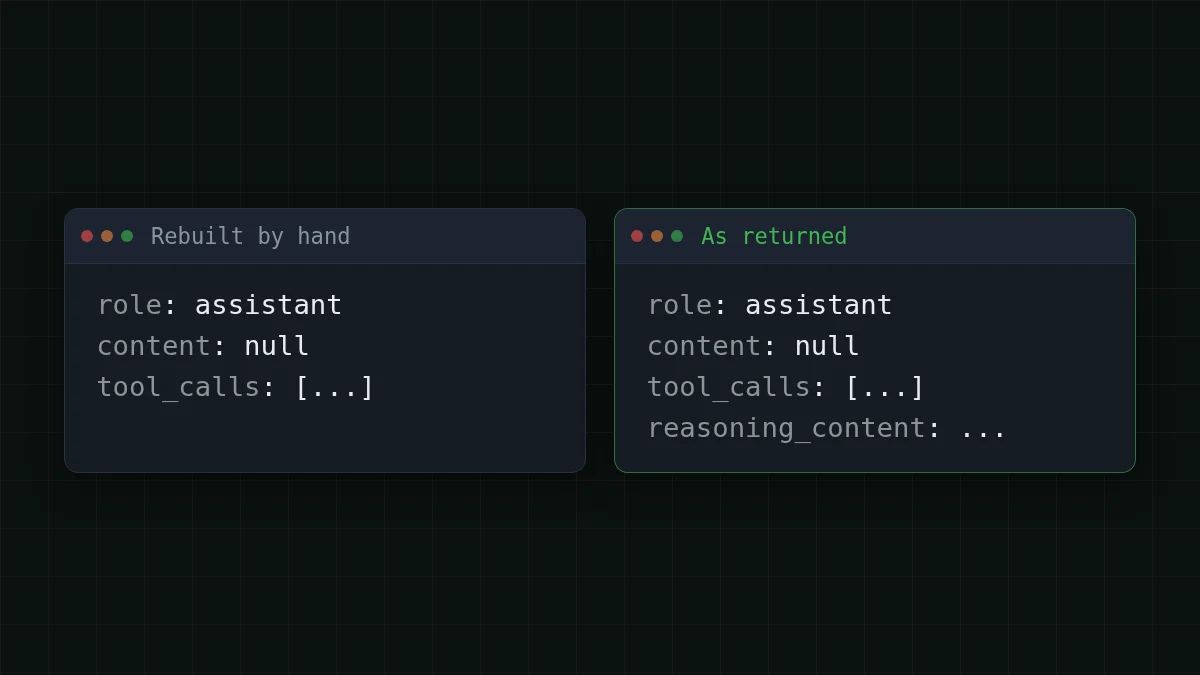
フィールドを失うよくある方法は、レスポンスオブジェクトを追加せず、新しいdictを構築するコードだ。role、content、tool_callsと、一見無害に見える。フレームワークやラッパーも、履歴を独自形式で保存するときに同じことをする。彼らが聞いたことのないそのフィールドこそが、失われるフィールドだ。
比較する
手作業での再構築 vs 全体の追加
手作業での再構築(壊れる)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
全体の追加(動作する)
messages.append(msg.model_dump(exclude_none=True))フレームワークを使っていてその行に触れられない場合は、アシスタントターンをどう保存しているか確認すること。contentとtool_callsだけを保持するシリアライザを通る履歴も同じバグを持つ。ただ、1層下での話だ。
これが不要な場合#
すべてのシンキングモデル呼び出しに追加の注意が必要なわけではない。ツールなしのマルチターンチャットでは、DeepSeekのガイドによればreasoning_を返送する必要はない。送っても無視され、以前の推論はコンテキストに追加されない。したがって、通常のチャットでは捨て続けても何も壊れない。
ケースを選ぶ
あなたのケースはどれか?
オプションを選択して答えを表示
リクエストにtoolsがあり、モデルがシンキング
ツールターンも最終回答も、毎ターン、アシスタントメッセージ全体を追加する。
通常のチャットでtoolsパラメータなし
修正は不要。履歴からreasoning_を捨ててもよいし、送ってもよい。無視される。
フレームワークが履歴を構築する
アシスタントメッセージをシリアライズする場所を見つけ、reasoning_が残るようにする。できない場合は、ツール部分だけ独自のループでAPIを呼ぶ。
覚えておくべき副作用:再送する履歴は毎リクエストの入力なので、長いループでの長い推論は積み重なる。シンキングトークンの数え方はReasoning effort and thinking tokensで、リクエストがモデルの限界を超えて大きくなったときの対処はRequest too long: 400 vs 413で扱っている。
それでも400が返る場合#
次の順に確認する。
- 失敗する呼び出しの直前に
messagesを出力する。レスポンスにあったなら、モデルから来たすべてのアシスタントメッセージにreasoning_があるか?content - どこかでメッセージを再構築していないか。ヘルパー、履歴クラス、固定のキーリストでの
json.dumpsと戻し? - すべての
tool_call_idに対するtoolメッセージが、同じidで存在するか? - 本当に長さの問題か?コンテキスト上限を超えたリクエストは別の400で、上の記事で説明している。
クイックチェック
モデルがツールを要求した後、何を追加するか?
答えを表示
答え: reasoning_contentを含む、返されたとおりのアシスタントメッセージ全体
tool_callsはツールメッセージが応答する対象であり、リクエストにツールがある場合、推論はそれらと一緒に運ばれなければならない。
修正はこれだけだ。1回の追加で、再構築は不要。出荷するすべてのループに例のステップ上限を加えて、悪いターンのコストが500リクエストではなく5リクエストで済むようにしよう。


