DépannageGuide
400 après un appel d'outil : renvoyer reasoning_content
Pourquoi la seconde requête d'une boucle d'appel d'outil renvoie 400 sur un modèle de réflexion, un correctif Python qui ajoute le message complet, et quand vous pouvez l'omettre.
Sur cette page
Votre boucle d'agent fonctionne à la première requête et échoue à la seconde avec un 400. Sur un modèle de réflexion, l'une des causes documentées est un champ manquant : le message assistant que vous renvoyez a perdu son reasoning_. Si c'est la cause, ajouter le message entier exactement tel que l'API l'a renvoyé corrige le problème.
Le guide du mode réflexion de DeepSeek (docs, vérifié le 8 novembre 2026) énonce la règle en une phrase : lorsque la requête contient le paramètre tools, reasoning_ doit être renvoyé intégralement dans toutes les requêtes suivantes, y compris les tours sans appel d'outil. Sinon, l'API renvoie 400. La même page indique que la réflexion est activée par défaut, avec l'effort high. Une boucle écrite pour un modèle sans réflexion peut donc casser sans qu'une seule ligne ne change.
Ce qui se passe entre la première et la deuxième requête#
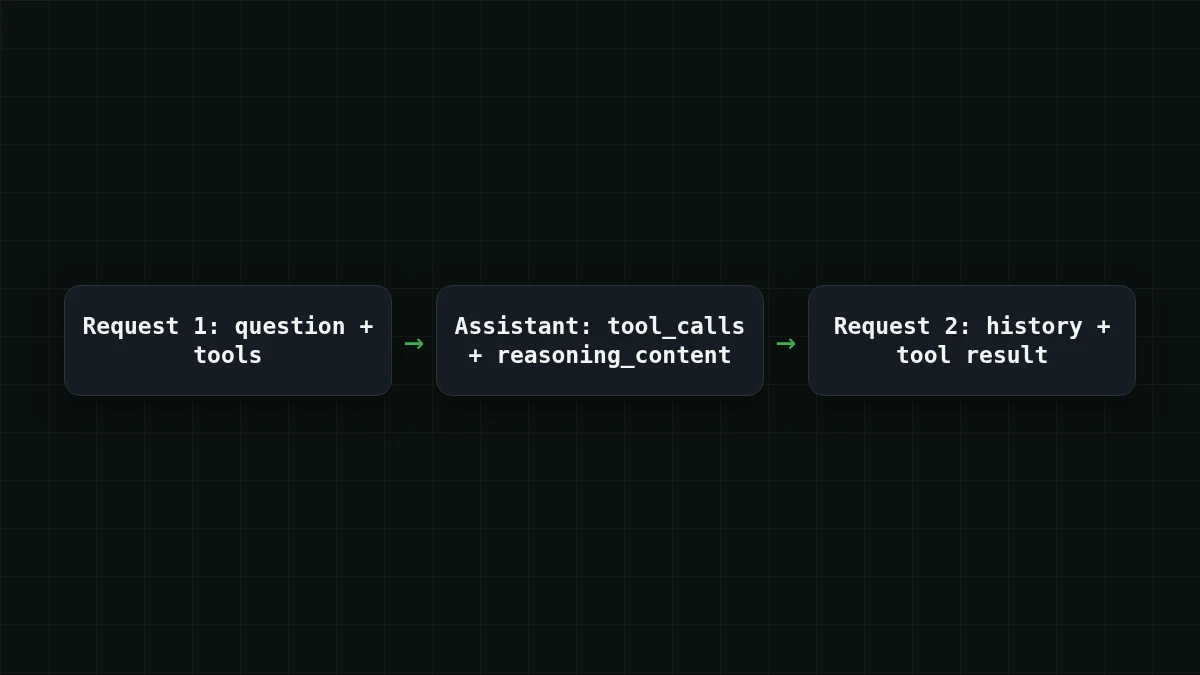
En mode réflexion, la chaîne de pensée revient dans reasoning_, un champ au même niveau que content. Voici la boucle :
- Vous envoyez la question et la liste
tools. - Le modèle répond avec
tool_calls(etreasoning_à côté).content - Vous exécutez l'outil et renvoyez le tout : l'historique, le message assistant et un message
toolavec le résultat.
Le 400 survient à la requête de l'étape 3 si le message assistant qu'elle contient n'a pas de reasoning_.
La page DeepSeek ne documente le 400 que pour ce cas d'appel d'outil et ne cite pas de texte d'erreur ; regardez donc le statut HTTP, pas un message précis, pour vérifier si vous avez ce problème.
Le correctif : ajouter le message tel que renvoyé#
La manœuvre la plus sûre est de ne pas reconstruire le message assistant du tout. Prenez-le dans la réponse et ajoutez-le entier. Voici une boucle complète avec le SDK Python OpenAI pointé vers CheapTokens. L'outil météo est un stub, vous pouvez donc l'exécuter tel quel.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
La ligne qui compte est messages.. Le SDK conserve les champs qu'il ne connaît pas, donc tout ce que l'API a mis sur le message, reasoning_ inclus, repart avec lui. La réponse finale est ajoutée aussi, ce que la règle exige : après le premier appel d'outil, chaque requête ultérieure porte le raisonnement des tours assistant précédents.
La mécanique des appels d'outils elle-même (schéma, tool_call_id, analyse des arguments) est décrite dans Function calling in Python with an OpenAI-compatible API. L'URL de base, la clé et l'identifiant du modèle sont sur la page de documentation CheapTokens ; le modèle utilisé ici est décrit sur la page DeepSeek : 380K de contexte et jusqu'à 32 768 jetons de sortie par réponse, ce qui laisse de la place pour une longue réflexion plus une réponse.
Un coupable courant : un message reconstruit à la main#
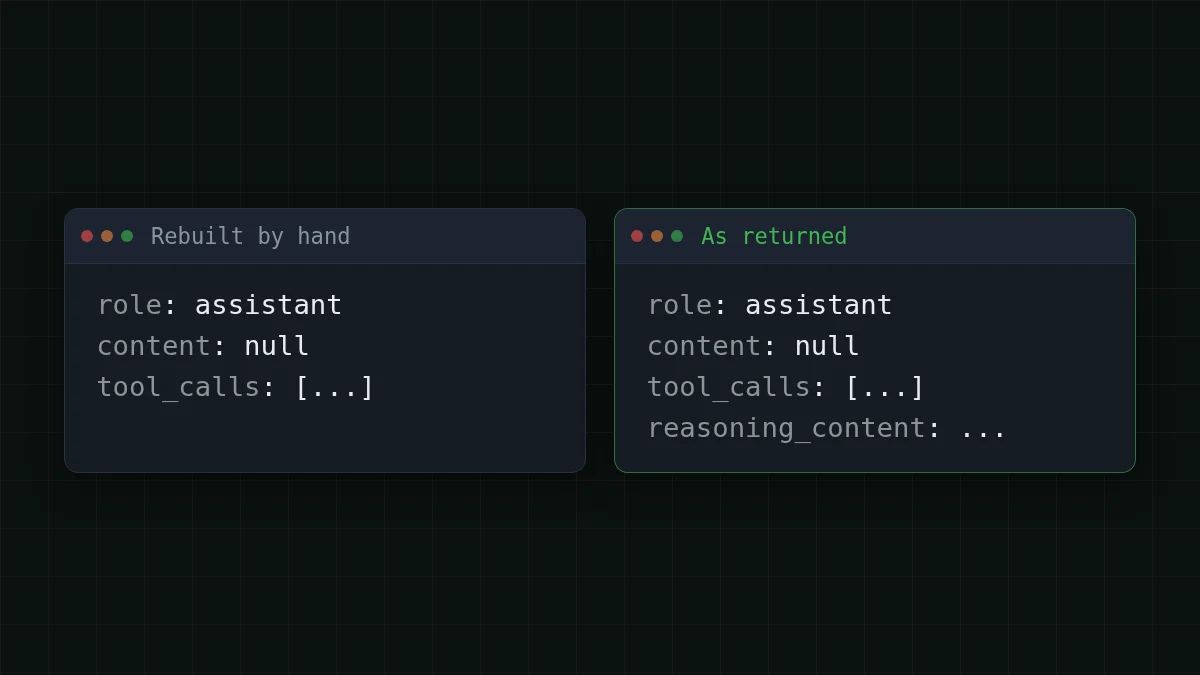
Un moyen courant de perdre le champ est un code qui n'ajoute pas l'objet de réponse mais construit un nouveau dict. Cela paraît inoffensif : role, content, tool calls. Les frameworks et les wrappers font de même lorsqu'ils stockent l'historique dans leur propre format. Le seul champ dont ils n'ont jamais entendu parler est celui qui disparaît.
Comparer
Reconstruit à la main vs ajouté entier
Reconstruit à la main (casse)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Ajouté entier (fonctionne)
messages.append(msg.model_dump(exclude_none=True))Si vous utilisez un framework et ne pouvez pas toucher à cette ligne, vérifiez comment il stocke les tours assistant. Un historique qui passe par un sérialiseur ne conservant que content et tool_calls a le même bug, juste une couche plus bas.
Quand vous n'en avez pas besoin#
Tous les appels à un modèle de réflexion n'exigent pas cette précaution supplémentaire. Pour un chat multi-tours sans outils, le guide DeepSeek indique que reasoning_ n'a pas besoin d'être renvoyé ; si vous l'envoyez quand même, il est ignoré et le raisonnement précédent n'est pas ajouté au contexte. Un chat simple peut donc continuer à le supprimer sans rien casser.
Choisissez votre cas
Quel est votre cas ?
Choisissez une option pour voir la réponse
La requête contient tools, le modèle réfléchit
Ajoutez le message assistant entier à chaque tour, tours d'outil comme réponses finales.
Chat simple, pas de paramètre tools
Aucun correctif nécessaire. Vous pouvez supprimer reasoning_ de l'historique, ou l'envoyer ; il est ignoré.
Un framework construit l'historique pour vous
Trouvez où il sérialise les messages assistant et assurez-vous que reasoning_ survit. Si ce n'est pas possible, appelez l'API avec votre propre boucle pour la partie outil.
Un effet secondaire à garder en tête : l'historique que vous renvoyez est une entrée à chaque requête, donc un long raisonnement dans une longue boucle s'accumule. Le comptage des jetons de réflexion est traité dans Reasoning effort and thinking tokens, et que faire quand une requête dépasse les limites du modèle est expliqué dans Request too long: 400 vs 413.
S'il renvoie encore 400#
Passez ceci en revue dans l'ordre :
- Affichez
messagesjuste avant l'appel qui échoue. Chaque message assistant issu du modèle a-t-ilreasoning_, si la réponse le contenait ?content - Reconstruisez-vous un message quelque part : un helper, une classe d'historique, un aller-retour
json.dumpsavec une liste fixe de clés ? - Le message
toolde chaquetool_call_idest-il présent, avec le même id ? - Est-ce vraiment la longueur ? Une requête au-delà de la limite de contexte est un autre 400, décrit dans l'article ci-dessus.
Vérification rapide
Qu'ajoutez-vous après que le modèle a demandé un outil ?
Afficher la réponse
Réponse: Le message assistant entier tel que renvoyé, reasoning_content inclus
Les tool_calls sont ce à quoi répondent vos messages d'outil, et avec des outils dans la requête, le raisonnement doit voyager avec eux.
Voilà tout le correctif : un ajout, aucune reconstruction. Ajoutez la limite d'étapes de l'exemple à chaque boucle que vous livrez, pour qu'un mauvais tour coûte cinq requêtes, pas cinq cents.


