400 tras una llamada a herramienta: devuelve reasoning_content
Por qué la segunda petición de un bucle de llamadas a herramientas devuelve 400 en un modelo de razonamiento, un arreglo en Python que añade el mensaje completo y cuándo puedes omitirlo.
En esta página
Tu bucle de agente funciona en la primera petición y falla en la segunda con un 400. En un modelo de razonamiento, una causa documentada es un campo ausente: el mensaje del asistente que devuelves ha perdido su reasoning_. Si esa es la causa, añadir el mensaje completo exactamente como lo devolvió la API lo soluciona.
La guía del modo de razonamiento de DeepSeek (docs, consultada el 8 de noviembre de 2026) resume la regla en una frase: cuando la petición tiene el parámetro tools, reasoning_ debe devolverse completo en todas las peticiones siguientes, incluidos los turnos sin llamada a herramienta. De lo contrario, la API devuelve 400. La misma página indica que el razonamiento está activado por defecto, con esfuerzo high. Así que un bucle escrito para un modelo sin razonamiento puede romperse sin cambiar una sola línea.
Qué ocurre entre la primera y la segunda petición#
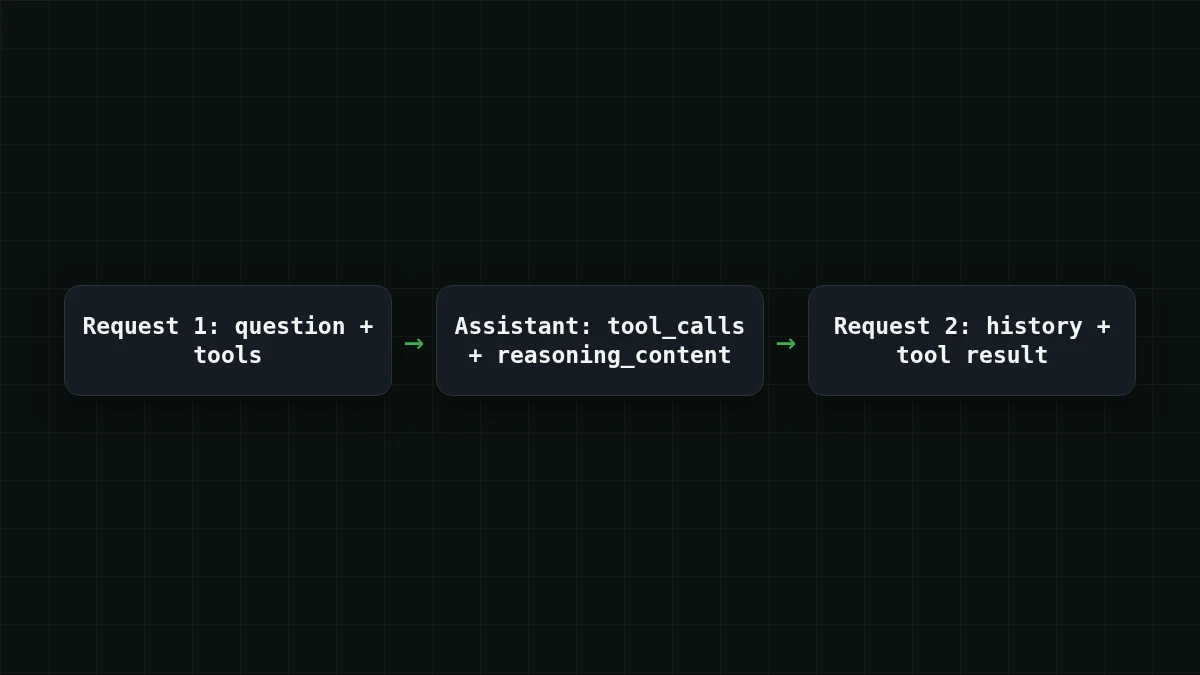
En modo de razonamiento, la cadena de pensamiento vuelve en reasoning_, un campo al mismo nivel que content. Imagina el bucle:
- Envías la pregunta y la lista
tools. - El modelo responde con
tool_calls(yreasoning_junto a ellos).content - Ejecutas la herramienta y devuelves todo: el historial, el mensaje del asistente y un mensaje
toolcon el resultado.
El 400 aparece en la petición del paso 3 si el mensaje del asistente que contiene no tiene reasoning_.
La página de DeepSeek documenta el 400 solo para este caso de llamada a herramienta y no cita un texto de error, así que fíjate en el estado HTTP, no en un mensaje concreto, cuando compruebes si tienes este problema.
La solución: añadir el mensaje tal como se devolvió#
Lo más seguro es no reconstruir el mensaje del asistente en absoluto. Tómalo de la respuesta y añádelo entero. Aquí tienes un bucle completo con el SDK de Python de OpenAI apuntando a CheapTokens. La herramienta del tiempo es un stub, así que puedes ejecutarlo tal cual.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
La línea que importa es messages.. El SDK conserva los campos que no conoce, así que todo lo que la API puso en el mensaje, incluido reasoning_, viaja de vuelta con él. La respuesta final también se añade, que es lo que pide la regla: tras la primera llamada a herramienta, cada petición posterior lleva el razonamiento de los turnos anteriores del asistente.
La mecánica de las llamadas a herramientas en sí (esquema, tool_call_id, análisis de argumentos) está en Function calling in Python with an OpenAI-compatible API. La URL base, la clave y el id del modelo están en la página de docs de CheapTokens; el modelo usado aquí se describe en la página de DeepSeek: contexto de 380K y hasta 32.768 tokens de salida por respuesta, lo que deja espacio para un razonamiento largo más una respuesta.
Un culpable habitual: un mensaje reconstruido a mano#
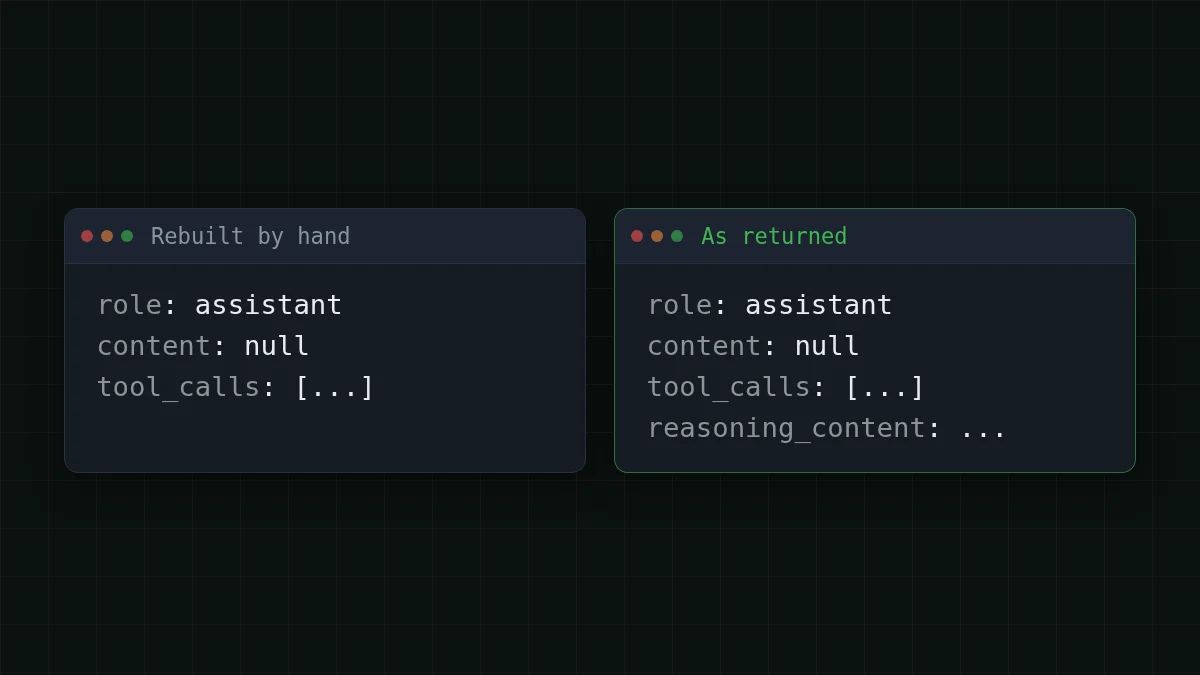
Una forma habitual de perder el campo es el código que no añade el objeto de respuesta sino que construye un dict nuevo. Parece inofensivo: role, content, tool calls. Los frameworks y wrappers hacen lo mismo cuando guardan el historial en su propio formato. El único campo del que nunca oyeron hablar es el que se pierde.
Comparar
Reconstruido a mano vs añadido entero
Reconstruido a mano (falla)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Añadido entero (funciona)
messages.append(msg.model_dump(exclude_none=True))Si usas un framework y no puedes tocar esa línea, comprueba cómo almacena los turnos del asistente. Un historial que pasa por un serializador que solo conserva content y tool_calls tiene el mismo bug, solo una capa más abajo.
Cuándo no lo necesitas#
No todas las llamadas a un modelo de razonamiento necesitan este cuidado extra. Para chat multiturno sin herramientas, la guía de DeepSeek dice que reasoning_ no tiene que devolverse; si lo envías de todos modos, se ignora y el razonamiento anterior no se añade al contexto. Así que un chat normal puede seguir descartándolo y nada se rompe.
Elige tu caso
¿Cuál es tu caso?
Elige una opción para ver la respuesta
La petición tiene tools, el modelo razona
Añade el mensaje completo del asistente en cada turno, tanto en turnos de herramienta como en respuestas finales.
Chat normal, sin parámetro tools
No hace falta arreglo. Puedes descartar reasoning_ del historial, o enviarlo; se ignora.
Un framework construye el historial por ti
Encuentra dónde serializa los mensajes del asistente y asegúrate de que reasoning_ sobrevive. Si no puede, llama a la API con tu propio bucle para la parte de herramientas.
Un efecto secundario a tener en cuenta: el historial que reenvías es entrada en cada petición, así que un razonamiento largo en un bucle largo se acumula. Cómo se cuentan los tokens de razonamiento se trata en Reasoning effort and thinking tokens, y qué hacer cuando una petición supera los límites del modelo está en Request too long: 400 vs 413.
Si sigue devolviendo 400#
Revisa esto en orden:
- Imprime
messagesjusto antes de la llamada que falla. ¿Todos los mensajes del asistente que vinieron del modelo tienenreasoning_, si la respuesta lo tenía?content - ¿Reconstruyes un mensaje en algún sitio: un helper, una clase de historial, un
json.dumpsy vuelta con una lista fija de claves? - ¿Está presente el mensaje
toolpara cadatool_call_id, con el mismo id? - ¿Es realmente la longitud? Una petición que supera el límite de contexto es un 400 distinto, descrito en el artículo anterior.
Verificación rápida
¿Qué añades después de que el modelo pida una herramienta?
Mostrar respuesta
Respuesta: El mensaje completo del asistente tal como se devolvió, reasoning_content incluido
Los tool_calls son lo que responden tus mensajes de herramienta, y con herramientas en la petición el razonamiento tiene que viajar junto a ellos.
Eso es todo el arreglo: un append, sin reconstruir. Añade el límite de pasos del ejemplo a cualquier bucle que despliegues, para que un turno malo cueste cinco peticiones, no quinientas.


