Pag-troubleshootGabay
400 pagkatapos ng tool call: ipadala pabalik ang reasoning_content
Bakit nagbabalik ng 400 ang pangalawang request ng tool-call loop sa isang thinking model, isang Python fix na nag-a-append ng buong mensahe, at kung kailan mo ito maaaring laktawan.
Sa pahinang ito
Gumagana ang agent loop mo sa unang request at nabibigo sa pangalawa na may 400. Sa isang thinking model, isang dokumentadong dahilan ang nawawalang field: nawala na ang reasoning_ ng assistant message na ipinapadala mo pabalik. Kung iyon ang dahilan, ang pag-append ng buong mensahe nang eksakto kung paano ito ibinalik ng API ang nag-aayos nito.
Ang thinking-mode guide ng DeepSeek (docs, sinuri noong 8 Nobyembre 2026) ay inilalagay ang tuntunin sa isang pangungusap: kapag ang request ay may tools parameter, kailangang maipasa pabalik ang reasoning_ nang buo sa lahat ng sumusunod na request, kasama na ang mga turn na walang tool call. Kung hindi, nagbabalik ang API ng 400. Sinasabi rin ng parehong pahina na naka-on ang thinking bilang default, na may effort na high. Kaya ang loop na isinulat mo para sa isang non-thinking model ay maaaring masira nang walang kahit isang linya na nagbago.
Ano ang nangyayari sa pagitan ng request one at request two#
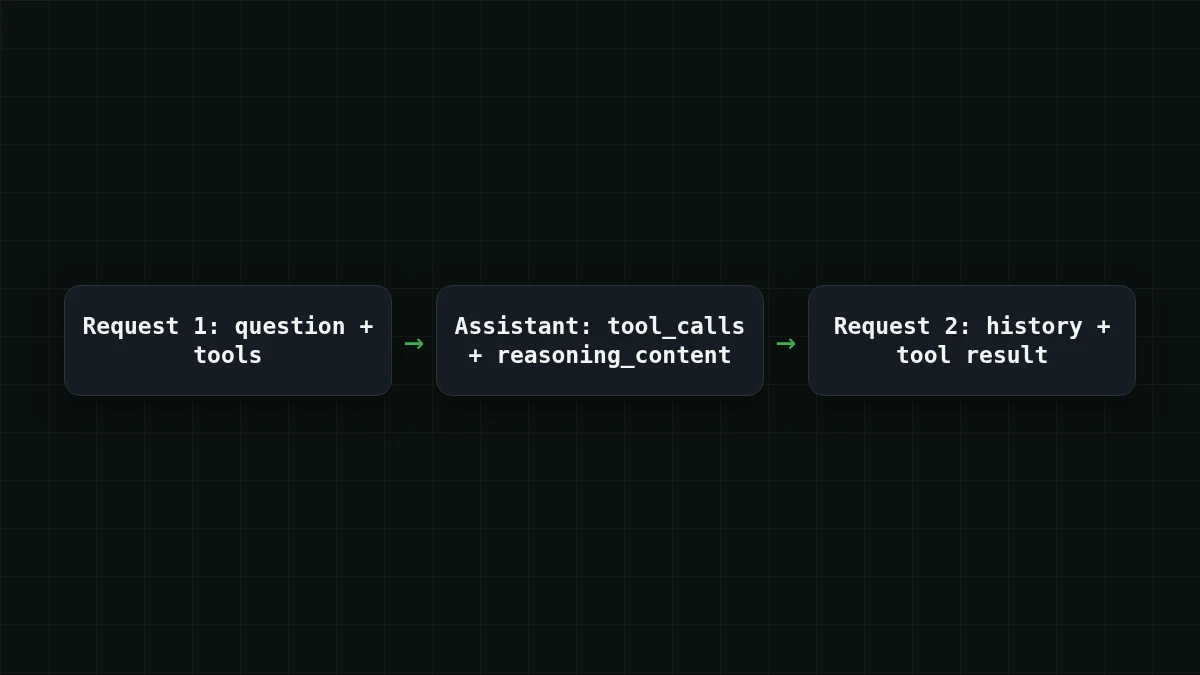
Sa thinking mode, bumabalik ang chain of thought sa reasoning_, isang field sa parehong antas ng content. Isipin ang loop:
- Ipinapadala mo ang tanong at ang
toolslist. - Sumasagot ang model ng
tool_calls(atreasoning_sa tabi nila).content - Pinapatakbo mo ang tool at ipinapadala pabalik ang lahat: ang history, ang assistant message, at isang
toolmessage na may resulta.
Dumarating ang 400 sa request sa step 3 kung ang assistant message dito ay walang reasoning_.
Dinodokumento ng pahina ng DeepSeek ang 400 para lamang sa tool-call case na ito at hindi nito sinisipi ang error text, kaya tingnan ang HTTP status, hindi ang isang partikular na mensahe, kapag sinusuri mo kung mayroon ka ng problemang ito.
Ang fix: i-append ang mensahe kung paano ito ibinalik#
Ang pinakaligtas na hakbang ay huwag muling buuin ang assistant message. Kunin ito mula sa response at i-append nang buo. Narito ang isang kumpletong loop gamit ang OpenAI Python SDK na nakaturo sa CheapTokens. Ang weather tool ay isang stub, kaya maaari mong patakbuhin ito nang ganito.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
Ang isang linyang mahalaga ay messages.. Pinapanatili ng SDK ang mga field na hindi nito kilala, kaya anuman ang inilagay ng API sa mensahe, kasama na ang reasoning_, ay naglalakbay pabalik kasama nito. Ini-append din ang final answer, na siyang hinihingi ng tuntunin: pagkatapos ng unang tool call, ang bawat susunod na request ay nagdadala ng reasoning ng mga naunang assistant turn.
Ang tool-call mechanics mismo (schema, tool_call_id, pag-parse ng arguments) ay nasa Function calling in Python with an OpenAI-compatible API. Ang base URL, key at model id ay nasa CheapTokens docs page; ang model na ginamit dito ay inilalarawan sa DeepSeek page: 380K context at hanggang 32,768 output tokens bawat sagot, na nag-iiwan ng espasyo para sa mahabang thinking at isang sagot.
Isang karaniwang salarin: mensaheng muling binuo sa pamamagitan ng kamay#
Isang karaniwang paraan para mawala ang field ay ang code na hindi nag-a-append ng response object kundi gumagawa ng bagong dict. Mukhang hindi nakakasama: role, content, tool calls. Ganoon din ang ginagawa ng mga framework at wrapper kapag iniimbak nila ang history sa sarili nilang format. Ang isang field na hindi nila narinig ay siyang nawawala.
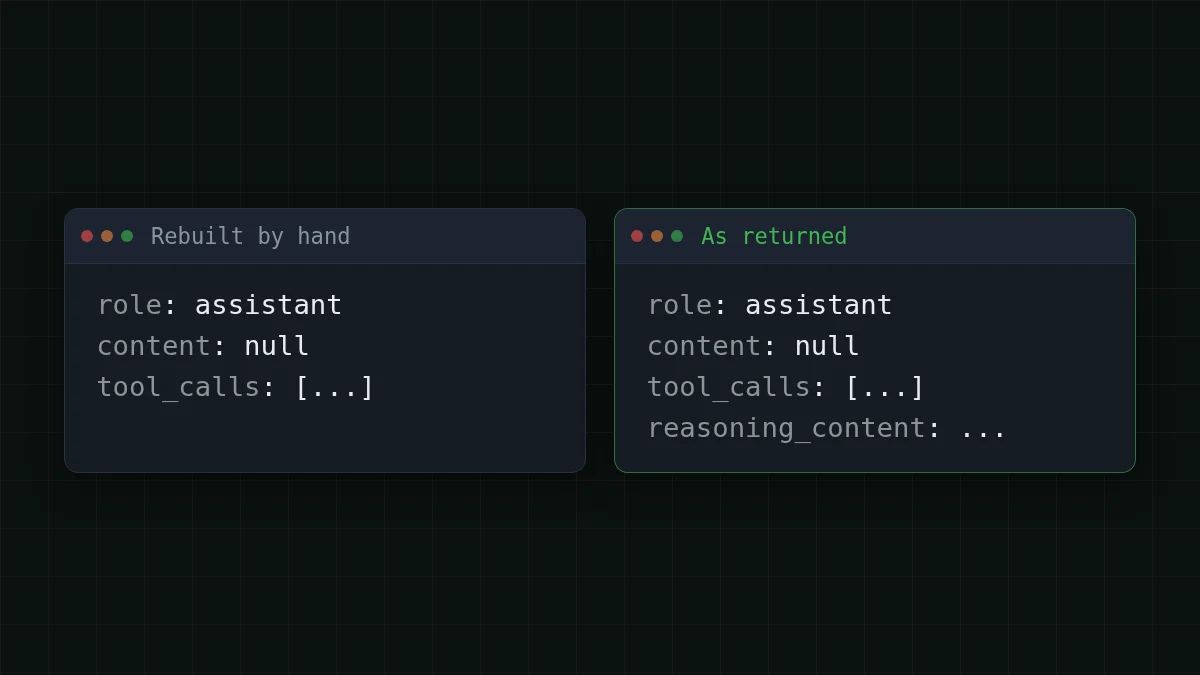
Ihambing
Muling binuo sa pamamagitan ng kamay vs ini-append nang buo
Muling binuo sa pamamagitan ng kamay (nasira)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Ini-append nang buo (gumagana)
messages.append(msg.model_dump(exclude_none=True))Kung gumagamit ka ng framework at hindi mo mahawakan ang linyang iyon, tingnan kung paano nito iniimbak ang mga assistant turn. Ang history na dumadaan sa isang serializer na pinapanatili lamang ang content at tool_calls ay may parehong bug, isang layer lang ang mas mababa.
Kapag hindi mo ito kailangan#
Hindi lahat ng thinking-model call ay nangangailangan ng dagdag na pag-iingat. Para sa multi-turn chat na walang tools, sinasabi ng guide ng DeepSeek na hindi kailangang maipasa pabalik ang reasoning_; kung ipapadala mo pa rin ito, binabalewala ito at hindi idinadagdag ang naunang reasoning sa context. Kaya ang isang plain chat ay maaaring patuloy na mag-drop nito at walang masisira.
Piliin ang iyong kaso
Alin ang kaso mo?
Pumili ng opsyon upang makita ang sagot
Ang request ay may tools, nag-iisip ang model
I-append ang buong assistant message sa bawat turn, tool turns at final answers alike.
Plain chat, walang tools parameter
Walang fix na kailangan. Maaari mong i-drop ang reasoning_ mula sa history, o ipadala ito; binabalewala ito.
Isang framework ang gumagawa ng history para sa iyo
Hanapin kung saan nito ini-serialize ang mga assistant message at tiyakin na nananatili ang reasoning_. Kung hindi kaya, tawagan ang API gamit ang sarili mong loop para sa tool part.
Isang side effect na dapat tandaan: ang history na ipinapadala mong muli ay input sa bawat request, kaya ang mahabang reasoning sa mahabang loop ay nadadagdag. Kung paano binibilang ang thinking tokens ay saklaw sa Reasoning effort and thinking tokens, at kung ano ang gagawin kapag lumampas ang request sa limits ng model ay nasa Request too long: 400 vs 413.
Kung nagbabalik pa rin ng 400#
Daanan ito nang sunod-sunod:
- I-print ang
messagesbago mismo ang failing call. Mayreasoning_ba ang bawat assistant message na nagmula sa model, kung mayroon ito sa response?content - May muling binubuo ka bang mensahe kahit saan: isang helper, isang history class, isang
json.dumpsat pabalik na may fixed na listahan ng keys? - Naroon ba ang
toolmessage para sa bawattool_call_id, na may parehong id? - Haba ba talaga ito? Ang request na lumampas sa context limit ay ibang 400, na inilarawan sa artikulo sa itaas.
Mabilisang pagsusuri
Ano ang ini-append mo pagkatapos humingi ng tool ang model?
Ipakita ang sagot
Sagot: Ang buong assistant message kung paano ito ibinalik, kasama ang reasoning_content
Ang tool_calls ang sinasagot ng iyong tool messages, at kapag may tools sa request, kailangang sumama ang reasoning sa kanila.
Iyon ang buong fix: isang append, walang muling pagbuo. Idagdag ang step limit mula sa halimbawa sa anumang loop na ipapadala mo, para ang isang masamang turn ay nagkakahalaga ng limang request, hindi limang daan.


