用 async-openai 在 Rust 中发出第一个请求:基础 URL、密钥、用量
一个使用 tokio 和 async-openai 的小型 Rust 程序,向 CheapTokens 发送一次 chat completion,并打印回复和 token 计数。
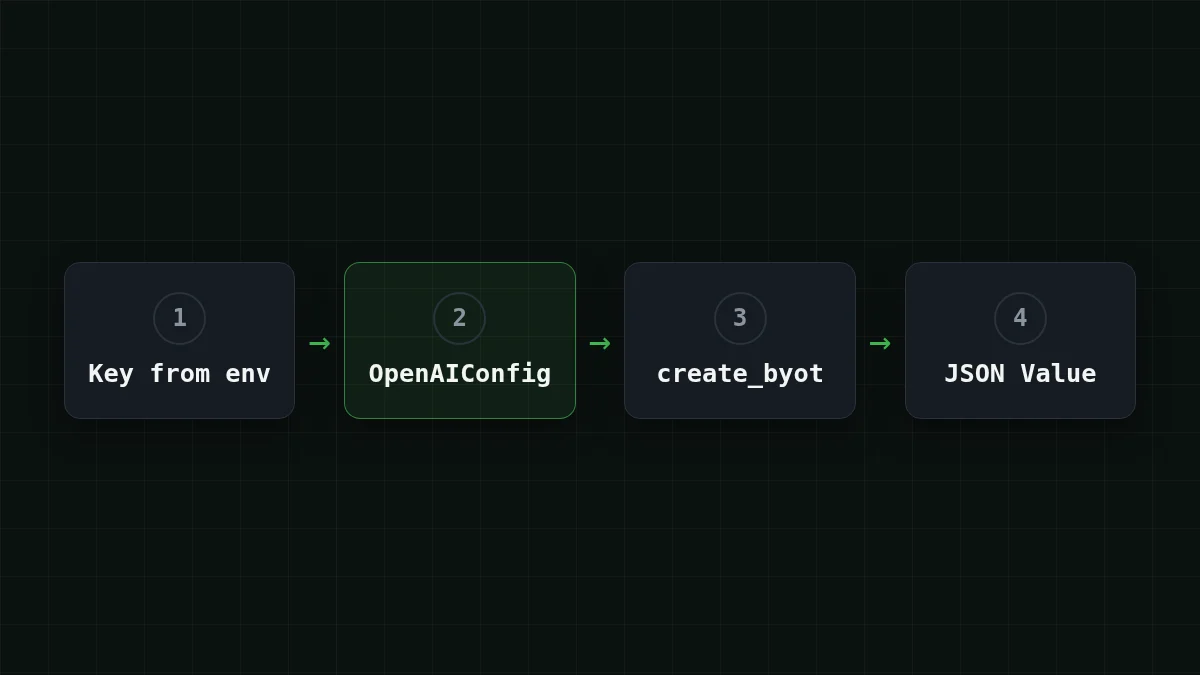
要在 Rust 中用 async-openai 调用 CheapTokens,先用基础 URL https:/ 和你的密钥构建一个 OpenAIConfig,然后用 create_byot 和 JSON 请求体发送请求。回复文本和 token 计数从返回的 JSON 中取出。这大约 25 行代码,而且只要改一个字符串,同一个程序就能用于 CheapTokens 模型页面上的任何模型。
该 crate 的 docs.rs 页面(2026 年 11 月 8 日查看)在 MIT 许可证下列出 0.43.0 版本,本指南遵循的就是这个版本。
为什么用 create_byot 而不是类型化请求#
async-openai 通常提供类型化的请求构建器:你填充一个结构体,它返回一个结构体。这很舒服,直到网关返回了结构体不认识的字段。byot 特性("自带类型")增加了 *_byot 方法,可以接受任意 JSON 请求体,并返回任何你能反序列化成的类型,包括普通的 serde_。
对于第一个请求,这正是你想要的。你写与 curl 调用中相同的 JSON,然后直接从响应中读取 usage,无需查找类型。
设置项目#
分步操作
创建项目并设置密钥
添加 crate
在一个新项目(cargo new cheaptokens-)中,添加三个依赖。async-openai 在这里需要两个特性:byot 用于 create_byot 方法,chat-completion 用于 chat 部分。
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
将密钥放入环境变量
在你的 CheapTokens 账户中创建密钥,并让它远离源代码。如果你想看详细版本,请参阅如何安全地存储 API 密钥。
export CHEAPTOKENS_API_KEY="paste-your-key-here"在 Windows PowerShell 中,同一行是 $env:CHEAPTOKENS_。
运行程序
将下一节的代码粘贴到 src/main.rs 中并启动它。
cargo run程序#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}三行代码承载了整个思路。with_api_base 是 CheapTokens 接入的地方:基础 URL 以 /v1 结尾,async-openai 会自己添加端点路径。with_api_key 接收我们从环境变量中读取的值。而 model 是完整 id deepseek-——价格表中的短名称不被 API 接受。
用缺失的键索引 Value 会得到 null 而不是 panic,因此字段名拼写错误会在输出中显示为 null,而不是崩溃。这在探索响应时很方便。
返回什么#
网关使用 OpenAI Chat Completions 格式,因此响应具有通常的结构(此处已裁剪,... 标记我们跳过的字段):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
usage 中的数字是你请求的真实计数,因此运行时会替换掉零。prompt_tokens 是你发送的内容,completion_ 是模型写出的内容。它们按不同价格计费,这正是打印它们的目的。如果这个区别对你来说很新鲜,输入 vs 输出 token 用五分钟解释了它。
自己试试试试看:将 "max_tokens" 设为 5 并再次运行。finish_reason 说什么?显示答案
在 OpenAI Chat Completions 格式中,它说 length。模型达到了你的上限,句子在中途被截断。正常回答时它说 stop。如果你在真实任务中看到 length,请提高 max_tokens——这篇文章涵盖了修复方法。
一次请求的成本#
假设你在循环中运行这个调用,输入一个小问题,输出一个简短回答:每次 300 个输入 token 和 200 个输出 token。在 DeepSeek-V4-Flash 上,每次请求是 $0.000025,基于每 1M 输入 token $0.015 和每 1M 输出 token $0.10 的实时价格。输入和输出合计,这比 OpenRouter 便宜,而且该模型保持 380K 上下文,最多回答 32,768 个 token。
下表显示了每个模型上的相同请求,乘以 1,000。
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
每次请求 300 个输入 token 和 200 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
价格在定价页面上。
切换模型#
模型改变时代码不变;只有 "model" 中的字符串改变。例如,zai- 有 390K 上下文,最多回答 8,192 个 token。要完全避免编辑代码,可以用 std::env::var("CHEAPTOKENS_ 从第二个变量读取 id。如果你不确定你的密钥能看到哪些 id,请用 GET /v1/models 列出模型。
如果它不工作#
- 一开始就出现
environment variable not found:密钥没有在这个终端中导出。在运行cargo run的同一个窗口中再次导出它。 - API 返回 401 错误:密钥错误,或者周围有多余的空格或引号。
- 404 错误:检查基础 URL 是否以
/v1结尾,以及模型 id 是否是完整的,带有deepseek-ai/前缀。API 401 或 404:密钥、基础 URL、模型 id 会逐步说明。 - 编译器找不到
create_byot:byot特性未启用。再次运行设置中的cargo add行。
对于不属于上述任何情况的连接问题,请参阅常见连接错误。
同样的第一个请求也存在于其他语言中:Go 和 Ruby。有关 API 本身的更多信息,请打开 CheapTokens 文档。


