API และ SDKคู่มือ
คำขอแรกใน Rust ด้วย async-openai: base URL, คีย์, การใช้งาน
โปรแกรม Rust ขนาดเล็กที่ใช้ tokio และ async-openai ส่ง chat completion หนึ่งครั้งไปยัง CheapTokens และพิมพ์คำตอบพร้อมจำนวนโทเค็น
ในหน้านี้
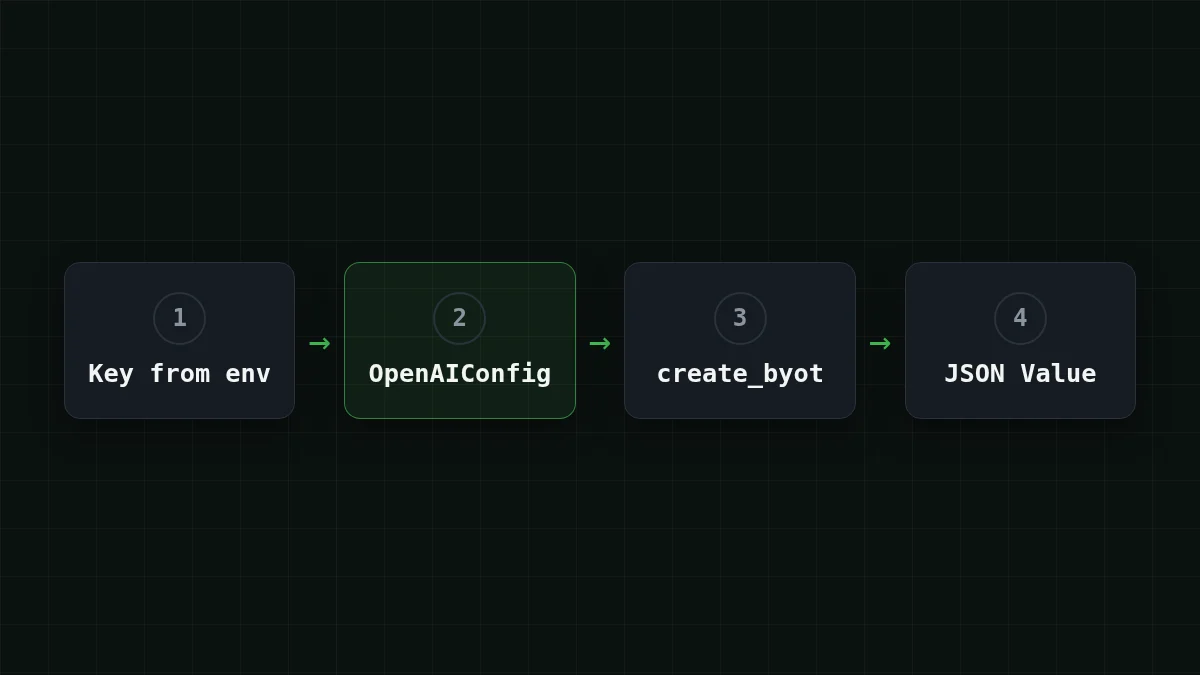
หากต้องการเรียก CheapTokens จาก Rust ด้วย async-openai ให้สร้าง OpenAIConfig ด้วย base URL https:/ และคีย์ของคุณ จากนั้นส่งคำขอด้วย create_byot และ body แบบ JSON ข้อความตอบกลับและจำนวนโทเค็นจะออกมาจาก JSON ที่ส่งกลับมา นั่นคือโค้ดประมาณ 25 บรรทัด และโปรแกรมเดียวกันใช้ได้กับโมเดลใดก็ได้บน หน้าโมเดลของ CheapTokens เมื่อคุณเปลี่ยนสตริงเพียงหนึ่งตัว
หน้า docs.rs ของ crate นี้ (ตรวจสอบเมื่อ 8 พฤศจิกายน 2026) ระบุเวอร์ชัน 0.43.0 ภายใต้สัญญาอนุญาต MIT และนั่นคือเวอร์ชันที่คู่มือนี้ใช้
ทำไมใช้ create_byot แทนคำขอแบบมีชนิด#
โดยปกติ async-openai ให้ตัวสร้างคำขอแบบมีชนิด: คุณเติม struct แล้วมันให้ struct กลับมา สะดวกจนกระทั่งเกตเวย์ส่งฟิลด์ที่ struct ไม่รู้จัก ฟีเจอร์ byot ("bring your own types") เพิ่มเมธอด *_byot ที่รับ body JSON ใดก็ได้และคืนชนิดใดก็ได้ที่คุณ deserialize ได้ รวมถึง serde_ ธรรมดา
สำหรับคำขอแรก นั่นคือสิ่งที่คุณต้องการพอดี คุณเขียน JSON แบบเดียวกับที่คุณจะใส่ในคำสั่ง curl และอ่าน usage ตรงจาก response โดยไม่ต้องค้นหาชนิด
ตั้งค่าโปรเจกต์#
ทีละขั้นตอน
สร้างโปรเจกต์และตั้งค่าคีย์
เพิ่ม crate
ในโปรเจกต์ใหม่ (cargo new cheaptokens-) เพิ่ม dependency สามตัว async-openai ต้องการสองฟีเจอร์ที่นี่: byot สำหรับเมธอด create_byot และ chat-completion สำหรับส่วน chat
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
ใส่คีย์ในตัวแปรสภาพแวดล้อม
สร้างคีย์ในบัญชี CheapTokens ของคุณและเก็บไว้ให้พ้นจากซอร์สโค้ด หากต้องการเวอร์ชันยาว ดู วิธีเก็บ API key อย่างปลอดภัย
export CHEAPTOKENS_API_KEY="paste-your-key-here"บน Windows PowerShell บรรทัดเดียวกันคือ $env:CHEAPTOKENS_
รันโปรแกรม
วางโค้ดจากส่วนถัดไปลงใน src/main.rs แล้วเริ่มทำงาน
cargo runโปรแกรม#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
สามบรรทัดแบกแนวคิดทั้งหมด with_api_base คือจุดที่ CheapTokens เข้ามา: base URL ลงท้ายด้วย /v1 และ async-openai เติมพาธ endpoint เอง with_api_key รับค่าที่เราอ่านจากสภาพแวดล้อม และ model คือ id เต็ม deepseek- — ชื่อสั้นจากตารางราคาไม่ได้รับการยอมรับจาก API
การ index Value ด้วยคีย์ที่ไม่มีอยู่จะให้ null แทนการ panic ดังนั้นการพิมพ์ผิดในชื่อฟิลด์จะแสดงเป็น null ในเอาต์พุตแทนที่จะพัง สะดวกเมื่อคุณกำลังสำรวจ response
สิ่งที่ส่งกลับมา#
เกตเวย์พูดรูปแบบ OpenAI Chat Completions ดังนั้น response จึงมีรูปร่างตามปกติ (ตัดมาเฉพาะส่วนนี้ เครื่องหมาย ... คือฟิลด์ที่เราข้าม):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
ตัวเลขใน usage คือจำนวนจริงสำหรับคำขอของคุณ ดังนั้นมันจะแทนที่ศูนย์เมื่อคุณรัน prompt_tokens คือสิ่งที่คุณส่งไป completion_ คือสิ่งที่โมเดลเขียน พวกมันถูกคิดราคาต่างกัน ซึ่งเป็นจุดประสงค์ของการพิมพ์ออกมา หากความแตกต่างนี้เป็นเรื่องใหม่สำหรับคุณ input vs output tokens อธิบายได้ในห้านาที
ลองด้วยตัวเองลองดู: ตั้ง "max_tokens" เป็น 5 แล้วรันอีกครั้ง finish_reason พูดว่าอะไร?แสดงคำตอบ
ในรูปแบบ OpenAI Chat Completions มันบอกว่า length โมเดลชนเพดานของคุณและประโยคถูกตัดกลางคัน ด้วยคำตอบปกติมันบอกว่า stop หากคุณเห็น length ในงานจริง ให้เพิ่ม max_tokens — บทความนี้ ครอบคลุมวิธีแก้
หนึ่งคำขอมีค่าใช้จ่ายเท่าไร#
สมมติคุณรันการเรียกนี้ในลูป คำถามเล็กเข้าและคำตอบสั้นออก: 300 input tokens และ 200 output tokens ต่อครั้ง บน DeepSeek-V4-Flash นั่นคือ $0.000025 ต่อคำขอ จากราคาสดที่ $0.015 ต่อ 1M input tokens และ $0.10 ต่อ 1M output tokens เมื่อนับรวมกันทั้ง input และ output นั่นถูกกว่า OpenRouter และโมเดลยังคงบริบท 380K และตอบได้ถึง 32,768 tokens
ตารางด้านล่างแสดงคำขอเดียวกันบนทุกโมเดล คูณ 1,000
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 โทเค็นอินพุตและ 200 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ราคาอยู่บน หน้าราคา
การสลับโมเดล#
โค้ดไม่เปลี่ยนเมื่อโมเดลเปลี่ยน มีเพียงสตริงใน "model" เท่านั้น ตัวอย่างเช่น zai- มีบริบท 390K และตอบได้ถึง 8,192 tokens เพื่อหลีกเลี่ยงการแก้โค้ดเลย ให้อ่าน id จากตัวแปรที่สองด้วย std::env::var("CHEAPTOKENS_ หากคุณไม่แน่ใจว่าคีย์ของคุณเห็น id ใดบ้าง แสดงรายการโมเดลด้วย GET /v1/models
หากมันไม่ทำงาน#
environment variable not foundตั้งแต่เริ่มต้น: คีย์ไม่ได้ export ในเทอร์มินัลนี้ export อีกครั้งในหน้าต่างเดียวกับที่คุณรันcargo run- ข้อผิดพลาด 401 จาก API: คีย์ผิดหรือมีช่องว่างหรือเครื่องหมายคำพูดเกินมา
- ข้อผิดพลาด 404: ตรวจสอบว่า base URL ลงท้ายด้วย
/v1และ model id เป็นแบบเต็มที่มีคำนำหน้าdeepseek-ai/API 401 หรือ 404: คีย์, base URL, model id อธิบายทีละขั้น - คอมไพเลอร์หา
create_byotไม่เจอ: ฟีเจอร์byotไม่ได้เปิดใช้งาน รันบรรทัดcargo addจากขั้นตอนตั้งค่าอีกครั้ง
สำหรับปัญหาการเชื่อมต่อที่ไม่ใช่กรณีเหล่านี้ ดู ข้อผิดพลาดการเชื่อมต่อที่พบบ่อย
คำขอแรกแบบเดียวกันมีสำหรับภาษาอื่น: Go และ Ruby สำหรับข้อมูลเพิ่มเติมเกี่ยวกับ API เอง เปิด เอกสาร CheapTokens


