API และ SDKคู่มือ
คำขอแรกใน Go ด้วย openai-go: base URL, คีย์, usage
โปรแกรม Go ที่สมบูรณ์ซึ่งเรียกโมเดล CheapTokens ผ่าน openai-go และพิมพ์คำตอบ finish_reason และการใช้โทเค็น พร้อมการลองใหม่และไทม์เอาต์
ในหน้านี้
คุณมีโค้ด Go ที่คุยกับ API สไตล์ OpenAI อยู่แล้ว หรือกำลังจะเขียนขึ้นมา หากต้องการส่งไปที่ CheapTokens คุณเพียงเปลี่ยนสองออปชันบนไคลเอนต์และสตริงหนึ่งตัว คือ model id ตัว SDK ยังคงเดิม: แพ็กเกจ openai-go อย่างเป็นทางการ เวอร์ชัน v3
ด้านล่างคือโปรแกรมทั้งหมด จากนั้นคือสิ่งที่แต่ละบรรทัดทำ วิธีอ่านคำตอบและจำนวนโทเค็น และวิธีป้องกันไม่ให้คำขอที่ค้างไปทำให้บริการของคุณค้าง เวอร์ชันตรวจสอบกับ README ของ openai-go เมื่อวันที่ 3 พฤศจิกายน 2026: แท็ก ล่าสุดบนหน้านั้นคือ v3.91.1 และต้องใช้ Go 1.26 ขึ้นไป
สิ่งที่ต้องมีก่อนเริ่ม#
- Go 1.26 ขึ้นไป บน Go 1.25 ให้ปัก
v3.74.0; บน Go 1.22–1.24 ให้ปักv3.44.0(README ระบุว่าไลน์เก่าไม่ได้รับการรับประกันว่าจะมีแพตช์) - API key ของ CheapTokens เก็บไว้ในตัวแปรสภาพแวดล้อม ไม่ใช่ในไฟล์ซอร์ส
- ที่อยู่ API:
https:/รองรับรูปแบบ OpenAI Chat Completions ดังนั้น openai-go ใช้งานได้โดยไม่ต้องมีตัวห่อ เอกสาร มีที่อยู่เดียวกันและหน้ากุญแจ/ api. cheaptokens. dev/ v1 - model id เราใช้
deepseek-: คอนเท็กซ์ 380K และสูงสุด 32,768 โทเค็นในหนึ่งคำตอบ ใช้ id แบบเต็ม; ชื่อย่อจากตารางราคาจะไม่ถูกยอมรับโดย APIai/ DeepSeek- V4- Flash- 0731
ทีละขั้นตอน
ตั้งค่าโปรเจกต์
ติดตั้ง SDK
ในโฟลเดอร์ว่าง:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
พาธนำเข้าคือ github. ชื่อแพ็กเกจคือ openai
ใส่คีย์ในสภาพแวดล้อม
export CHEAPTOKENS_API_KEY="paste-your-key-here"บน Windows PowerShell: $env:CHEAPTOKENS_ ตัวยึดตำแหน่งไม่ใช่คีย์จริง
สร้าง main.go และรัน
วางโปรแกรมจากส่วนถัดไปลงใน main.go จากนั้นรัน go run .
โปรแกรมทั้งหมด#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}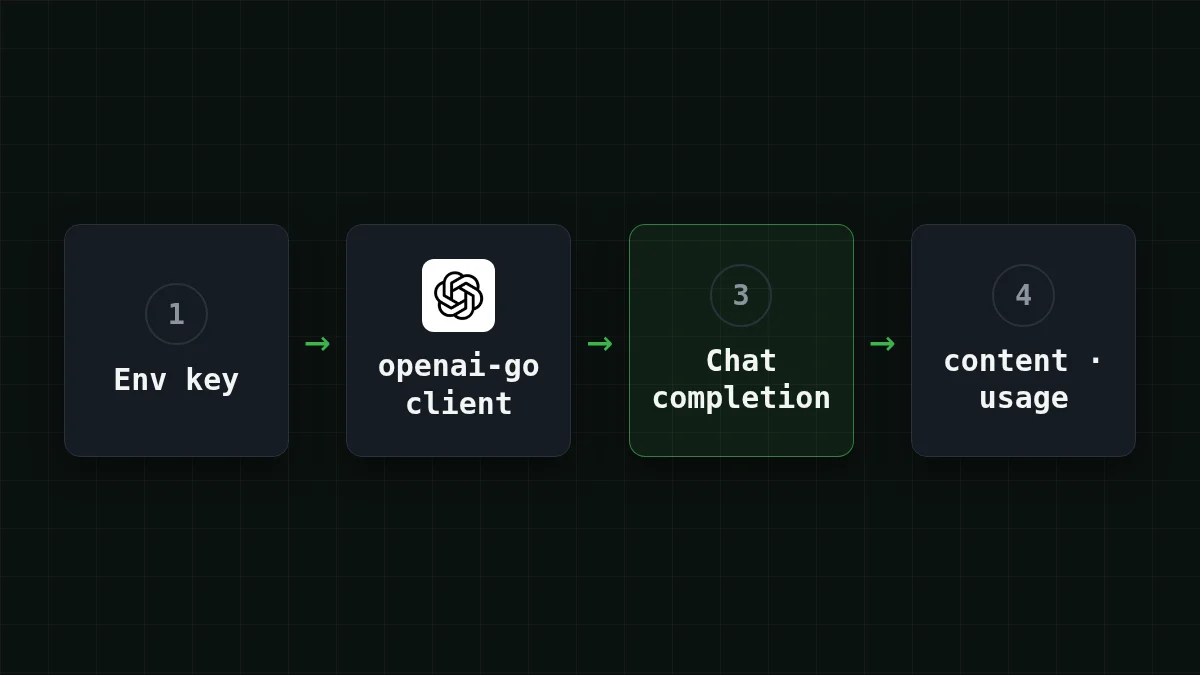
ส่วนที่สำคัญ:
option.เป็นบรรทัดเดียวที่ย้าย SDK จาก OpenAI ไปยัง CheapTokens ใช้ที่อยู่ให้ตรงกับในเอกสารWithBaseURL(. . . ) option.ส่งคีย์อย่างชัดเจน หากไม่มี ไคลเอนต์จะอ่านWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEYซึ่งมีประโยชน์เมื่อคุณพอร์ตโค้ดเดิม: ตั้งค่าตัวแปรนั้นเป็นคีย์ CheapTokens แล้วโค้ดไม่ต้องเปลี่ยนคีย์ เช่นเดียวกับOPENAI_BASE_URLแต่WithBaseURLที่ระบุชัดเจนจะเขียนทับ ดังนั้นจึงไม่มีเรื่องเซอร์ไพรส์หากมีทั้งสองModelเป็นสตริงธรรมดาใน SDK (ChatModelเป็นนามแฝงของstring) ดังนั้น model id ใดก็ใช้ได้ ไม่ใช่แค่ค่าคงที่ที่ README แสดงopenai.คือหนึ่งเทิร์นของผู้ใช้ ตัวอย่างใน README ใช้UserMessage(. . . ) DeveloperMessageและค่าคงที่ GPT; ที่นี่ข้อความของผู้ใช้และ id แบบสตริงก็เพียงพอ
อ่านคำตอบ finish_reason และ usage#
ทั้งสามมาจากฟิลด์ที่ SDK แยกวิเคราะห์ให้แล้ว:
resp.คือข้อความ (Choices[0]. Message. Content string)resp.ก็เป็นChoices[0]. FinishReason stringเช่นกันstopหมายความว่าโมเดลจบเอง;lengthหมายความว่าคำตอบชนขีดจำกัดโทเค็นและถูกตัด หากคุณเห็นlengthอ่าน ทำไมคำตอบจึงหยุดกลางประโยคresp.Usageเก็บPromptTokens(สิ่งที่คุณส่ง),CompletionTokens(สิ่งที่โมเดลเขียน) และTotalTokensทั้งหมดเป็นint64
ผลลัพธ์จะมีลักษณะเช่นนี้: คำตอบ จากนั้น finish_reason: พร้อมค่า แล้วจำนวนโทเค็นสามค่า ตัวเลขจะต่างกันในทุกการรัน ดังนั้นให้บันทึกไว้ เป็นสิ่งที่คุณจ่าย และโทเค็นเอาต์พุตเป็นฝั่งที่แพงกว่า
ลองด้วยตัวเองลองดู: อะไรเปลี่ยนไปหากสลับโมเดล?แสดงคำตอบ
เปลี่ยนสตริง Model เป็น zai- แล้วรันอีกครั้ง ไม่มีอย่างอื่นในโปรแกรมเปลี่ยน ข้อความคำตอบและตัวเลข usage สามค่าจะต่างกัน ซึ่งเป็นวิธีที่เร็วที่สุดในการเปรียบเทียบสองโมเดลบนพรอมป์ของคุณเอง GLM-5.3-Flash มีคอนเท็กซ์ 390K และสูงสุด 8,192 โทเค็นในหนึ่งคำตอบ
การลองใหม่และไทม์เอาต์: ขีดจำกัดสามแบบที่ต่างกัน#
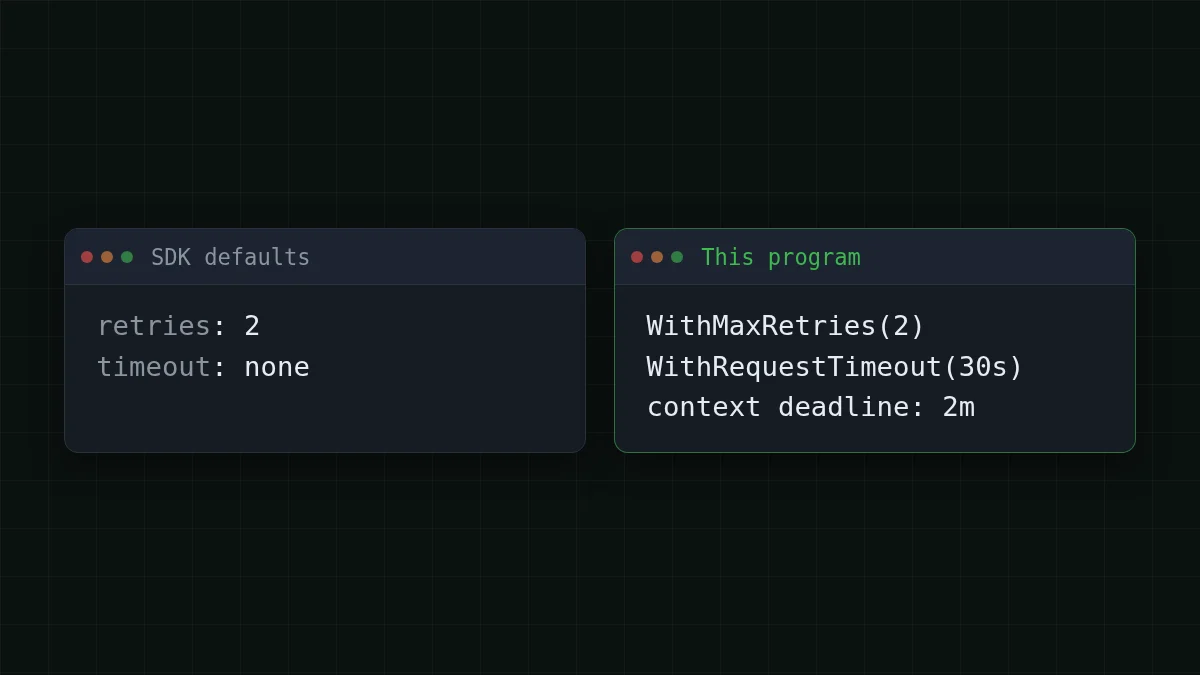
นี่คือจุดที่บริการ Go มักเจ็บปวด: โดยค่าเริ่มต้น SDK ไม่มีไทม์เอาต์เลย ดังนั้นการเชื่อมต่อที่หยุดชะงักอาจรอตลอดไป การตั้งค่าสามอย่างแก้ปัญหานี้ และทำงานในระดับที่ต่างกัน:
option.: SDK ลองใหม่เมื่อเกิดข้อผิดพลาดการเชื่อมต่อ, 408, 409, 429 และ 5xx โดยรอแบบเอ็กซ์โพเนนเชียลสั้น ๆ สองครั้งเป็นค่าเริ่มต้นอยู่แล้ว;WithMaxRetries(2) 0ปิดการลองใหม่ คุณสามารถตั้งบนไคลเอนต์ หรือบนการเรียกครั้งเดียวoption.: ขีดจำกัดสำหรับหนึ่งความพยายามWithRequestTimeout(30*time. Second) - เดดไลน์ของ
context: ขีดจำกัดสำหรับการเรียกทั้งหมด รวมถึงการลองใหม่และการรอ
ดังนั้นด้วยการลองใหม่ 2 ครั้งจึงมีความพยายามได้ถึง 3 ครั้ง: 3 × 30 = 90 วินาทีของการรอในกรณีเลวร้ายที่สุด บวกกับการหยุดพักสั้น ๆ ระหว่างความพยายาม คอนเท็กซ์สองนาทีครอบคลุมได้ หากคุณต้องการกฎเข้มงวดให้ตอบภายใน 20 วินาทีสำหรับเว็บแฮนด์เลอร์ ให้ย่อคอนเท็กซ์ ไม่ใช่แค่ไทม์เอาต์ต่อความพยายาม
สำหรับพื้นหลังที่ยาวขึ้นในการเลือกตัวเลขเหล่านี้ เวอร์ชัน Python ของคำแนะนำเดียวกันอยู่ใน OpenAI Python SDK timeout and retries ตรรกะใช้ได้กับ Go
การเรียกพันครั้งแบบนี้มีค่าใช้จ่ายเท่าไร#
สมมติคุณรันบริการเล็ก ๆ ที่ทำ 1,000 คำขอต่อวัน แต่ละครั้งมีอินพุตประมาณ 800 โทเค็นและเอาต์พุต 300 โทเค็น บน deepseek- วันนั้นมีค่าใช้จ่าย $0.042 (1,000 × 800 โทเค็นอินพุต, 1,000 × 300 โทเค็นเอาต์พุต) ตารางแสดงภาระเดียวกันในโมเดลของเรา; นับรวม อินพุตและเอาต์พุตรวมกัน ถูกกว่า OpenRouter
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 โทเค็นอินพุตและ 300 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ใส่ตัวเลขของคุณเอง การรันครั้งแรกจะพิมพ์ PromptTokens และ CompletionTokens จริง ดังนั้นคุณไม่ต้องเดาค่าเฉลี่ย:
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวันของบริการ Go ขนาดเล็ก
โทเค็นอินพุตต่อคำขอ: 800 · โทเค็นเอาต์พุตต่อคำขอ: 300 · คำขอต่อวัน: 1,000
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
ราคาบนหน้าราคา และหน้ารุ่น เป็นแบบเรียลไทม์และใช้ราคาคงที่หนึ่งราคาต่อโมเดล โดยไม่มีช่วงพีค
หากใช้งานไม่ได้#
- ข้อผิดพลาดกล่าวถึง 401: คีย์ว่างหรือผิด
os.Getenvคืนสตริงว่างสำหรับตัวแปรที่ไม่ได้ตั้งค่า ดังนั้นตรวจสอบecho $CHEAPTOKENS_ในเทอร์มินัลเดียวกับที่คุณรันAPI_ KEY go run . - ข้อผิดพลาดกล่าวถึง 404 หรือโมเดลไม่รู้จัก: id คัดลอกมาให้ครบ พร้อมคำนำหน้า
deepseek-ai/คุณสามารถแสดงรายการ id ได้ในการเรียกแสดงรายการโมเดล go: module requires Go 1.: toolchain ของคุณเก่าเกินไป ปักแท็ก SDK เก่าตามที่แสดงด้านบน26 - การเรียกค้างแล้วล้มเหลว: นั่นคือไทม์เอาต์ทำงาน ตรวจสอบเส้นทางเครือข่ายก่อน จากนั้นเพิ่ม
WithRequestTimeoutหากโมเดลต้องการเวลามากขึ้นจริง ๆ สำหรับคำตอบยาว
หากแนวคิด base URL เป็นเรื่องใหม่สำหรับคุณ base_url คืออะไรและวิธีสลับ อธิบายโดยไม่มีโค้ด


