API at SDKGabay
Unang request sa Go gamit ang openai-go: base URL, key, usage
Isang kumpletong Go program na tumatawag sa isang CheapTokens model sa pamamagitan ng openai-go at nagpi-print ng sagot, finish_reason at token usage, na may retries at timeout.
Sa pahinang ito
Mayroon ka nang Go code na nakikipag-usap sa isang OpenAI-style API, o malapit mo nang magsulat ng ilan. Para ipadala ito sa CheapTokens, babaguhin mo ang dalawang option sa client at isang string, ang model id. Pareho pa rin ang SDK: ang opisyal na openai-go package, v3.
Nasa ibaba ang buong programa, pagkatapos ay kung ano ang ginagawa ng bawat linya, paano basahin ang sagot at ang mga token count, at paano pigilan ang isang stuck na request na mag-hang sa iyong service. Ang mga bersyon ay sinuri laban sa openai-go README noong 3 Nobyembre 2026: ang pinakabagong tag sa pahinang iyon ay v3.91.1, at nangangailangan ito ng Go 1.26 o mas bago.
Ano ang kailangan mo bago magsimula#
- Go 1.26 o mas bago. Sa Go 1.25 i-pin ang
v3.74.0; sa Go 1.22–1.24 i-pin angv3.44.0(sinasabi ng README na ang mas lumang linya ay walang garantisadong pag-aayos). - Isang CheapTokens API key. Itago ito sa isang environment variable, hindi sa source file.
- Ang API address:
https:/. Nagsasalita ito ng OpenAI Chat Completions format, kaya gumagana ang openai-go nang walang wrapper. Ang docs ay may parehong address at ang key page./ api. cheaptokens. dev/ v1 - Isang model id. Gagamitin namin ang
deepseek-: 380K context at hanggang 32,768 tokens sa isang sagot. Gamitin ang buong id; ang maikling pangalan mula sa price tables ay hindi tinatanggap ng API.ai/ DeepSeek- V4- Flash- 0731
Hakbang-hakbang
I-set up ang proyekto
I-install ang SDK
Sa isang walang laman na folder:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Ang import path ay github., ang pangalan ng package ay openai.
Ilagay ang key sa environment
export CHEAPTOKENS_API_KEY="paste-your-key-here"Sa Windows PowerShell: $env:CHEAPTOKENS_. Ang placeholder ay hindi isang tunay na key.
Gumawa ng main.go at patakbuhin ito
I-paste ang programa mula sa susunod na seksyon sa main.go, pagkatapos ay patakbuhin ang go run ..
Ang buong programa#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
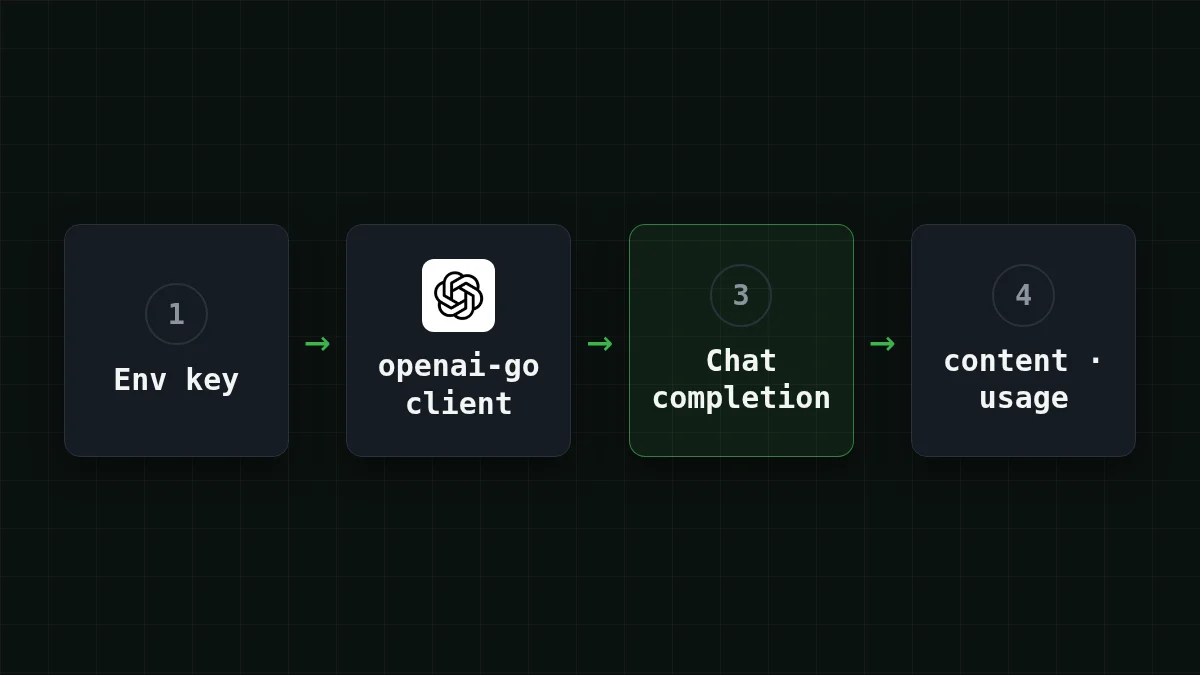
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
Ang mga mahalagang bahagi:
- Ang
option.ay ang tanging linya na naglilipat sa SDK mula OpenAI patungong CheapTokens. Gamitin ang address nang eksakto tulad ng nasa docs.WithBaseURL(. . . ) - Ang
option.ay nagpapasa ng key nang tahasan. Kung wala ito, binabasa ng client angWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, na kapaki-pakinabang kapag nag-port ka ng umiiral na code: itakda ang variable na iyon sa isang CheapTokens key at hindi na kailangang baguhin ang key sa code. Ganoon din saOPENAI_BASE_URL, ngunit ang tahasangWithBaseURLay nangingibabaw dito, kaya walang sorpresa kung pareho ang umiiral. - Ang
Modelay isang plain string sa SDK (angChatModelay alias ngstring), kaya gumagana ang anumang model id, hindi lamang ang mga constant na ipinapakita ng README. - Ang
openai.ay isang user turn. Ang halimbawa sa README ay gumagamit ngUserMessage(. . . ) DeveloperMessageat isang GPT constant; dito sapat na ang isang user message at isang string id.
Basahin ang sagot, finish_reason at usage#
Tatlo silang lahat ay nagmumula sa mga field na agad na pinaparse ng SDK para sa iyo:
- Ang
resp.ay ang teksto (isangChoices[0]. Message. Content string). - Ang
resp.ay isa ringChoices[0]. FinishReason string. Angstopay nangangahulugang natapos ng modelo nang kusa; anglengthay nangangahulugang naabot ng sagot ang token limit at naputol. Kung makita mo anglength, basahin ang bakit napuputol ang isang sagot sa gitna ng pangungusap. - Ang
resp.Usageay naglalaman ngPromptTokens(ang ipinadala mo),CompletionTokens(ang isinulat ng modelo) atTotalTokens, lahatint64.
Magiging ganito ang output: ang sagot, pagkatapos ay finish_reason: na may value, pagkatapos ay tatlong token count. Nag-iiba ang mga numero sa bawat run, kaya i-log ang mga ito. Sila ang binabayaran mo, at ang output tokens ang mas mahal na bahagi.
Subukan mo mismoSubukan: ano ang magbabago kung papalitan mo ang modelo?Ipakita ang sagot
Palitan ang Model string ng zai- at patakbuhin muli. Walang ibang gumagalaw sa programa. Mag-iiba ang teksto ng sagot at ang tatlong numero ng usage, na siyang pinakamabilis na paraan upang ihambing ang dalawang modelo sa sarili mong prompt. Ang GLM-5.3-Flash ay may 390K context at hanggang 8,192 tokens sa isang sagot.
Retries at timeouts: tatlong magkaibang limitasyon#
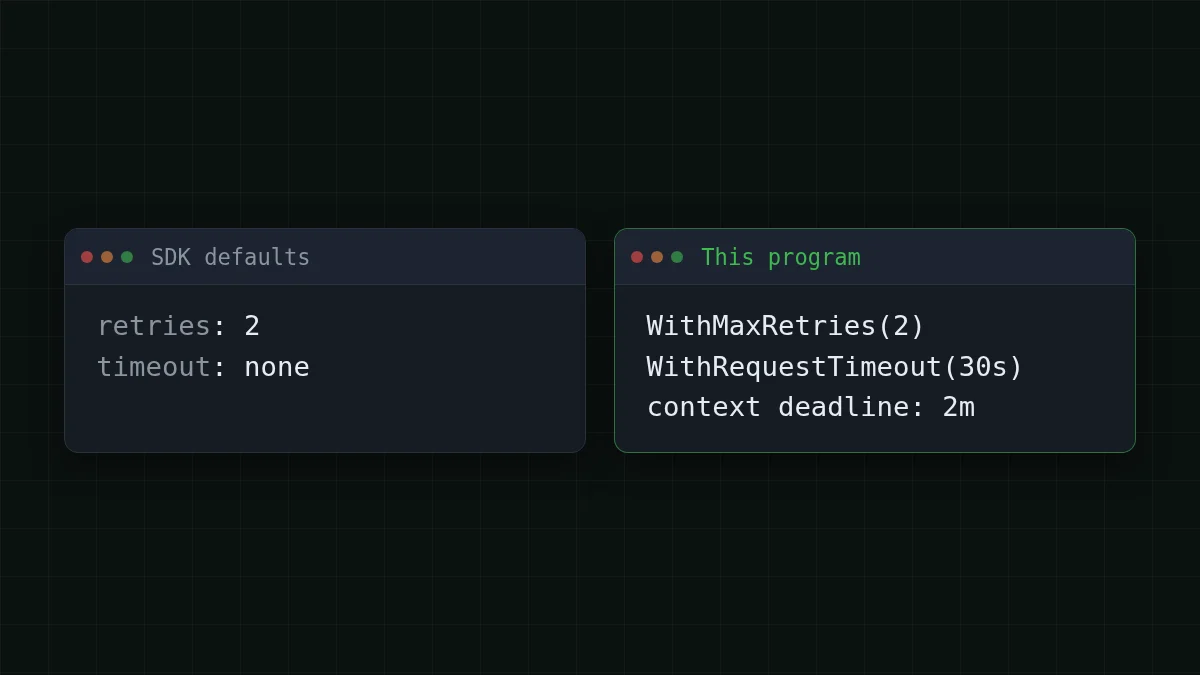
Dito karaniwang nasasaktan ang mga Go service: bilang default, ang SDK ay walang timeout, kaya ang isang stalled na koneksyon ay maaaring maghintay nang walang hanggan. Tatlong setting ang nag-aayos nito, at gumagana sila sa magkaibang antas:
option.: inuulit ng SDK ang mga connection error, 408, 409, 429 at 5xx na may maikling exponential na paghihintay. Dalawang retry na ang default; angWithMaxRetries(2) 0ay nagpapatay ng retries. Maaari mong itakda ito sa client, o sa isang tawag lamang.option.: ang limitasyon para sa isang pagtatangka.WithRequestTimeout(30*time. Second) - Ang
contextdeadline: ang limitasyon para sa buong tawag, kasama ang retries at paghihintay.
Kaya sa 2 retries, maaaring may hanggang 3 pagtatangka: 3 × 30 = 90 segundo ng paghihintay sa pinakamasama, kasama ang maiikling paghinto sa pagitan ng mga pagtatangka. Sinasaklaw ito ng dalawang minutong context. Kung gusto mo ng mahigpit na panuntunang sagot-sa-loob-ng-20-segundo para sa isang web handler, paikliin ang context, hindi lamang ang per-attempt timeout.
Para sa mas mahabang background sa pagpili ng mga numerong ito, ang Python na bersyon ng parehong payo ay nasa OpenAI Python SDK timeout and retries. Naaangkop din ang lohika sa Go.
Magkano ang isang libo ng mga tawag na ito#
Sabihin nating nagpapatakbo ka ng maliit na service na gumagawa ng 1,000 request bawat araw, bawat isa ay may mga 800 input tokens at 300 output tokens. Sa deepseek-, ang araw na iyon ay nagkakahalaga ng $0.042 (1,000 × 800 input tokens, 1,000 × 300 output tokens). Ipinapakita ng table ang parehong load sa aming mga modelo; kung bibilangin sa kabuuan, kasama ang input at output, mas mura ito kaysa OpenRouter.
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 input at 300 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ipasok ang sarili mong mga numero. Ang unang run mo ay magpi-print ng tunay na PromptTokens at CompletionTokens, kaya hindi mo kailangang hulaan ang average:
Calculator ng gastos
Isang araw ng isang maliit na Go service
Mga input token bawat kahilingan: 800 · Mga output token bawat kahilingan: 300 · Mga kahilingan bawat araw: 1,000
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Ang mga presyo sa pricing page at models page ay live at gumagamit ng isang fixed na presyo bawat modelo, na walang peak hours.
Kung hindi ito gumana#
- Binabanggit ng error ang 401: ang key ay walang laman o mali. Ang
os.Getenvay nagbabalik ng empty string para sa isang unset na variable, kaya suriin angecho $CHEAPTOKENS_sa parehong terminal kung saan mo pinapatakbo angAPI_ KEY go run .. - Binabanggit ng error ang 404 o isang hindi kilalang modelo: ang id. Kopyahin ito nang buo, kasama ang
deepseek-ai/prefix. Maaari mong ilista ang mga id sa the models list call. go: module requires Go 1.: mas luma ang iyong toolchain. I-pin ang isang mas lumang SDK tag tulad ng ipinapakita sa itaas.26 - Nag-hang ang tawag at pagkatapos ay nabigo: iyon ang timeout na gumagawa ng trabaho nito. Suriin muna ang network path, pagkatapos ay taasan ang
WithRequestTimeoutkung talagang kailangan ng modelo ng mas maraming oras para sa isang mahabang sagot.
Kung bago sa iyo ang ideya ng base URL, ipinapaliwanag ng what base_url is and how to switch ito nang walang code.


