APIとSDKガイド
openai-goでGoの最初のリクエスト: base URL、キー、usage
openai-go経由でCheapTokensのモデルを呼び出し、回答、finish_reason、トークン使用量を出力する完全なGoプログラム。リトライとタイムアウト付き。
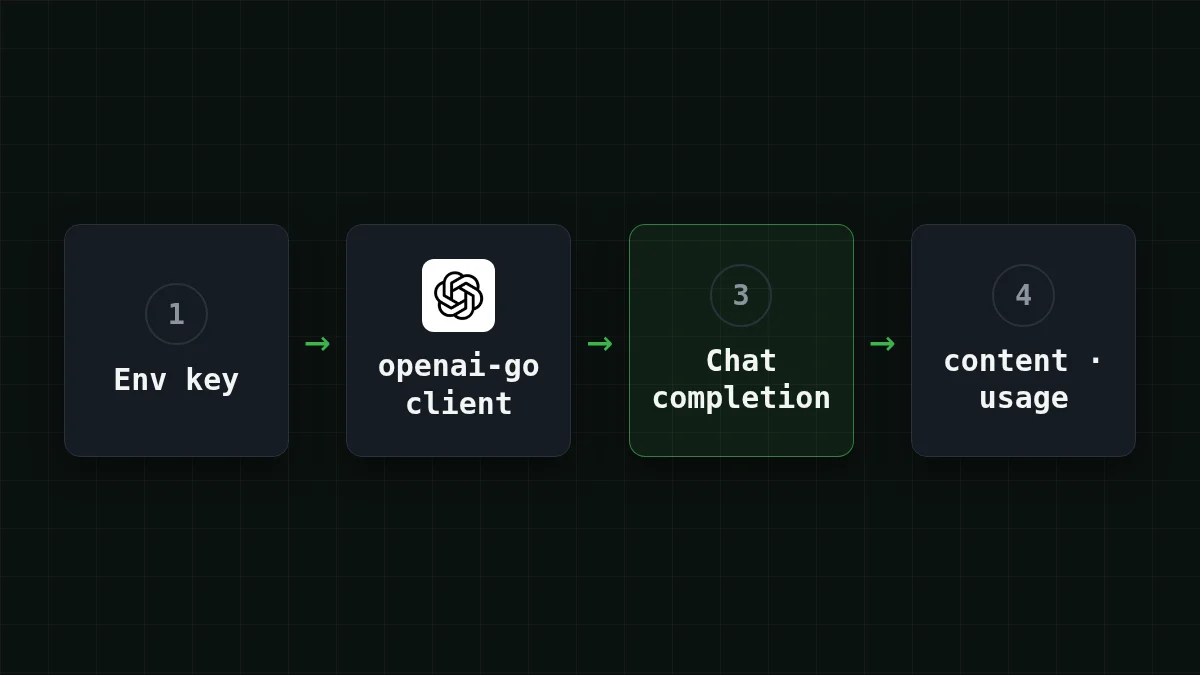
このページの内容
OpenAI形式のAPIと通信するGoコードがすでにあるか、これから書こうとしているはずです。CheapTokensに送るには、クライアントの2つのオプションと1つの文字列、つまりモデルIDを変更するだけです。SDKは同じまま、公式のopenai-goパッケージv3を使います。
以下ではプログラム全体を示し、その後に各行の役割、回答とトークン数の読み方、そして詰まったリクエストでサービスがハングしないようにする方法を説明します。バージョンは2026年11月3日時点のopenai-go READMEで確認しています。そのページの最新タグはv3.91.1で、Go 1.26以降が必要です。
始める前に必要なもの#
- Go 1.26以降。Go 1.25では
v3.74.0を固定し、Go 1.22〜1.24ではv3.44.0を固定します(READMEによると、古い系統には修正が保証されません)。 - CheapTokensのAPIキー。ソースファイルではなく環境変数に保存してください。
- APIアドレス:
https:/。OpenAI Chat Completions形式なので、openai-goはラッパーなしで動作します。ドキュメントに同じアドレスとキーのページがあります。/ api. cheaptokens. dev/ v1 - モデルID。ここでは
deepseek-を使います。コンテキストは380K、1回の回答は最大32,768トークンです。完全なIDを使ってください。価格表の短い名前はAPIでは受け付けられません。ai/ DeepSeek- V4- Flash- 0731
ステップバイステップ
プロジェクトをセットアップする
SDKをインストールする
空のフォルダで:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'インポートパスはgithub.、パッケージ名はopenaiです。
キーを環境に設定する
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShellの場合: $env:CHEAPTOKENS_。プレースホルダーは実際のキーではありません。
main.goを作成して実行する
次のセクションのプログラムをmain.goに貼り付け、go run .を実行します。
プログラム全体#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
重要な部分:
option.は、SDKをOpenAIからCheapTokensに向ける唯一の行です。アドレスはドキュメントのとおりに正確に使ってください。WithBaseURL(. . . ) option.はキーを明示的に渡します。これがないとクライアントはWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEYを読みます。既存コードを移植するときに便利です。その変数にCheapTokensのキーを設定すれば、コード側でキーを変更する必要はありません。OPENAI_BASE_URLも同様ですが、明示的なWithBaseURLがそれを上書きするので、両方あっても驚くことはありません。ModelはSDKでは単なる文字列です(ChatModelはstringのエイリアス)。そのため、READMEに載っている定数だけでなく、任意のモデルIDが使えます。openai.は1つのユーザーターンです。READMEの例ではUserMessage(. . . ) DeveloperMessageとGPTの定数を使っていますが、ここではユーザーメッセージと文字列IDで十分です。
回答、finish_reason、usageを読む#
3つとも、SDKがすでに解析してくれるフィールドから取得します:
resp.はテキストです(Choices[0]. Message. Content string)。resp.もChoices[0]. FinishReason stringです。stopはモデルが自力で終了したことを意味し、lengthは回答がトークン上限に達して途中で切れたことを意味します。lengthが出た場合は、回答が途中で止まる理由を読んでください。resp.UsageにはPromptTokens(送信したもの)、CompletionTokens(モデルが書いたもの)、TotalTokensが入っており、すべてint64です。
出力は次のようになります: 回答、次に値付きのfinish_reason:、そして3つのトークン数です。数値は実行ごとに異なるのでログに記録してください。これが課金対象であり、出力トークンのほうが高価な側です。
自分で試す試してみる: モデルを入れ替えると何が変わるか?答えを表示
Modelの文字列をzai-に変えて、もう一度実行します。プログラムの他の部分は何も変わりません。回答テキストと3つのusageの数値が変わり、これが自分のプロンプトで2つのモデルを比較する最速の方法です。GLM-5.3-Flashはコンテキスト390K、1回の回答は最大8,192トークンです。
リトライとタイムアウト: 3つの異なる制限#
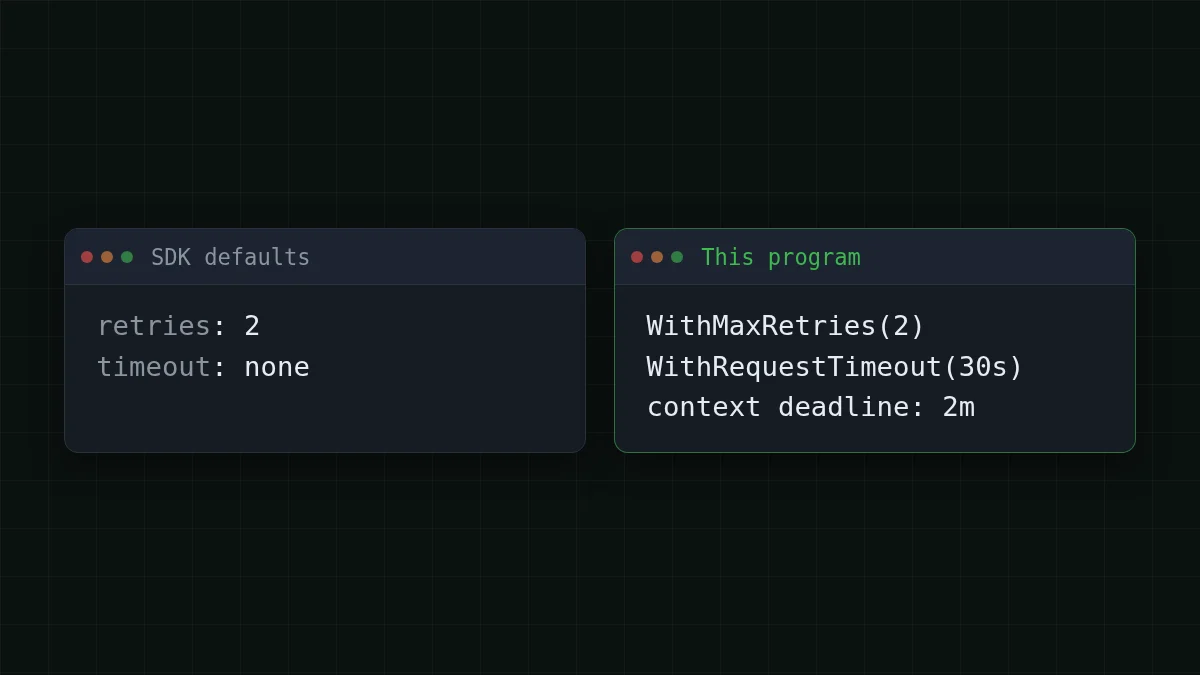
ここがGoサービスでよく問題になるところです。デフォルトではSDKにタイムアウトがまったくないため、接続が止まると永遠に待つ可能性があります。3つの設定でこれを解決でき、それぞれ異なるレベルで機能します:
option.: SDKは接続エラー、408、409、429、5xxを短い指数バックオフでリトライします。2回のリトライがすでにデフォルトで、WithMaxRetries(2) 0はリトライを無効にします。クライアント単位でも、個々の呼び出し単位でも設定できます。option.: 1回の試行の制限。WithRequestTimeout(30*time. Second) contextのデッドライン: リトライと待機を含む呼び出し全体の制限。
つまり2回のリトライで最大3回の試行になり、最悪で3 × 30 = 90秒の待機に、試行間の短い休止が加わります。2分のコンテキストでそれをカバーできます。Webハンドラで「20秒以内に必ず回答」という厳格なルールが必要なら、試行ごとのタイムアウトだけでなくコンテキストを短くしてください。
これらの数値の選び方についてより詳しくは、同じアドバイスのPython版がOpenAI Python SDK timeout and retriesにあります。ロジックはGoにも当てはまります。
この呼び出しを千回行うといくらかかるか#
1日に1,000リクエスト、それぞれ入力約800トークン、出力300トークンの小さなサービスを運用するとします。deepseek-では、その日のコストは$0.042です(1,000 × 800入力トークン、1,000 × 300出力トークン)。表は同じ負荷を各モデルで示しており、入力と出力を合わせた合計で見るとOpenRouterより安くなります。
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
リクエストあたり 800 入力トークンと 300 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
自分の数値を当てはめてください。最初の実行で実際のPromptTokensとCompletionTokensが出力されるので、平均を推測する必要はありません:
コスト計算機
小さなGoサービスの1日
リクエストあたりの入力トークン数: 800 · リクエストあたりの出力トークン数: 300 · 1日あたりのリクエスト数: 1,000
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
価格ページとモデルページの価格はライブで、モデルごとに1つの固定価格を使い、ピーク時間はありません。
うまくいかない場合#
- エラーに401が出る: キーが空か間違っています。
os.Getenvは未設定の変数に対して空文字列を返すので、go run .を実行するのと同じターミナルでecho $CHEAPTOKENS_を確認してください。API_ KEY - エラーに404または不明なモデルが出る: IDです。
deepseek-ai/プレフィックスを含めて完全にコピーしてください。モデル一覧の呼び出しでIDを一覧できます。 go: module requires Go 1.: ツールチェーンが古いです。冒頭に示したように古いSDKタグを固定してください。26 - 呼び出しがハングしてから失敗する: タイムアウトが機能している証拠です。まずネットワーク経路を確認し、モデルが長い回答に本当により多くの時間を必要とするなら
WithRequestTimeoutを上げてください。
base URLの考え方が初めてなら、what base_url is and how to switchがコードなしで説明しています。


