はじめにガイド
HoppscotchでCheapTokensへの最初のリクエスト:キーは環境に
HoppscotchのWebクライアントから最初のチャット補完を送信:ベースURLとキーを環境に入れ、JSONボディを用意し、応答と使用量をどこで読むかを解説します。
Hoppscotchで何もインストールせず、コードも書かずに最初のCheapTokensリクエストを送れます。Webアプリを開き、ベースURLとキーを環境に入れ、POST /リクエストを1つ作って送信を押すだけです。応答とトークン数はレスポンスパネルに表示されます。
慎重にやる価値があるのはキーだけです。リクエストに直接貼り付けると、すべてのスクリーンショットと共有リンクに残ってしまいます。環境変数にしておけば一箇所にまとまります。
このガイドは公式Hoppscotchドキュメント(2026年11月9日確認。ページにバージョンや日付の記載なし)に従っています。API側はOpenAI Chat Completions形式に対応したCheapTokensのベースURL https:/ です。詳細はCheapTokensドキュメントをご覧ください。
ベースURLとキーを環境に入れる#
HoppscotchのサイドバーにEnvironmentsアイコンがあります。クリックして新しい環境を作成し、cheaptokens と名前を付けて、2つの変数を追加します:
テーブルを右にスクロールしてください →
| 変数 | 型 | 値 |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | あなたのCheapTokensキー |
なぜ2種類あるのか?Hoppscotchのドキュメントによると、Regular変数は環境を見られる全員に表示されますが、Secret変数はマスクされ、同期や共有はされず、エクスポートや複製からも除外されます。キーは2つ目の種類に入れるべきです:変数の値として入力します。次にリクエストから見えるように cheaptokens 環境を選択します。
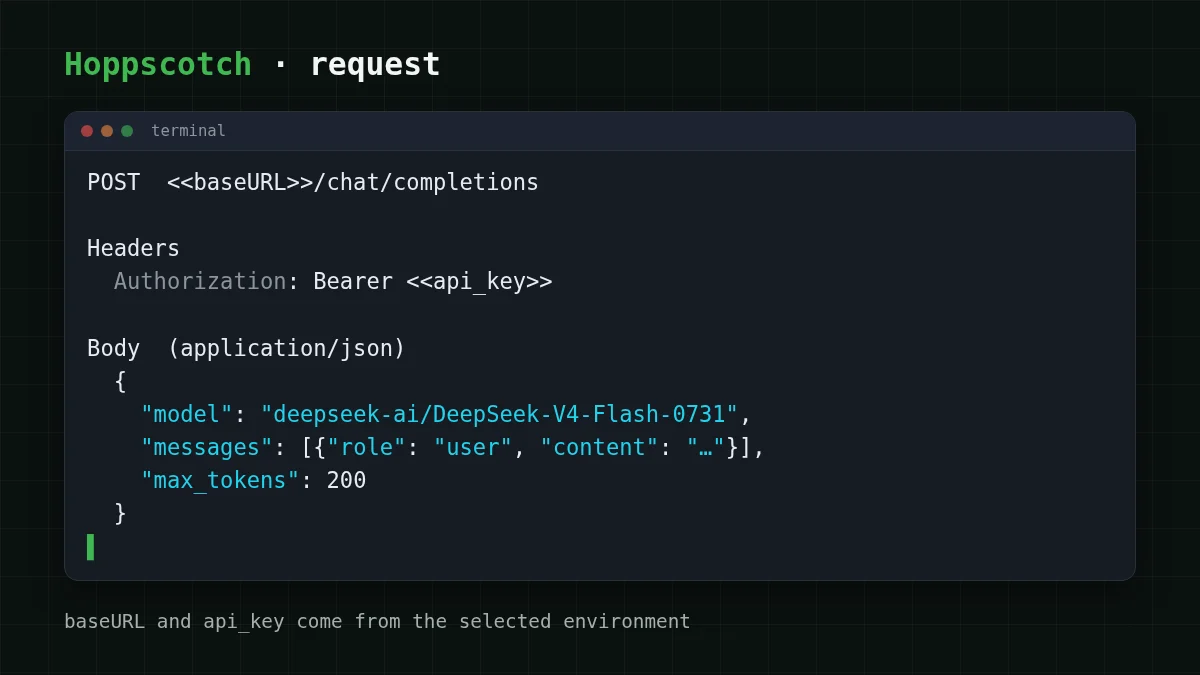
リクエスト内では変数は <<name>> と書きます:<<baseURL>> と <<api_key>>。これがすべてのコツです。
リクエストを組み立てる#
Hoppscotchを開くとRESTがアクティブモードです。設定するのは3つです。
メソッドとURL。 ドロップダウンで POST を選び、次を入力します:
<<baseURL>>/chat/completionsキー。 HoppscotchのAuthorizationタブにはBearerタイプがあり、トークンを Bearer <token> としてリクエストに追加します。ドキュメントにはそのトークンフィールド内で <<api_key>> が機能するか書かれていないので、確実な方法を使います:Headersタブを開いてヘッダーを1つ追加します。
Authorization: Bearer <<api_key>>変数を手で置き換える必要はなく、実際のキーが画面上のリクエストに現れることもありません。
ボディ。 Bodyタブを開き、Content Typeドロップダウンで application/json を選び(ドキュメントではJSON形式のコンテンツの型として記載されています)、次を貼り付けます:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
完全なID deepseek- を使用してください。価格表の短い名前はAPIに受け付けられません。DeepSeek-V4-Flashは380Kコンテキストで、回答あたり最大32,768出力トークンなので、200はテスト用に意図的に小さくした上限です。別のモデルを使いたい場合は、そのフィールドを zai-(390Kコンテキスト、最大8,192出力トークン)に変えて再度送信してください。
チェックリスト
送信を押す前に
送信を押して応答を読む#
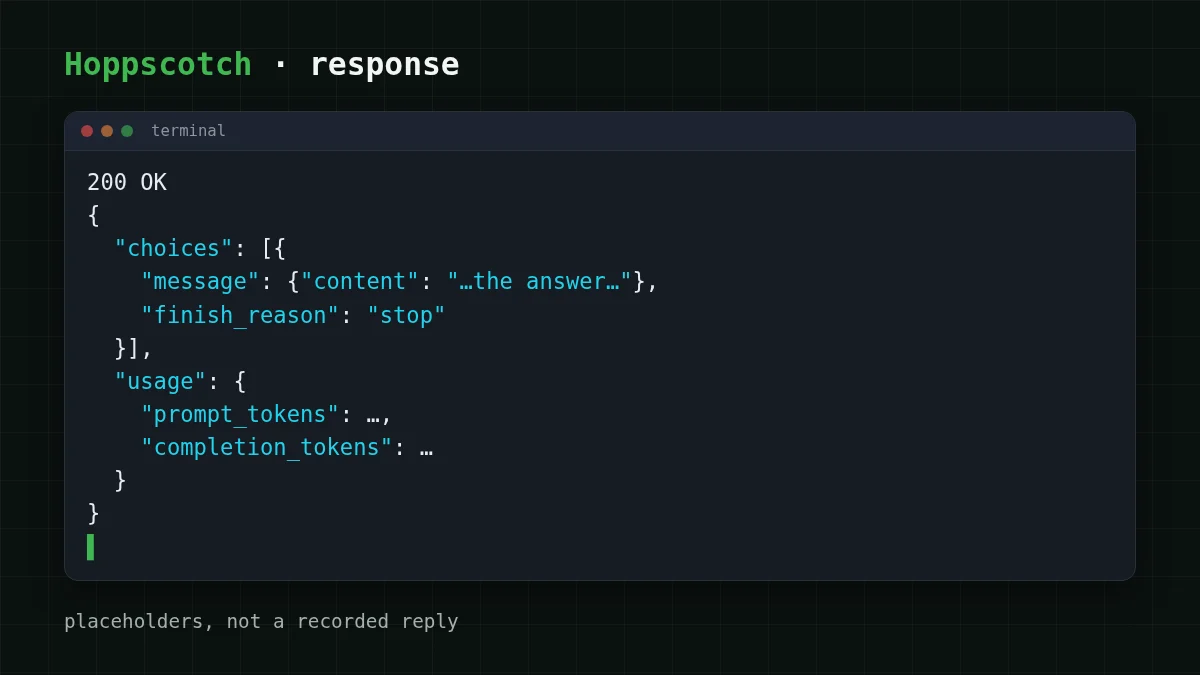
送信をクリックします。レスポンスセクションにステータスコード、ボディ、ヘッダー、Cookie、タイミングが表示されます。目指すのは 200 と、OpenAIチャット補完形式のJSONボディです。重要なのは2箇所です:
choices[0].はモデルの回答です。message. content usageにはprompt_tokens(送信した内容)とcompletion_(モデルが書いた内容)が入っています。これが課金対象なので、リクエストが想定通りのコストだったかはここで確認します。tokens
choices[0]. も見てください。stop はモデルが自力で終了したことを意味します。length は max_tokens が回答を打ち切ったことを意味します。一文の質問でこれが出るなら、上限が低すぎます。詳しい説明はAIの回答が途中で切れた?finish_reason "length"を修正するにあります。
リクエストをコレクションに保存すれば再利用できます:メッセージを変えて、再度送信を押すだけです。
テストリクエストのコスト#
短い質問と短い回答を考えます:入力30トークン、出力150トークンとしましょう。そのようなリクエスト1回のコストは $0.000015 で、下のライブ表は入力と出力を合わせて100回分をOpenRouterと並べて数えています。
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 100 リクエスト | OpenRouter、100 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
リクエストあたり 30 入力トークンと 150 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
入力と出力を合わせた合計では、同じモデルでOpenRouterより安くなります。実際の数値は異なるので、自分のケースでスライダーを動かしてください:
コスト計算機
上記のようなテストリクエスト100回
リクエストあたりの入力トークン数: 30 · リクエストあたりの出力トークン数: 150 · 1日あたりのリクエスト数: 100
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
価格はモデルごとに固定で、ピーク時間料金はなく、1つの残高ですべてのモデルをカバーします。現在の料金は価格ページにあります。
うまくいかない場合#
RESTクライアントでの初回リクエストの失敗は、ほとんどが3つのフィールドに起因します。症状と原因を照合してください:
ペアを合わせる
各症状を原因と照合する
左の項目をタップしてから、そのペアをタップ
- 401 Unauthorizedキーが欠けているか間違っている、または
Authorizationヘッダーが送信されていない - 404 Not FoundURLパスまたはモデルIDが間違っている
- finish_reasonが"length"
max_tokensの上限が回答を打ち切った
最初の2つについてはAPI 401または404エラー:キー、ベースURL、モデルIDの誤りに完全な手順があります。どのIDを使うかわからない場合は、GET /v1/modelsでモデルを一覧表示してください。
次に進む先#
同じリクエストは他のクライアントでも機能します:Postman版またはVS Code .httpファイルをご覧ください。キーをファイルやシェルから完全に切り離したい場合は、APIキーを安全に保存するで基本を説明しています。モデルIDとOpenAI互換エンドポイントはドキュメントに記載されています。


