เริ่มต้นใช้งานคู่มือ
คำขอแรกไปยัง CheapTokens ใน Hoppscotch: คีย์ใน environment
ส่ง chat completion ครั้งแรกจากไคลเอนต์เว็บ Hoppscotch: base URL และคีย์ใน environment, JSON body และจุดที่ต้องอ่านคำตอบและการใช้งาน
ในหน้านี้
คุณสามารถส่งคำขอ CheapTokens ครั้งแรกใน Hoppscotch ได้โดยไม่ต้องติดตั้งอะไรหรือเขียนโค้ด: เปิดเว็บแอป ใส่ base URL และคีย์ของคุณลงใน environment สร้างคำขอ POST / หนึ่งรายการ กด Send คำตอบและจำนวนโทเคนจะแสดงในแผง response
สิ่งเดียวที่ควรทำอย่างระมัดระวังคือคีย์ หากคุณวางมันลงในคำขอโดยตรง มันจะไปปรากฏในทุกภาพหน้าจอและทุกลิงก์ที่แชร์ การใช้ environment variable เก็บมันไว้ในที่เดียว
คู่มือนี้อ้างอิงเอกสาร Hoppscotch อย่างเป็นทางการ (ตรวจสอบเมื่อ 9 พฤศจิกายน 2026; หน้าเว็บไม่มีหมายเลขเวอร์ชันหรือวันที่) ฝั่ง API คือ base URL ของ CheapTokens https:/ ซึ่งใช้รูปแบบ OpenAI Chat Completions อ่านเพิ่มเติมเกี่ยวกับทั้งสองได้ใน เอกสาร CheapTokens
ใส่ base URL และคีย์ลงใน environment#
Hoppscotch มีไอคอน Environments ในแถบด้านข้าง คลิกมัน สร้าง environment ใหม่ ตั้งชื่อว่า cheaptokens และเพิ่มตัวแปรสองตัว:
เลื่อนตารางไปทางขวา →
| ตัวแปร | ประเภท | ค่า |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | คีย์ CheapTokens ของคุณ |
ทำไมต้องมีสองประเภท? ตามเอกสาร Hoppscotch ตัวแปร Regular จะมองเห็นได้โดยทุกคนที่เห็น environment ส่วนตัวแปร Secret จะถูกปิดบัง ไม่ถูกซิงก์หรือแชร์ และไม่ถูกรวมในการส่งออกหรือการทำสำเนา คีย์ควรอยู่ในประเภทที่สอง: ป้อนเป็นค่าของตัวแปร จากนั้นเลือก environment cheaptokens เพื่อให้คำขอเห็นมัน
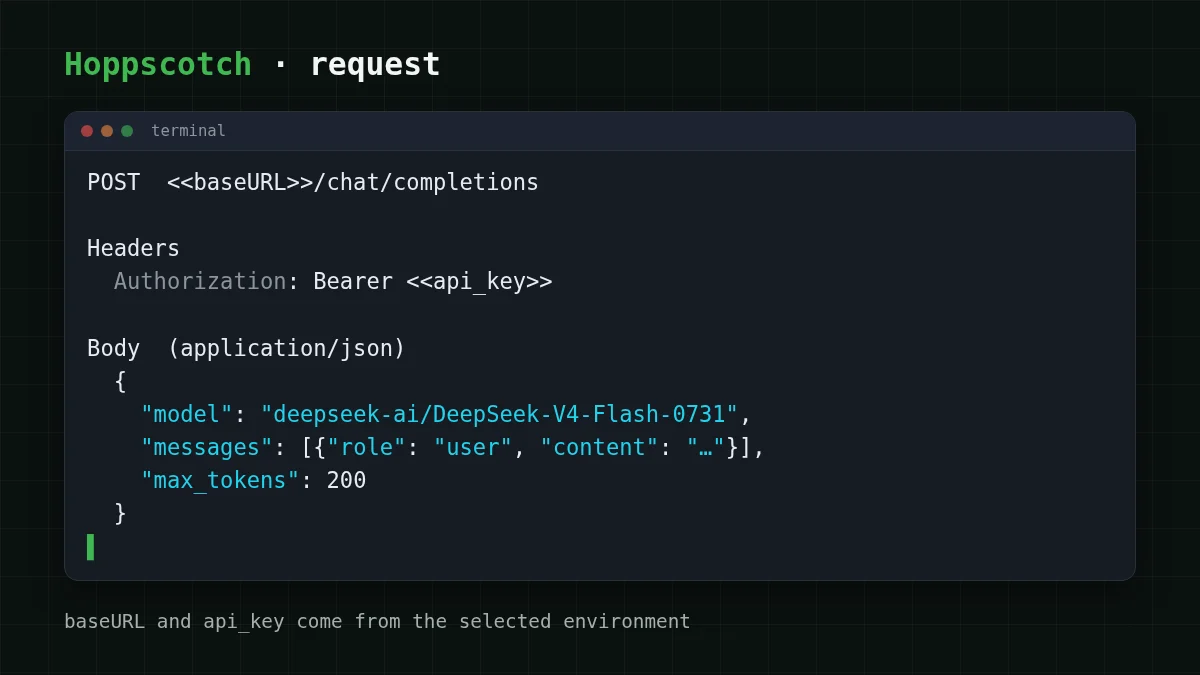
ในคำขอ ตัวแปรเขียนเป็น <<name>>: <<baseURL>> และ <<api_key>> นั่นคือเคล็ดลับทั้งหมด
สร้างคำขอ#
REST คือโหมดที่ใช้งานอยู่เมื่อคุณเปิด Hoppscotch มีสามอย่างที่ต้องตั้งค่า
Method และ URL เลือก POST ในดรอปดาวน์และป้อน:
<<baseURL>>/chat/completionsคีย์ แท็บ Authorization ของ Hoppscotch มีประเภท Bearer และเพิ่มโทเคนลงในคำขอเป็น Bearer <token> เอกสารไม่ได้ระบุว่า <<api_key>> ใช้ได้ภายในช่องโทเคนนั้นหรือไม่ ดังนั้นใช้เส้นทางที่แน่นอน: เปิดแท็บ Headers และเพิ่ม header หนึ่งรายการ
Authorization: Bearer <<api_key>>คุณไม่ต้องแทนที่ตัวแปรด้วยมือที่ไหนเลย และคีย์จริงจะไม่ปรากฏในคำขอที่คุณเห็นบนหน้าจอ
Body เปิดแท็บ Body เลือก application/json ในดรอปดาวน์ Content Type (เอกสารระบุว่าเป็นประเภทสำหรับเนื้อหาในรูปแบบ JSON) และวาง:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
ใช้ id แบบเต็ม deepseek- ชื่อย่อจากรายการราคาจะไม่ถูกยอมรับโดย API DeepSeek-V4-Flash มี context 380K และเอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ ดังนั้น 200 จึงเป็นเพดานที่ตั้งใจให้เล็กสำหรับการทดสอบ ต้องการโมเดลอื่น? เปลี่ยนฟิลด์นั้นเป็น zai- (context 390K เอาต์พุตสูงสุด 8,192 โทเคน) แล้วส่งอีกครั้ง
เช็กลิสต์
ก่อนกด Send
กด Send และอ่านคำตอบ#
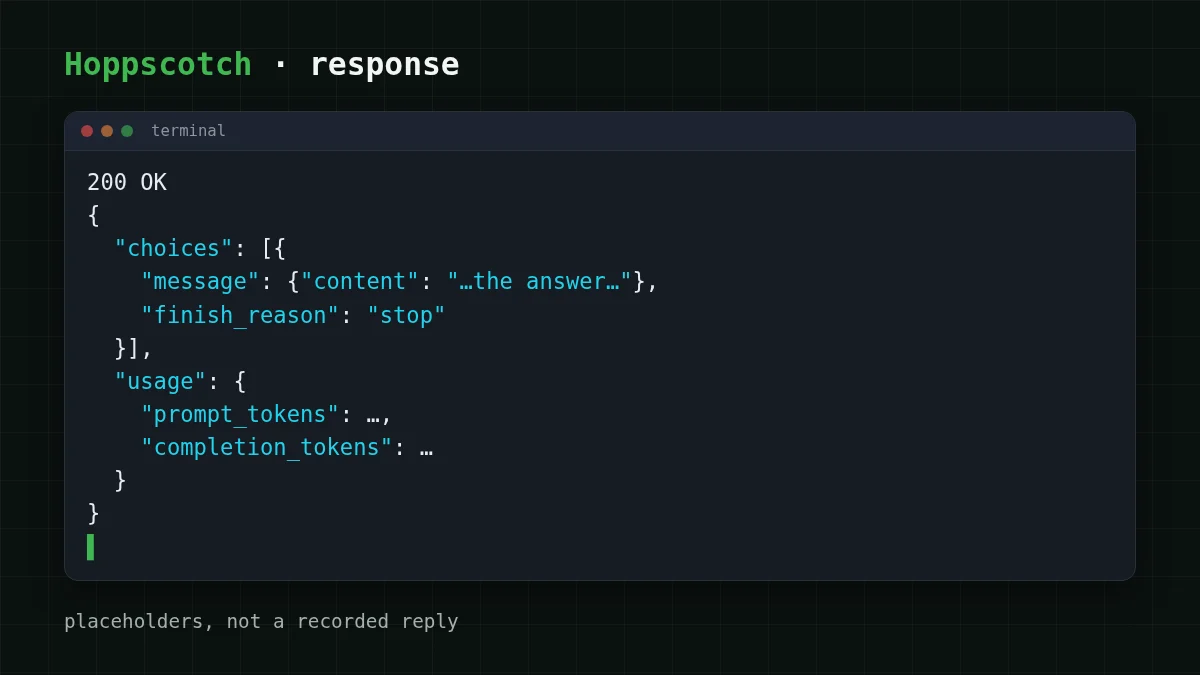
คลิก Send ส่วน response จะแสดงสถานะโค้ด body headers cookies และเวลา คุณต้องการ 200 และ JSON body ที่มีรูปร่างเหมือนรูปแบบ OpenAI chat completion มีสองจุดที่สำคัญ:
choices[0].คือคำตอบของโมเดลmessage. content usageมีprompt_tokens(สิ่งที่คุณส่งไป) และcompletion_(สิ่งที่โมเดลเขียน) นั่นคือสิ่งที่คุณถูกเรียกเก็บเงิน ดังนั้นนี่คือจุดที่คุณตรวจสอบว่าคำขอมีค่าใช้จ่ายตามที่คาดไว้tokens
ดู choices[0]. ด้วย stop หมายความว่าโมเดลจบด้วยตัวเอง length หมายความว่า max_tokens ของคุณตัดคำตอบ หากคุณเห็นสิ่งนี้กับคำถามหนึ่งประโยค เพดานต่ำเกินไป มีคำอธิบายเพิ่มเติมใน คำตอบ AI ถูกตัด? แก้ไข finish_reason "length"
บันทึกคำขอลงใน collection แล้วมันจะใช้ซ้ำได้: เปลี่ยนข้อความ กด Send อีกครั้ง
คำขอทดสอบมีค่าใช้จ่ายเท่าไร#
ใช้คำถามสั้นและคำตอบสั้น: สมมติ 30 โทเคนขาเข้าและ 150 ขาออก คำขอหนึ่งครั้งมีค่าใช้จ่าย $0.000015 และตารางสดด้านล่างนับ 100 ครั้งโดยรวมอินพุตและเอาต์พุต เทียบกับ OpenRouter
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 100 คำขอ | OpenRouter, 100 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 โทเค็นอินพุตและ 150 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน จะถูกกว่า OpenRouter สำหรับโมเดลเดียวกัน ตัวเลขของคุณเองจะแตกต่างออกไป ดังนั้นลากแถบเลื่อนตามกรณีของคุณเอง:
เครื่องคำนวณค่าใช้จ่าย
คำขอทดสอบหนึ่งร้อยครั้งเหมือนข้างต้น
โทเค็นอินพุตต่อคำขอ: 30 · โทเค็นเอาต์พุตต่อคำขอ: 150 · คำขอต่อวัน: 100
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
ราคาคงที่ต่อโมเดล ไม่มีราคาช่วงพีค และยอดเงินเดียวครอบคลุมทุกโมเดล อัตราปัจจุบันอยู่ในหน้าราคา
หากใช้งานไม่ได้#
ความล้มเหลวของคำขอแรกใน REST client ส่วนใหญ่มาจากสามฟิลด์ จับคู่อาการกับสาเหตุ:
จับคู่
จับคู่อาการแต่ละอย่างกับสาเหตุ
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- 401 Unauthorizedคีย์หายหรือผิด หรือ header
Authorizationไม่ถูกส่ง - 404 Not Foundพาธ URL หรือ model id ผิด
- finish_reason เป็น "length"เพดาน
max_tokensตัดคำตอบ
สำหรับสองข้อแรกมีคำอธิบายแบบละเอียดใน ข้อผิดพลาด API 401 หรือ 404: คีย์, base URL หรือ model id ผิด หากคุณไม่แน่ใจว่าจะใช้ id ใด แสดงรายการโมเดลด้วย GET /v1/models
ไปต่อที่ไหน#
คำขอเดียวกันใช้ได้ในไคลเอนต์อื่น: ดูเวอร์ชัน Postman หรือไฟล์ .http ใน VS Code หากคุณต้องการเก็บคีย์ออกจากไฟล์และเชลล์ทั้งหมด จัดเก็บ API key อย่างปลอดภัย ครอบคลุมพื้นฐาน Model id และ endpoint ที่เข้ากันได้กับ OpenAI อธิบายไว้ในเอกสาร


