快速开始指南
在 Hoppscotch 中向 CheapTokens 发出第一个请求:将密钥放入环境
从 Hoppscotch Web 客户端发送你的第一个 chat completion:将基础 URL 和密钥放入环境,使用 JSON body,并了解在哪里读取回复和用量。
你可以在 Hoppscotch 中发出第一个 CheapTokens 请求,无需安装任何东西,也无需编写代码:打开 Web 应用,将基础 URL 和你的密钥放入环境,构建一个 POST / 请求,然后点击 Send。响应面板中会显示回答和 token 计数。
唯一需要小心处理的是密钥。如果你直接把它粘贴到请求中,它就会出现在每张截图和每个分享链接里。环境变量可以把它保存在一个地方。
本指南遵循 Hoppscotch 官方文档(检查于 2026 年 11 月 9 日;这些页面没有版本或日期)。API 侧是 CheapTokens 基础 URL https:/,它使用 OpenAI Chat Completions 格式。更多内容见 CheapTokens 文档。
将基础 URL 和密钥放入环境#
Hoppscotch 的侧边栏中有一个 Environments 图标。点击它,创建一个新环境,将其命名为 cheaptokens,并添加两个变量:
向右滚动表格 →
| 变量 | 类型 | 值 |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | 你的 CheapTokens 密钥 |
为什么有两种类型?根据 Hoppscotch 文档,Regular 变量对所有能看到该环境的人可见,而 Secret 变量会被掩码,永远不会同步或共享,并且不会出现在导出和副本中。密钥应归入第二种:将其作为变量的值输入。然后选择 cheaptokens 环境,以便请求可以看到它。
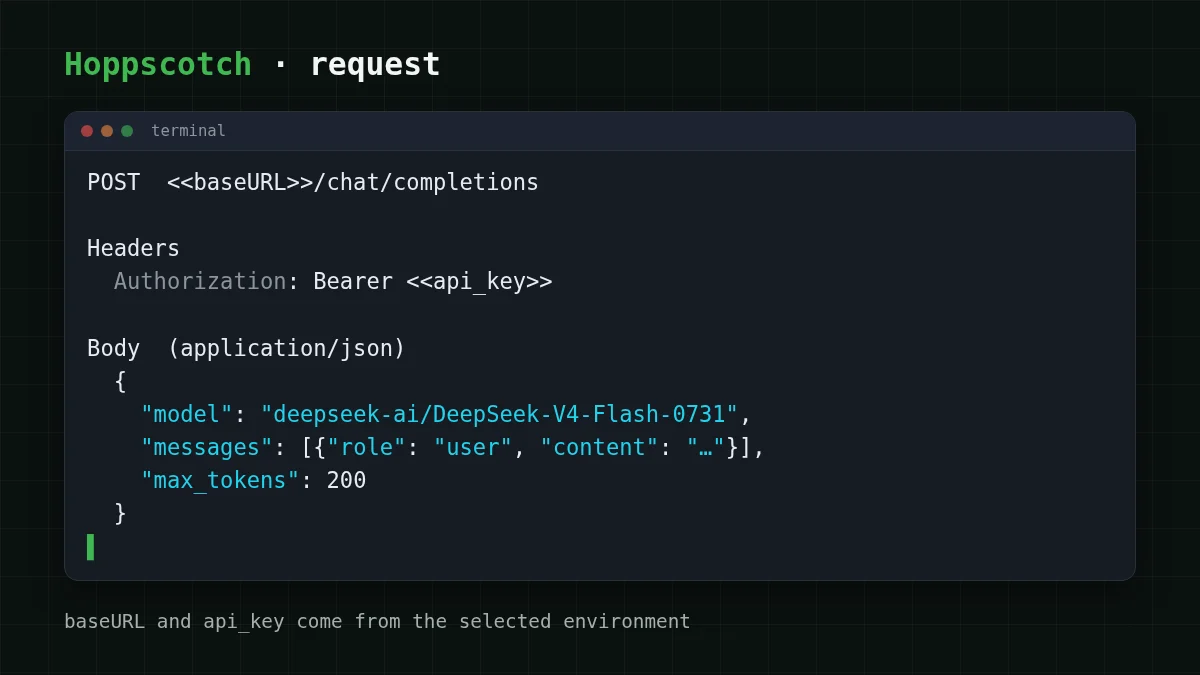
在请求中,变量写作 <<name>>:<<baseURL>> 和 <<api_key>>。这就是全部技巧。
构建请求#
打开 Hoppscotch 时,REST 是活动模式。需要设置三件事。
方法和 URL。 在下拉菜单中选择 POST 并输入:
<<baseURL>>/chat/completions密钥。 Hoppscotch 的 Authorization 标签页有 Bearer 类型,会将 token 作为 Bearer <token> 添加到请求中。文档没有说明 <<api_key>> 是否在该 token 字段内有效,所以使用可靠路线:打开 Headers 标签页并添加一个 header。
Authorization: Bearer <<api_key>>你无需手动替换变量,真实密钥也永远不会出现在屏幕上显示的请求中。
Body。 打开 Body 标签页,在 Content Type 下拉菜单中选择 application/json(文档将其列为 JSON 格式内容的类型),然后粘贴:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
使用完整 id deepseek-。价格表中的短名称不会被 API 接受。DeepSeek-V4-Flash 具有 380K 上下文和每个回答最多 32,768 个输出 token,因此 200 是用于测试的故意设置的小上限。想要不同的模型?将该字段改为 zai-(390K 上下文,最多 8,192 个输出 token)并再次发送。
清单
在按下 Send 之前
按下 Send 并读取回复#
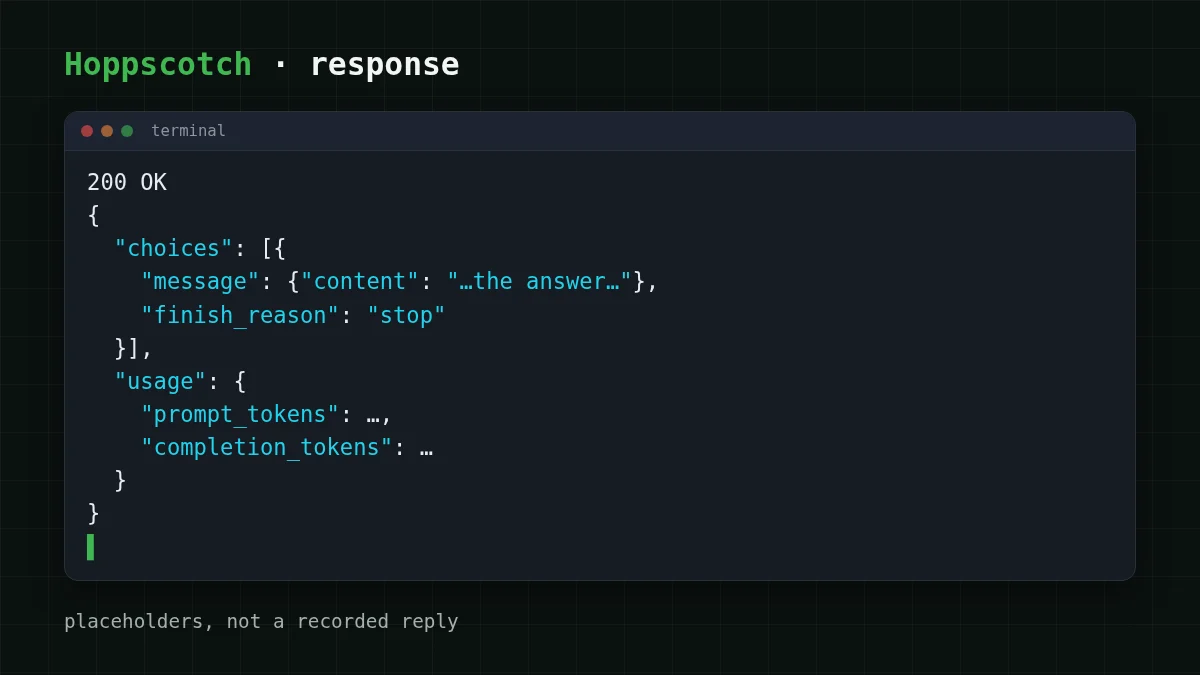
点击 Send。响应部分会显示状态码、body、headers、cookies 和计时。你需要 200 以及形状类似 OpenAI chat completion 格式的 JSON body。有两个地方很重要:
choices[0].是模型的回答。message. content usage包含prompt_tokens(你发送的内容)和completion_(模型写出的内容)。这就是计费依据,因此你可以在这里检查请求费用是否符合预期。tokens
还要查看 choices[0].。stop 表示模型自行完成。length 表示你的 max_tokens 截断了回答。如果你在一个单句问题上看到这种情况,说明上限太低。更详细的解释见 AI 回答被截断?修复 finish_reason "length"。
将请求保存到集合中即可复用:更改消息,再次按下 Send。
一次测试请求的费用#
取一个短问题和一个短回答:比如输入 30 个 token,输出 150 个 token。一次这样的请求花费 $0.000015,下面的实时表格将 100 次此类请求的输入和输出合计,与 OpenRouter 并列。
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 100 次请求 | OpenRouter,100 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
每次请求 30 个输入 token 和 150 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
总计,将输入和输出合计计算,对于同一模型这比 OpenRouter 更便宜。你自己的数字会有所不同,所以请根据你自己的情况拖动滑块:
成本计算器
一百次像上面这样的测试请求
每次请求的输入 token 数: 30 · 每次请求的输出 token 数: 150 · 每日请求数: 100
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
价格按模型固定,没有高峰时段定价,一个余额覆盖所有模型。当前费率见定价页面。
如果不起作用#
REST 客户端中大多数首次请求失败来自三个字段。将症状与原因对应:
配对
将每个症状与其原因对应
点击左侧项目,然后点击其配对项
- 401 Unauthorized密钥缺失或错误,或者
Authorizationheader 未被发送 - 404 Not FoundURL 路径或模型 id 错误
- finish_reason 为 "length"
max_tokens上限截断了回答
对于前两个,API 401 或 404 错误:错误的密钥、基础 URL 或模型 id 中有完整演练。如果你不确定使用哪个 id,使用 GET /v1/models 列出模型。
接下来去哪里#
同样的请求在其他客户端中也可用:参见 Postman 版本 或 VS Code .http 文件。如果你更希望完全将密钥排除在文件和 shell 之外,安全存储 API 密钥 涵盖了基础知识。模型 id 和 OpenAI 兼容端点见文档。


