शुरुआत करेंगाइड
Hoppscotch में CheapTokens को पहला अनुरोध: environment में key
Hoppscotch वेब client से अपना पहला chat completion भेजें: environment में base URL और key, एक JSON body, और उत्तर व usage कहाँ पढ़ें।
इस पृष्ठ पर
आप Hoppscotch में अपना पहला CheapTokens अनुरोध बिना कुछ इंस्टॉल किए या कोड लिखे कर सकते हैं: वेब ऐप खोलें, base URL और अपनी key को एक environment में डालें, एक POST / अनुरोध बनाएँ, Send दबाएँ। उत्तर और token गणनाएँ response panel में दिखाई देती हैं।
केवल एक चीज़ है जिसे सावधानी से करना चाहिए — key। अगर आप इसे सीधे अनुरोध में पेस्ट करते हैं, तो यह हर स्क्रीनशॉट और हर साझा किए गए लिंक में आ जाती है। एक environment variable इसे एक ही जगह रखता है।
यह गाइड आधिकारिक Hoppscotch दस्तावेज़ों का अनुसरण करती है (9 नवंबर 2026 को जाँचा गया; पृष्ठों पर कोई संस्करण या तिथि नहीं है)। API पक्ष CheapTokens base URL https:/ है, जो OpenAI Chat Completions प्रारूप बोलता है। दोनों के बारे में अधिक जानकारी CheapTokens docs में।
base URL और key को एक environment में डालें#
Hoppscotch में sidebar में एक Environments आइकन है। उस पर क्लिक करें, एक नया environment बनाएँ, उसका नाम cheaptokens रखें, और दो variables जोड़ें:
तालिका को दाईं ओर स्क्रॉल करें →
| Variable | Type | Value |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | your CheapTokens key |
दो प्रकार क्यों? Hoppscotch दस्तावेज़ों के अनुसार, एक Regular variable उन सभी को दिखाई देता है जो environment देख सकते हैं, जबकि Secret वाला masked रहता है, कभी sync या साझा नहीं होता, और exports व duplicates से बाहर रहता है। key दूसरे प्रकार में जाती है: इसे variable के value के रूप में दर्ज करें। फिर cheaptokens environment चुनें ताकि अनुरोध उसे देख सके।
अनुरोधों में, एक variable को <<name>> के रूप में लिखा जाता है: <<baseURL>> और <<api_key>>। बस यही पूरी तरकीब है।
अनुरोध बनाएँ#
Hoppscotch खोलने पर REST सक्रिय mode होता है। तीन चीज़ें सेट करनी हैं।
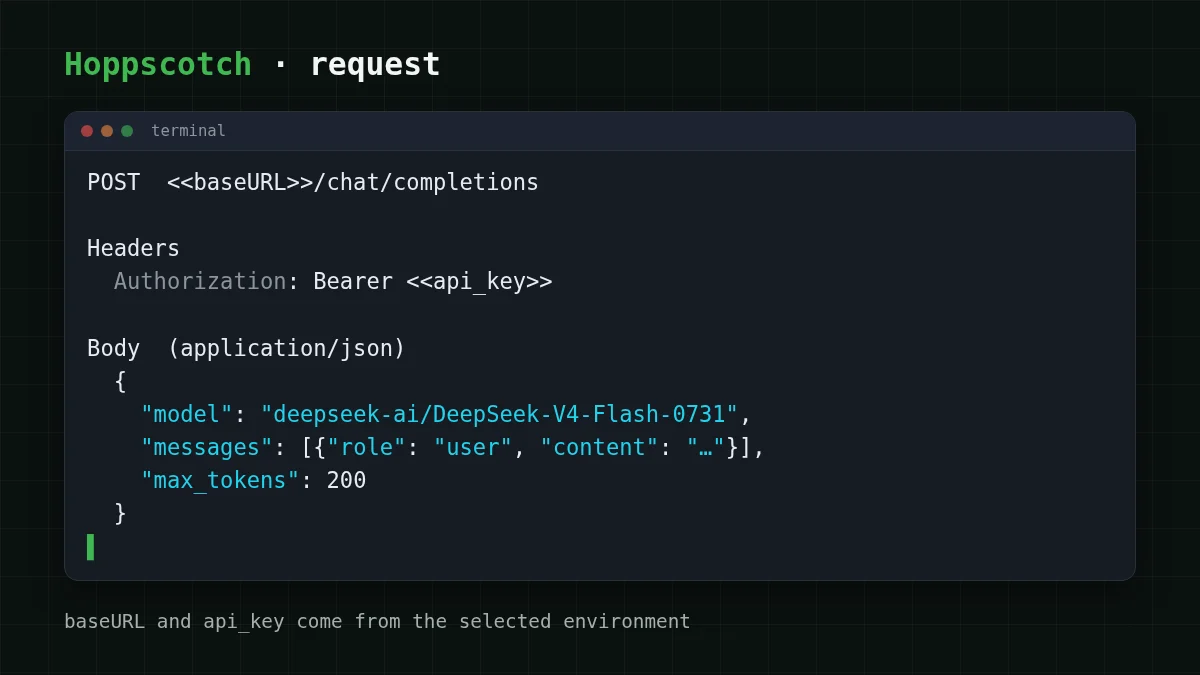
Method और URL। dropdown में POST चुनें और दर्ज करें:
<<baseURL>>/chat/completionskey। Hoppscotch के Authorization tab में Bearer प्रकार है और यह token को अनुरोध में Bearer <token> के रूप में जोड़ता है। दस्तावेज़ नहीं बताते कि <<api_key>> उस token फ़ील्ड के अंदर काम करता है या नहीं, इसलिए सुनिश्चित रास्ता अपनाएँ: Headers tab खोलें और एक header जोड़ें।
Authorization: Bearer <<api_key>>आप variable को कहीं भी हाथ से नहीं बदलते, और असली key उस अनुरोध में कभी नहीं दिखती जो आप स्क्रीन पर देखते हैं।
body। Body tab खोलें, Content Type dropdown में application/json चुनें (दस्तावेज़ इसे JSON प्रारूप में सामग्री के लिए प्रकार के रूप में सूचीबद्ध करते हैं), और पेस्ट करें:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
पूरा id deepseek- इस्तेमाल करें। मूल्य सूची से छोटा नाम API द्वारा स्वीकार नहीं किया जाएगा। DeepSeek-V4-Flash में 380K context और प्रति उत्तर अधिकतम 32,768 output tokens हैं, इसलिए परीक्षण के लिए 200 जानबूझकर छोटी सीमा है। कोई दूसरा model चाहिए? उस एक फ़ील्ड को zai- में बदलें (390K context, अधिकतम 8,192 output tokens) और फिर से भेजें।
चेकलिस्ट
Send दबाने से पहले
Send दबाएँ और उत्तर पढ़ें#
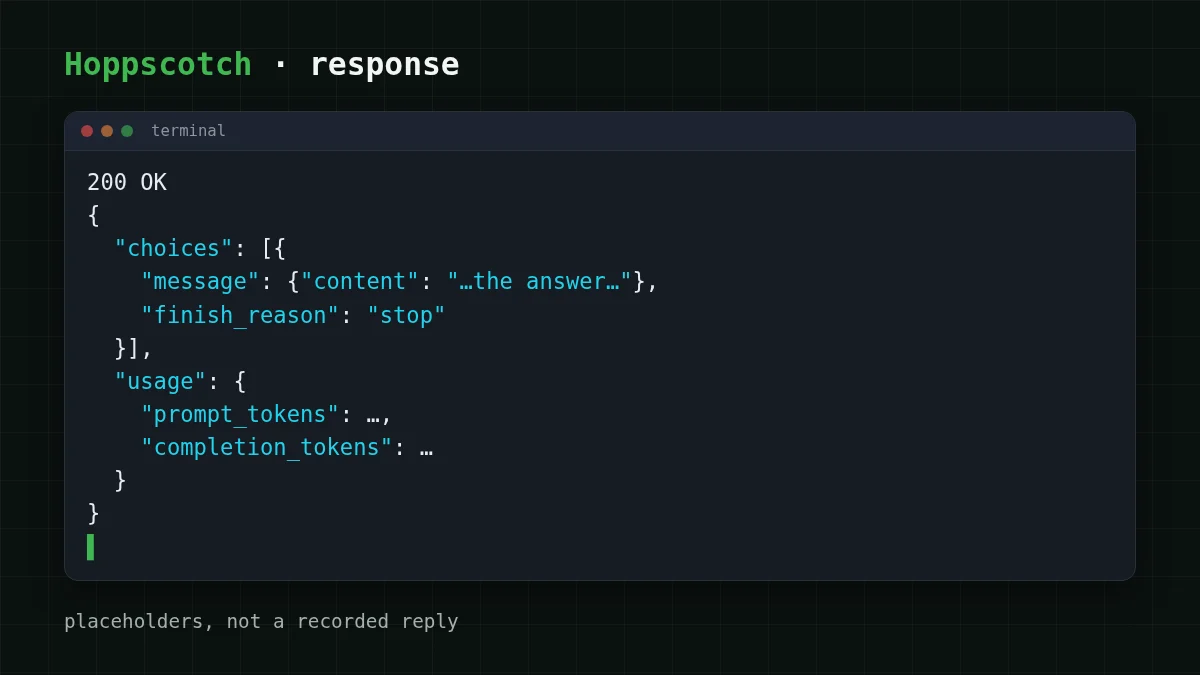
Send पर क्लिक करें। response अनुभाग status code, body, headers, cookies और timing दिखाता है। आपको 200 और OpenAI chat completion प्रारूप जैसा JSON body चाहिए। दो जगहें मायने रखती हैं:
choices[0].model का उत्तर है।message. content usageमेंprompt_tokens(जो आपने भेजा) औरcompletion_(जो model ने लिखा) हैं। आपसे इसी का बिल लिया जाता है, इसलिए यहीं आप जाँचते हैं कि अनुरोध की लागत अपेक्षित थी।tokens
choices[0]. को भी देखें। stop का अर्थ है कि model ने स्वयं समाप्त किया। length का अर्थ है कि आपके max_tokens ने उत्तर को काट दिया। अगर एक-वाक्य के प्रश्न पर ऐसा दिखे, तो सीमा बहुत कम है। अधिक विस्तृत व्याख्या AI answer cut off? Fix finish_reason "length" में है।
अनुरोध को एक collection में सहेजें और यह पुनः प्रयोग योग्य हो जाता है: संदेश बदलें, फिर से Send दबाएँ।
एक परीक्षण अनुरोध की लागत#
एक छोटा प्रश्न और एक छोटा उत्तर लें: मान लीजिए 30 tokens अंदर और 150 बाहर। ऐसे एक अनुरोध की लागत $0.000015 है, और नीचे की लाइव तालिका उनमें से 100 को input और output सहित गिनती है, OpenRouter के साथ।
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 100 अनुरोध | OpenRouter, 100 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
प्रति अनुरोध 30 इनपुट और 150 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कुल मिलाकर, input और output को साथ गिनते हुए, यह उसी model के लिए OpenRouter से सस्ता है। आपके अपने आँकड़े अलग होंगे, इसलिए अपने मामले पर sliders खींचें:
लागत कैलकुलेटर
ऊपर जैसे सौ परीक्षण अनुरोध
प्रति अनुरोध इनपुट टोकन: 30 · प्रति अनुरोध आउटपुट टोकन: 150 · प्रति दिन अनुरोध: 100
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
कीमतें प्रति model निश्चित हैं, कोई peak-hour मूल्य नहीं, और एक balance सभी models को कवर करता है। वर्तमान दरें pricing page पर हैं।
अगर यह काम न करे#
REST client में अधिकांश पहले-अनुरोध विफलताएँ तीन फ़ील्ड से आती हैं। लक्षण को कारण से मिलाएँ:
जोड़े मिलाएँ
प्रत्येक लक्षण को उसके कारण से मिलाएँ
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- 401 Unauthorizedkey गायब या गलत है, या
Authorizationheader नहीं भेजा जा रहा - 404 Not FoundURL path या model id गलत है
- finish_reason "length" है
max_tokensसीमा ने उत्तर काट दिया
पहले दो के लिए पूरी जानकारी API 401 or 404 error: wrong key, base URL or model id में है। अगर आपको यकीन नहीं कि कौन सा id इस्तेमाल करें, तो list models with GET /v1/models।
आगे कहाँ जाएँ#
वही अनुरोध अन्य clients में भी काम करता है: Postman version या VS Code .http file देखें। अगर आप keys को फ़ाइलों और shells से पूरी तरह बाहर रखना चाहते हैं, तो store an API key safely मूल बातें बताता है। Model ids और OpenAI-संगत endpoint का वर्णन docs में है।


