Primeiros passosGuia
Primeira requisição ao CheapTokens no Hoppscotch: chave em um ambiente
Envie sua primeira chat completion pelo cliente web do Hoppscotch: URL base e chave em um ambiente, um corpo JSON e onde ler a resposta e o uso.
Nesta página
Você pode fazer sua primeira requisição ao CheapTokens no Hoppscotch sem instalar nada ou escrever código: abra o app web, coloque a URL base e sua chave em um ambiente, monte uma requisição POST /, pressione Send. A resposta e as contagens de tokens aparecem no painel de resposta.
A única coisa que vale a pena fazer com cuidado é a chave. Se você colá-la direto na requisição, ela acaba em cada screenshot e em cada link compartilhado. Uma variável de ambiente a mantém em um só lugar.
Este guia segue a documentação oficial do Hoppscotch (verificada em 9 de novembro de 2026; as páginas não trazem versão nem data). Do lado da API, a URL base do CheapTokens é https:/, que fala o formato OpenAI Chat Completions. Mais sobre ambos na documentação do CheapTokens.
Coloque a URL base e a chave em um ambiente#
O Hoppscotch tem um ícone de Environments na barra lateral. Clique nele, crie um novo ambiente, dê o nome cheaptokens e adicione duas variáveis:
Role a tabela para a direita →
| Variável | Tipo | Valor |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | sua chave do CheapTokens |
Por que dois tipos? Segundo a documentação do Hoppscotch, uma variável Regular é visível para todos que podem ver o ambiente, enquanto uma Secret é mascarada, nunca sincronizada nem compartilhada, e fica de fora de exportações e duplicações. Uma chave pertence ao segundo tipo: insira-a como valor da variável. Depois selecione o ambiente cheaptokens para que a requisição possa vê-lo.
Nas requisições, uma variável é escrita como <<name>>: <<baseURL>> e <<api_key>>. É esse o truque inteiro.
Monte a requisição#
REST é o modo ativo quando você abre o Hoppscotch. Três coisas para configurar.
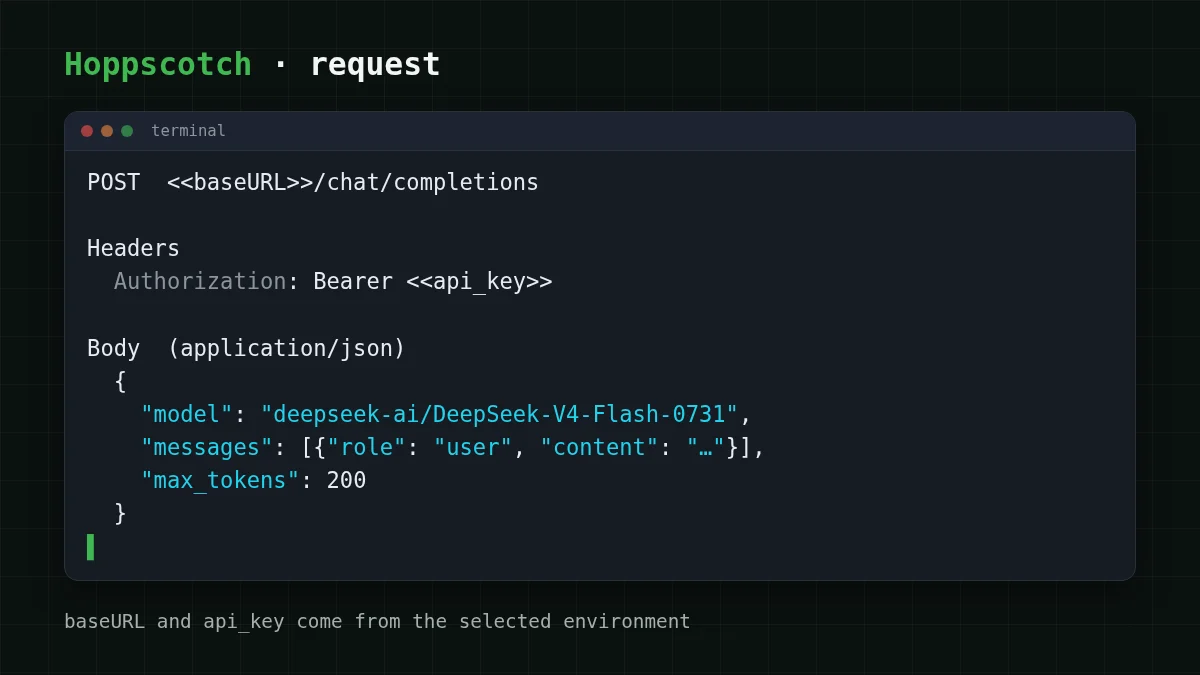
Método e URL. Escolha POST no dropdown e insira:
<<baseURL>>/chat/completionsA chave. A aba Authorization do Hoppscotch tem um tipo Bearer e adiciona o token à requisição como Bearer <token>. A documentação não diz se <<api_key>> funciona dentro desse campo de token, então use o caminho seguro: abra a aba Headers e adicione um header.
Authorization: Bearer <<api_key>>Você não substitui a variável manualmente em lugar nenhum, e a chave real nunca aparece na requisição que você vê na tela.
O corpo. Abra a aba Body, escolha application/json no dropdown Content Type (a documentação o lista como o tipo para conteúdo em formato JSON) e cole:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
Use o id completo deepseek-. O nome curto de uma lista de preços não será aceito pela API. O DeepSeek-V4-Flash tem contexto de 380K e até 32.768 tokens de saída por resposta, então 200 é um limite deliberadamente pequeno para um teste. Quer outro modelo? Troque esse único campo por zai- (contexto de 390K, até 8.192 tokens de saída) e envie de novo.
Lista de verificação
Antes de pressionar Send
Pressione Send e leia a resposta#
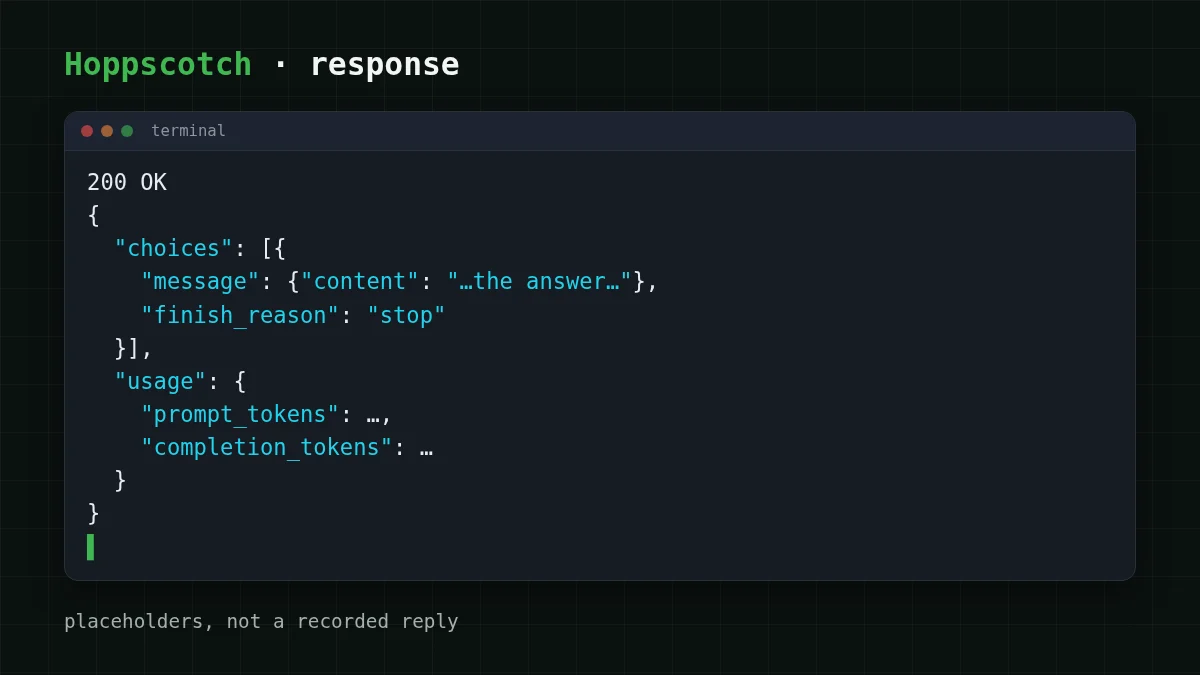
Clique em Send. A seção de resposta mostra o código de status, o corpo, os headers, os cookies e o tempo. Você quer 200 e um corpo JSON no formato de chat completion da OpenAI. Dois lugares importam:
choices[0].é a resposta do modelo.message. content usagetemprompt_tokens(o que você enviou) ecompletion_(o que o modelo escreveu). É por isso que você é cobrado, então é aqui que você verifica se uma requisição custou o que esperava.tokens
Observe também choices[0].. stop significa que o modelo terminou por conta própria. length significa que seu max_tokens cortou a resposta. Se você vir isso em uma pergunta de uma frase, o limite está baixo demais. Há uma explicação mais longa em Resposta da IA cortada? Corrija finish_reason "length".
Salve a requisição em uma coleção e ela fica reutilizável: mude a mensagem, pressione Send de novo.
Quanto custa uma requisição de teste#
Pegue uma pergunta curta e uma resposta curta: digamos 30 tokens de entrada e 150 de saída. Uma requisição assim custa $0.000015, e a tabela ao vivo abaixo conta 100 delas com entrada e saída juntas, ao lado do OpenRouter.
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 100 solicitações | OpenRouter, 100 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 tokens de entrada e 150 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
No total, com entrada e saída contadas juntas, isso é mais barato que o OpenRouter para o mesmo modelo. Seus próprios números serão diferentes, então arraste os sliders para o seu caso:
Calculadora de custos
Cem requisições de teste como a acima
Tokens de entrada por solicitação: 30 · Tokens de saída por solicitação: 150 · Solicitações por dia: 100
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
Os preços são fixos por modelo, sem preço de horário de pico, e um único saldo cobre todos os modelos. As tarifas atuais estão na página de preços.
Se não funcionar#
A maioria das falhas de primeira requisição em um cliente REST vem de três campos. Relacione o sintoma à causa:
Emparelhar os pares
Relacione cada sintoma à sua causa
Toque num item à esquerda, depois no seu par
- 401 UnauthorizedA chave está ausente ou errada, ou o header
Authorizationnão está sendo enviado - 404 Not FoundO caminho da URL ou o id do modelo está errado
- finish_reason é "length"O limite
max_tokenscortou a resposta
Para os dois primeiros há um passo a passo completo em Erro 401 ou 404 na API: chave, URL base ou id de modelo errado. Se você não tem certeza de qual id usar, liste os modelos com GET /v1/models.
Para onde ir agora#
A mesma requisição funciona em outros clientes: veja a versão para Postman ou o arquivo .http do VS Code. Se você prefere manter chaves fora de arquivos e shells, armazene uma chave de API com segurança cobre o básico. Os ids de modelo e o endpoint compatível com OpenAI estão descritos na documentação.


