شروعاتگائیڈ
Hoppscotch میں CheapTokens کی پہلی درخواست: environment میں key
Hoppscotch web client سے اپنی پہلی chat completion بھیجیں: environment میں base URL اور key، ایک JSON body، اور جواب اور usage کہاں پڑھیں۔
اس صفحہ پر
آپ اپنی پہلی CheapTokens درخواست Hoppscotch میں بغیر کچھ انسٹال کیے یا کوڈ لکھے بھیج سکتے ہیں: ویب ایپ کھولیں، base URL اور اپنی key ایک environment میں ڈالیں، ایک POST / درخواست بنائیں، Send دبائیں۔ جواب اور token counts response panel میں نظر آئیں گے۔
صرف ایک چیز ہے جسے احتیاط سے کرنا چاہیے: key۔ اگر آپ اسے سیدھا درخواست میں پیسٹ کریں، تو یہ ہر screenshot اور ہر شیئر کیے گئے لنک میں آ جاتی ہے۔ environment variable اسے ایک ہی جگہ رکھتا ہے۔
یہ گائیڈ Hoppscotch کی سرکاری دستاویزات کی پیروی کرتی ہے (9 نومبر 2026 کو چیک کیا گیا؛ صفحات پر کوئی ورژن یا تاریخ نہیں ہے)۔ API کی طرف CheapTokens کا base URL https:/ ہے، جو OpenAI Chat Completions فارمیٹ بولتا ہے۔ دونوں کے بارے میں مزید CheapTokens docs میں۔
base URL اور key کو environment میں ڈالیں#
Hoppscotch میں sidebar پر ایک Environments آئیکن ہے۔ اس پر کلک کریں، نیا environment بنائیں، اس کا نام cheaptokens رکھیں، اور دو variables شامل کریں:
ٹیبل کو دائیں طرف اسکرول کریں →
| Variable | Type | Value |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | your CheapTokens key |
دو types کیوں؟ Hoppscotch کی دستاویزات کے مطابق، ایک Regular variable ہر اس شخص کو نظر آتا ہے جو environment دیکھ سکتا ہے، جبکہ Secret والا masked رہتا ہے، کبھی sync یا share نہیں ہوتا، اور exports اور duplicates سے خارج رہتا ہے۔ key دوسری قسم میں آتی ہے: اسے variable کی value کے طور پر درج کریں۔ پھر cheaptokens environment منتخب کریں تاکہ درخواست اسے دیکھ سکے۔
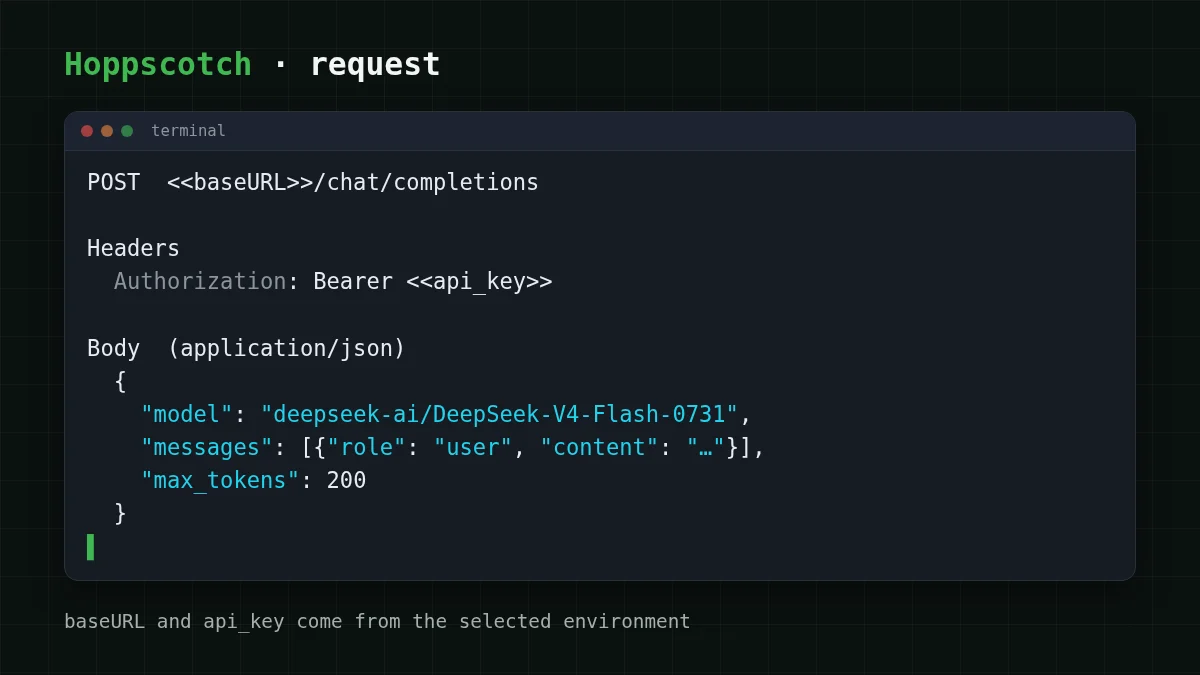
درخواستوں میں، variable کو <<name>> کی طرح لکھا جاتا ہے: <<baseURL>> اور <<api_key>>۔ بس یہی پوری ترکیب ہے۔
درخواست بنائیں#
Hoppscotch کھولنے پر REST فعال mode ہوتا ہے۔ تین چیزیں سیٹ کرنی ہیں۔
Method اور URL۔ dropdown میں POST منتخب کریں اور درج کریں:
<<baseURL>>/chat/completionskey۔ Hoppscotch کے Authorization tab میں Bearer type ہے اور یہ token کو درخواست میں Bearer <token> کے طور پر شامل کرتا ہے۔ دستاویزات نہیں بتاتیں کہ <<api_key>> اس token field کے اندر کام کرتا ہے یا نہیں، اس لیے محفوظ راستہ اختیار کریں: Headers tab کھولیں اور ایک header شامل کریں۔
Authorization: Bearer <<api_key>>آپ variable کو کہیں ہاتھ سے تبدیل نہیں کرتے، اور اصل key اس درخواست میں کبھی ظاہر نہیں ہوتی جو آپ اسکرین پر دیکھتے ہیں۔
body۔ Body tab کھولیں، Content Type dropdown میں application/json منتخب کریں (دستاویزات اسے JSON فارمیٹ میں content کی type کے طور پر درج کرتی ہیں)، اور پیسٹ کریں:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
مکمل id deepseek- استعمال کریں۔ price list کا مختصر نام API قبول نہیں کرے گا۔ DeepSeek-V4-Flash کا 380K context اور فی جواب زیادہ سے زیادہ 32,768 output tokens ہیں، اس لیے 200 ٹیسٹ کے لیے جان بوجھ کر چھوٹی cap ہے۔ کوئی دوسرا model چاہیے؟ اس ایک field کو zai- میں بدلیں (390K context، زیادہ سے زیادہ 8,192 output tokens) اور دوبارہ بھیجیں۔
چیک لسٹ
Send دبانے سے پہلے
Send دبائیں اور جواب پڑھیں#
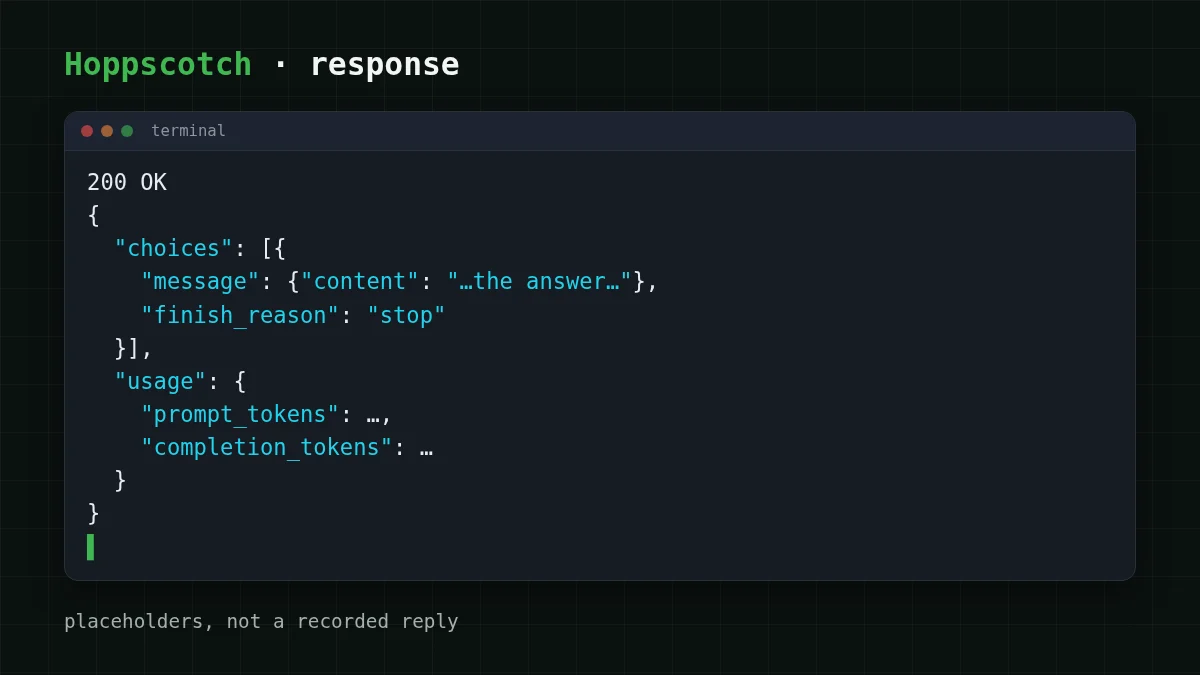
Send پر کلک کریں۔ response section status code، body، headers، cookies اور timing دکھاتا ہے۔ آپ کو 200 اور OpenAI chat completion فارمیٹ جیسا JSON body چاہیے۔ دو جگہیں اہم ہیں:
choices[0].model کا جواب ہے۔message. content usageمیںprompt_tokens(جو آپ نے بھیجا) اورcompletion_(جو model نے لکھا) ہیں۔ آپ سے اسی کی billed ہوتی ہے، اس لیے یہیں آپ چیک کرتے ہیں کہ درخواست کی لاگت توقع کے مطابق تھی۔tokens
choices[0]. بھی دیکھیں۔ stop کا مطلب ہے کہ model خود ختم ہوا۔ length کا مطلب ہے کہ آپ کی max_tokens نے جواب کاٹ دیا۔ اگر ایک جملے کے سوال پر یہ نظر آئے، تو cap بہت کم ہے۔ مزید وضاحت AI answer cut off? Fix finish_reason "length" میں ہے۔
درخواست کو collection میں محفوظ کریں تو یہ دوبارہ قابل استعمال ہو جاتی ہے: message بدلیں، دوبارہ Send دبائیں۔
ایک ٹیسٹ درخواست کی لاگت#
ایک مختصر سوال اور مختصر جواب لیں: فرض کریں 30 tokens in اور 150 out۔ ایسی ایک درخواست کی لاگت $0.000015 ہے، اور نیچے live table ان میں سے 100 کو input اور output ملا کر گنتا ہے، OpenRouter کے ساتھ۔
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 100 درخواستیں | OpenRouter، 100 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
فی درخواست 30 ان پٹ اور 150 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
مجموعی طور پر، input اور output ملا کر، یہ اسی model کے لیے OpenRouter سے سستا ہے۔ آپ کے اپنے اعداد مختلف ہوں گے، اس لیے اپنے کیس پر sliders گھسیٹیں:
لاگت کیلکولیٹر
اوپر جیسی سو ٹیسٹ درخواستیں
فی درخواست ان پٹ ٹوکنز: 30 · فی درخواست آؤٹ پٹ ٹوکنز: 150 · فی دن درخواستیں: 100
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
قیمتیں فی model مقرر ہیں، کوئی peak-hour pricing نہیں، اور ایک balance تمام models کو cover کرتا ہے۔ موجودہ rates pricing page پر ہیں۔
اگر کام نہ کرے#
REST client میں پہلی درخواست کی زیادہ تر ناکامیاں تین fields سے آتی ہیں۔ علامت کو وجہ سے ملائیں:
جوڑے ملائیں
ہر علامت کو اس کی وجہ سے ملائیں
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- 401 Unauthorizedkey غائب یا غلط ہے، یا
Authorizationheader نہیں بھیجا جا رہا - 404 Not FoundURL path یا model id غلط ہے
- finish_reason "length" ہے
max_tokenscap نے جواب کاٹ دیا
پہلی دو کے لیے مکمل walk-through API 401 or 404 error: wrong key, base URL or model id میں ہے۔ اگر آپ کو یقین نہیں کہ کون سا id استعمال کرنا ہے، تو list models with GET /v1/models۔
آگے کہاں جائیں#
یہی درخواست دوسرے clients میں بھی کام کرتی ہے: Postman version یا VS Code .http file دیکھیں۔ اگر آپ keys کو files اور shells سے بالکل باہر رکھنا چاہتے ہیں، تو store an API key safely بنیادی باتیں بتاتا ہے۔ Model ids اور OpenAI-compatible endpoint کی وضاحت docs میں ہے۔


