Erste SchritteAnleitung
Erste Anfrage an CheapTokens in Hoppscotch: Schlüssel in einer Umgebung
Sende deine erste Chat-Completion aus dem Hoppscotch-Webclient: Basis-URL und Schlüssel in einer Umgebung, ein JSON-Body und wo du die Antwort und die Nutzung liest.
Auf dieser Seite
Du kannst deine erste CheapTokens-Anfrage in Hoppscotch stellen, ohne etwas zu installieren oder Code zu schreiben: Öffne die Web-App, trage die Basis-URL und deinen Schlüssel in eine Umgebung ein, baue eine POST /-Anfrage und drücke Send. Die Antwort und die Token-Zahlen erscheinen im Antwortbereich.
Das Einzige, was sorgfältig gemacht werden sollte, ist der Schlüssel. Wenn du ihn direkt in die Anfrage einfügst, landet er in jedem Screenshot und jedem geteilten Link. Eine Umgebungsvariable hält ihn an einer Stelle.
Diese Anleitung folgt der offiziellen Hoppscotch-Dokumentation (geprüft am 9. November 2026; die Seiten tragen keine Version oder kein Datum). Auf der API-Seite ist die CheapTokens-Basis-URL https:/, die das OpenAI-Chat-Completions-Format spricht. Mehr zu beidem in der CheapTokens-Dokumentation.
Basis-URL und Schlüssel in eine Umgebung eintragen#
Hoppscotch hat ein Environments-Symbol in der Seitenleiste. Klicke darauf, erstelle eine neue Umgebung, nenne sie cheaptokens und füge zwei Variablen hinzu:
Tabelle nach rechts scrollen →
| Variable | Typ | Wert |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | dein CheapTokens-Schlüssel |
Warum zwei Typen? Laut der Hoppscotch-Dokumentation ist eine Regular-Variable für alle sichtbar, die die Umgebung sehen können, während eine Secret-Variable maskiert, nie synchronisiert oder geteilt und aus Exporten und Duplikaten ausgelassen wird. Ein Schlüssel gehört in die zweite Art: Gib ihn als Wert der Variable ein. Wähle dann die Umgebung cheaptokens aus, damit die Anfrage sie sehen kann.
In Anfragen wird eine Variable als <<name>> geschrieben: <<baseURL>> und <<api_key>>. Das ist der ganze Trick.
Die Anfrage bauen#
REST ist der aktive Modus, wenn du Hoppscotch öffnest. Drei Dinge sind einzustellen.
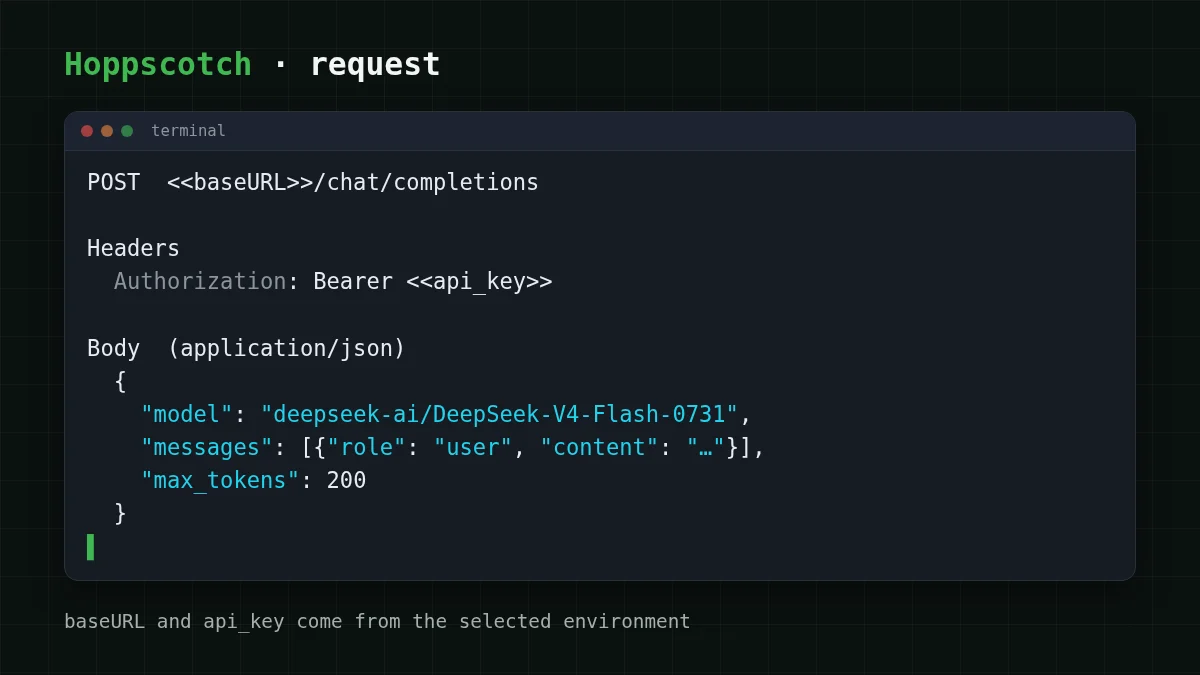
Methode und URL. Wähle POST im Dropdown und gib ein:
<<baseURL>>/chat/completionsDer Schlüssel. Der Authorization-Tab von Hoppscotch hat einen Bearer-Typ und fügt das Token der Anfrage als Bearer <token> hinzu. Die Dokumentation sagt nicht, ob <<api_key>> in diesem Token-Feld funktioniert, also nutze den sicheren Weg: Öffne den Headers-Tab und füge einen Header hinzu.
Authorization: Bearer <<api_key>>Du ersetzt die Variable nirgends von Hand, und der echte Schlüssel erscheint nie in der Anfrage, die du auf dem Bildschirm siehst.
Der Body. Öffne den Body-Tab, wähle application/json im Content-Type-Dropdown (die Dokumentation listet ihn als Typ für Inhalte im JSON-Format) und füge ein:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
Verwende die vollständige ID deepseek-. Der Kurzname aus einer Preisliste wird von der API nicht akzeptiert. DeepSeek-V4-Flash hat einen 380K-Kontext und bis zu 32.768 Ausgabe-Token pro Antwort, also sind 200 eine bewusst kleine Obergrenze für einen Test. Willst du ein anderes Modell? Ändere dieses eine Feld auf zai- (390K-Kontext, bis zu 8.192 Ausgabe-Token) und sende erneut.
Checkliste
Bevor du Send drückst
Send drücken und die Antwort lesen#
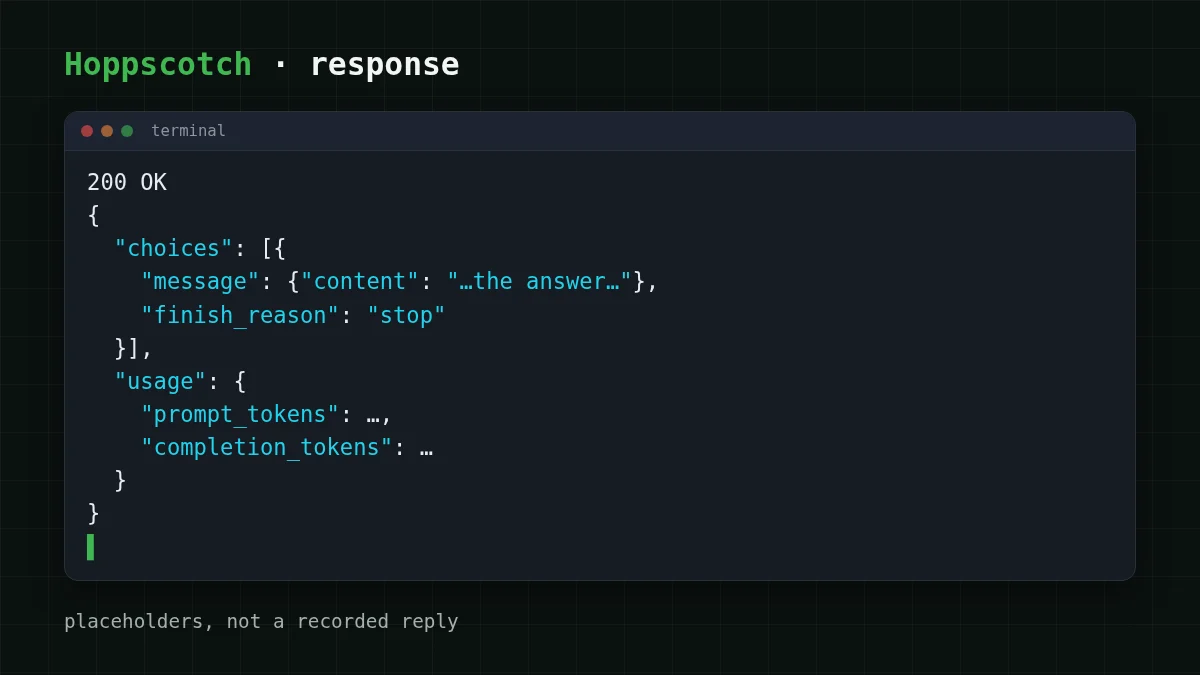
Klicke auf Send. Der Antwortbereich zeigt den Statuscode, Body, Header, Cookies und Timing. Du willst 200 und einen JSON-Body, der wie das OpenAI-Chat-Completion-Format geformt ist. Zwei Stellen sind wichtig:
choices[0].ist die Antwort des Modells.message. content usageenthältprompt_tokens(was du gesendet hast) undcompletion_(was das Modell geschrieben hat). Dafür wirst du abgerechnet, also prüfst du hier, ob eine Anfrage so viel gekostet hat, wie du erwartet hast.tokens
Schau dir auch choices[0]. an. stop bedeutet, dass das Modell von selbst fertig wurde. length bedeutet, dass deine max_tokens die Antwort abgeschnitten hat. Wenn du das bei einer Ein-Satz-Frage siehst, ist die Obergrenze zu niedrig. Eine längere Erklärung gibt es in AI answer cut off? Fix finish_reason "length".
Speichere die Anfrage in einer Sammlung, und sie ist wiederverwendbar: Ändere die Nachricht, drücke erneut Send.
Was eine Testanfrage kostet#
Nimm eine kurze Frage und eine kurze Antwort: sagen wir 30 Token rein und 150 raus. Eine solche Anfrage kostet $0.000015, und die Live-Tabelle unten zählt 100 davon mit Input und Output zusammen, neben OpenRouter.
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 100 Anfragen | OpenRouter, 100 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 Input- und 150 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Insgesamt, mit Input und Output zusammengezählt, ist das für dasselbe Modell günstiger als OpenRouter. Deine eigenen Zahlen werden abweichen, also zieh die Schieberegler für deinen eigenen Fall:
Kostenrechner
Hundert Testanfragen wie die obige
Eingabe-Tokens pro Anfrage: 30 · Ausgabe-Tokens pro Anfrage: 150 · Anfragen pro Tag: 100
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
Die Preise sind pro Modell fest, ohne Stoßzeiten-Preise, und ein Guthaben deckt alle Modelle ab. Die aktuellen Tarife stehen auf der Preisseite.
Wenn es nicht funktioniert#
Die meisten Fehler bei der ersten Anfrage in einem REST-Client kommen von drei Feldern. Ordne das Symptom der Ursache zu:
Paare zuordnen
Ordne jedes Symptom seiner Ursache zu
Tippe auf ein Element links, dann auf sein Paar
- 401 UnauthorizedDer Schlüssel fehlt oder ist falsch, oder der Header
Authorizationwird nicht gesendet - 404 Not FoundDer URL-Pfad oder die Modell-ID ist falsch
- finish_reason ist "length"Die Obergrenze
max_tokenshat die Antwort abgeschnitten
Für die ersten beiden gibt es eine vollständige Schritt-für-Schritt-Anleitung in API 401 or 404 error: wrong key, base URL or model id. Wenn du nicht sicher bist, welche ID du verwenden sollst, list models with GET /v1/models.
Wie es weitergeht#
Dieselbe Anfrage funktioniert in anderen Clients: Sieh dir die Postman-Version oder die VS Code .http-Datei an. Wenn du Schlüssel lieber ganz aus Dateien und Shells heraushalten willst, deckt store an API key safely die Grundlagen ab. Modell-IDs und der OpenAI-kompatible Endpunkt sind in der Dokumentation beschrieben.


