শুরু করাগাইড
Hoppscotch-এ CheapTokens-এ প্রথম অনুরোধ: environment-এ কী
Hoppscotch ওয়েব ক্লায়েন্ট থেকে আপনার প্রথম chat completion পাঠান: environment-এ বেস URL ও কী, একটি JSON বডি, এবং উত্তর ও usage কোথায় পড়বেন।
এই পৃষ্ঠায়
আপনি কিছু ইনস্টল না করে বা কোড না লিখেই Hoppscotch-এ আপনার প্রথম CheapTokens অনুরোধ করতে পারেন: ওয়েব অ্যাপটি খুলুন, বেস URL এবং আপনার কী একটি environment-এ রাখুন, একটি POST / অনুরোধ তৈরি করুন, Send চাপুন। উত্তর এবং টোকেন গণনা response প্যানেলে দেখা যাবে।
শুধু একটি জিনিস সাবধানে করা উচিত — কী-টি। যদি আপনি এটি সরাসরি অনুরোধে পেস্ট করেন, তাহলে এটি প্রতিটি স্ক্রিনশট এবং প্রতিটি শেয়ার করা লিংকে চলে যাবে। একটি environment variable এটি এক জায়গায় রাখে।
এই গাইডটি অফিসিয়াল Hoppscotch ডকুমেন্টেশন অনুসরণ করে (যাচাই করা হয়েছে ৯ নভেম্বর ২০২৬; পৃষ্ঠাগুলিতে কোনো সংস্করণ বা তারিখ নেই)। API-এর দিকটি হলো CheapTokens বেস URL https:/, যা OpenAI Chat Completions ফরম্যাটে কথা বলে। উভয় সম্পর্কে আরও জানুন CheapTokens ডকুমেন্টেশন-এ।
বেস URL এবং কী একটি environment-এ রাখুন#
Hoppscotch-এর সাইডবারে একটি Environments আইকন আছে। এটিতে ক্লিক করুন, একটি নতুন environment তৈরি করুন, এর নাম দিন cheaptokens, এবং দুটি ভেরিয়েবল যোগ করুন:
টেবিলটি ডানদিকে স্ক্রোল করুন →
| Variable | Type | Value |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | আপনার CheapTokens কী |
কেন দুটি ধরন? Hoppscotch ডকুমেন্টেশন অনুযায়ী, একটি Regular ভেরিয়েবল সেই সবাই দেখতে পায় যারা environment-টি দেখতে পারে, আর একটি Secret ভেরিয়েবল মাস্ক করা থাকে, কখনো সিঙ্ক বা শেয়ার হয় না, এবং এক্সপোর্ট ও ডুপ্লিকেট থেকে বাদ পড়ে। একটি কী দ্বিতীয় ধরনেরই হওয়া উচিত: এটি ভেরিয়েবলের মান হিসেবে লিখুন। তারপর cheaptokens environment-টি নির্বাচন করুন যাতে অনুরোধটি এটি দেখতে পারে।
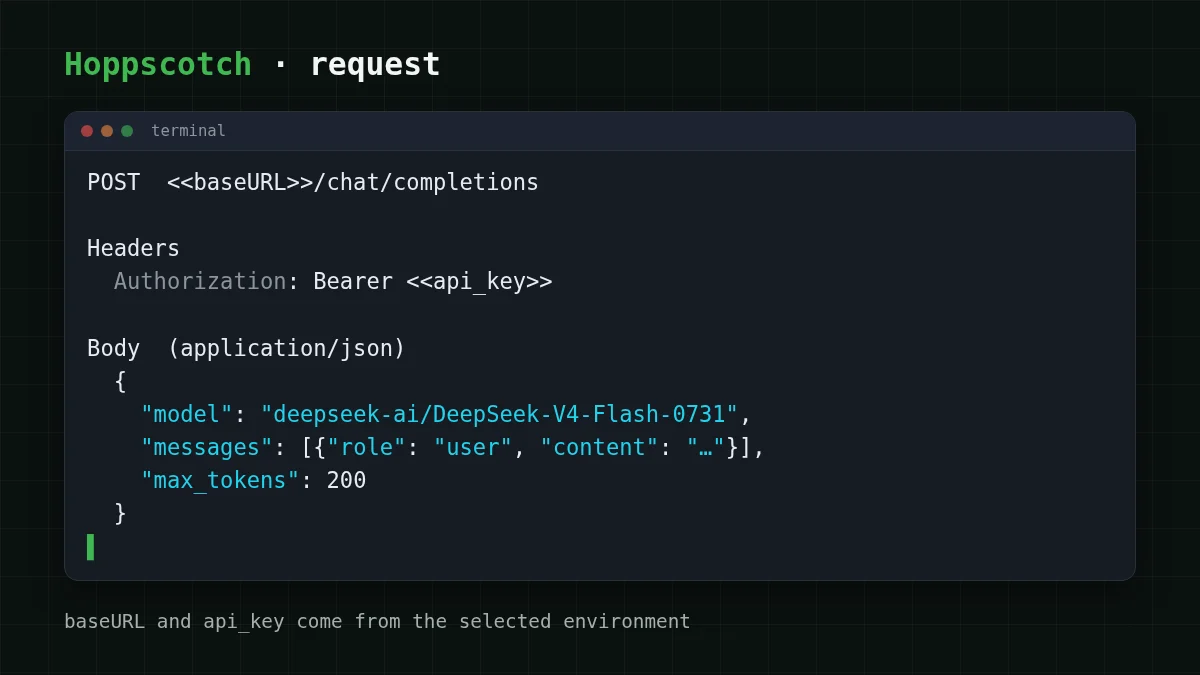
অনুরোধে, একটি ভেরিয়েবল লেখা হয় <<name>> হিসেবে: <<baseURL>> এবং <<api_key>>। এটাই পুরো কৌশল।
অনুরোধ তৈরি করুন#
Hoppscotch খোলার সময় REST সক্রিয় মোড। তিনটি জিনিস সেট করতে হবে।
মেথড এবং URL। ড্রপডাউনে POST বেছে নিন এবং লিখুন:
<<baseURL>>/chat/completionsকী। Hoppscotch-এর Authorization ট্যাবে একটি Bearer ধরন আছে এবং এটি টোকেনটি অনুরোধে Bearer <token> হিসেবে যোগ করে। ডকুমেন্টেশন বলে না যে <<api_key>> সেই টোকেন ফিল্ডের ভিতরে কাজ করে কি না, তাই নিশ্চিত পথটি ব্যবহার করুন: Headers ট্যাব খুলুন এবং একটি হেডার যোগ করুন।
Authorization: Bearer <<api_key>>আপনি কোথাও হাতে ভেরিয়েবল প্রতিস্থাপন করবেন না, এবং আসল কী কখনোই স্ক্রিনে দেখা অনুরোধে প্রকাশ পাবে না।
বডি। Body ট্যাব খুলুন, Content Type ড্রপডাউনে application/json বেছে নিন (ডকুমেন্টেশন এটিকে JSON ফরম্যাটে কন্টেন্টের ধরন হিসেবে তালিকাভুক্ত করে), এবং পেস্ট করুন:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
সম্পূর্ণ id deepseek- ব্যবহার করুন। একটি মূল্য তালিকার সংক্ষিপ্ত নাম API গ্রহণ করবে না। DeepSeek-V4-Flash-এর 380K কনটেক্সট এবং প্রতি উত্তরে সর্বোচ্চ 32,768 আউটপুট টোকেন আছে, তাই পরীক্ষার জন্য 200 ইচ্ছাকৃতভাবে ছোট একটি সীমা। ভিন্ন মডেল চান? সেই একটি ফিল্ড zai--এ পরিবর্তন করুন (390K কনটেক্সট, সর্বোচ্চ 8,192 আউটপুট টোকেন) এবং আবার পাঠান।
চেকলিস্ট
Send চাপার আগে
Send চাপুন এবং উত্তর পড়ুন#
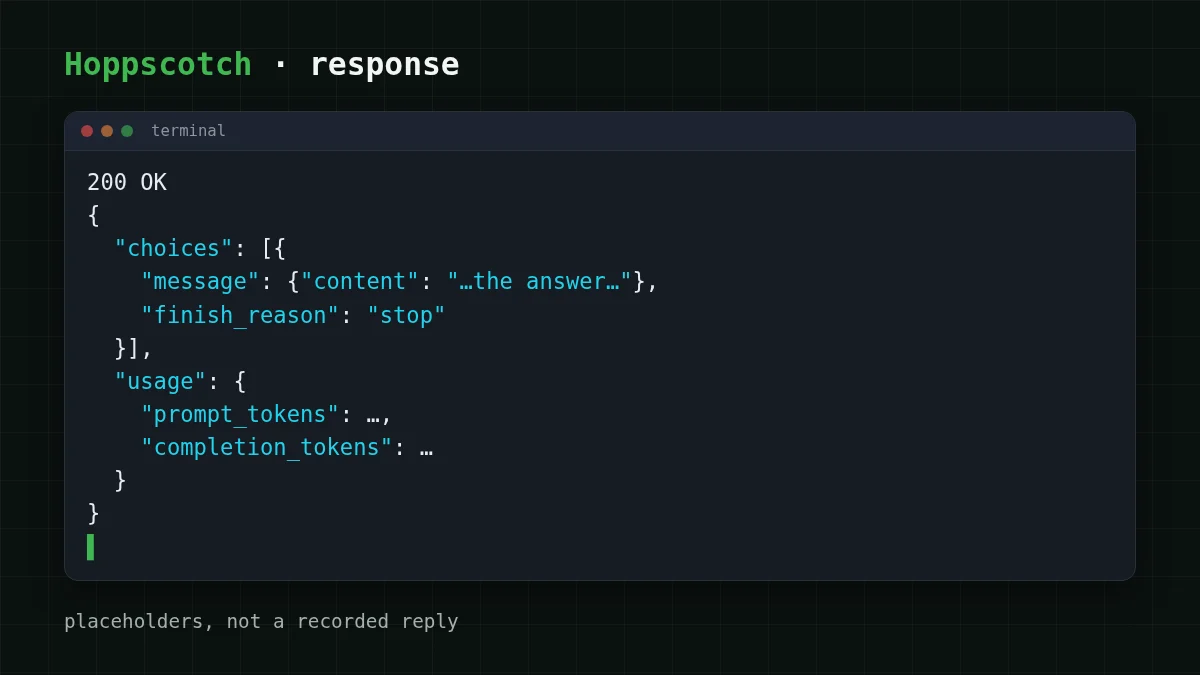
Send-এ ক্লিক করুন। response বিভাগটি স্ট্যাটাস কোড, বডি, হেডার, কুকি এবং টাইমিং দেখায়। আপনি 200 এবং OpenAI chat completion ফরম্যাটের মতো একটি JSON বডি চান। দুটি জায়গা গুরুত্বপূর্ণ:
choices[0].হলো মডেলের উত্তর।message. content usage-এ আছেprompt_tokens(আপনি যা পাঠিয়েছেন) এবংcompletion_(মডেল যা লিখেছে)। এটির জন্যই আপনাকে বিল করা হয়, তাই এখানেই আপনি যাচাই করেন যে একটি অনুরোধ আপনার প্রত্যাশিত খরচ করেছে কি না।tokens
choices[0].-ও দেখুন। stop মানে মডেল নিজে থেকেই শেষ করেছে। length মানে আপনার max_tokens উত্তরটি কেটে দিয়েছে। যদি এক-বাক্যের প্রশ্নে এটি দেখেন, তাহলে সীমাটি খুব কম। আরও বিস্তারিত ব্যাখ্যা আছে AI উত্তর কেটে গেছে? finish_reason "length" ঠিক করুন-এ।
অনুরোধটি একটি collection-এ সংরক্ষণ করুন এবং এটি পুনরায় ব্যবহারযোগ্য: বার্তা পরিবর্তন করুন, আবার Send চাপুন।
একটি পরীক্ষামূলক অনুরোধের খরচ#
একটি ছোট প্রশ্ন এবং একটি ছোট উত্তর নিন: ধরা যাক 30 টোকেন ইন এবং 150 আউট। এমন একটি অনুরোধের খরচ $0.000015, এবং নিচের লাইভ টেবিলটি ইনপুট ও আউটপুট একসাথে ধরে এরকম 100টি গণনা করে, OpenRouter-এর পাশে।
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১০০টি অনুরোধ | OpenRouter, ১০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
প্রতি অনুরোধে ৩০ ইনপুট এবং ১৫০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
সামগ্রিকভাবে, ইনপুট ও আউটপুট একসাথে গণনা করলে, একই মডেলের জন্য এটি OpenRouter-এর চেয়ে সস্তা। আপনার নিজের সংখ্যা ভিন্ন হবে, তাই আপনার নিজের ক্ষেত্রে স্লাইডারগুলি টানুন:
খরচ ক্যালকুলেটর
উপরের মতো একশোটি পরীক্ষামূলক অনুরোধ
প্রতি অনুরোধে ইনপুট টোকেন: ৩০ · প্রতি অনুরোধে আউটপুট টোকেন: ১৫০ · প্রতিদিন অনুরোধ: ১০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
মূল্য প্রতি মডেলে নির্ধারিত, কোনো পিক-আওয়ার মূল্য নেই, এবং একটি ব্যালেন্স সব মডেল কভার করে। বর্তমান হার মূল্য পৃষ্ঠা-এ আছে।
যদি এটি কাজ না করে#
একটি REST ক্লায়েন্টে প্রথম অনুরোধের বেশিরভাগ ব্যর্থতা তিনটি ফিল্ড থেকে আসে। লক্ষণটি কারণের সাথে মিলিয়ে নিন:
জোড়া মেলান
প্রতিটি লক্ষণকে তার কারণের সাথে মিলিয়ে নিন
বাম দিকের একটি আইটেমে ট্যাপ করুন, তারপর তার জোড়ায়
- 401 Unauthorizedকী অনুপস্থিত বা ভুল, অথবা
Authorizationহেডার পাঠানো হচ্ছে না - 404 Not FoundURL পাথ বা মডেল id ভুল
- finish_reason হলো "length"
max_tokensসীমা উত্তরটি কেটে দিয়েছে
প্রথম দুটির জন্য একটি সম্পূর্ণ নির্দেশিকা আছে API 401 বা 404 ত্রুটি: ভুল কী, বেস URL বা মডেল id-এ। কোন id ব্যবহার করবেন তা নিশ্চিত না হলে, GET /v1/models দিয়ে মডেল তালিকাভুক্ত করুন।
এরপর কোথায় যাবেন#
একই অনুরোধ অন্যান্য ক্লায়েন্টেও কাজ করে: দেখুন Postman সংস্করণ বা VS Code .http ফাইল। যদি আপনি কী ফাইল ও শেল থেকে সম্পূর্ণ দূরে রাখতে চান, একটি API কী নিরাপদে সংরক্ষণ করুন মূল বিষয়গুলি কভার করে। মডেল id এবং OpenAI-সামঞ্জস্যপূর্ণ endpoint বর্ণনা করা আছে ডকুমেন্টেশন-এ।


