MemulaiPanduan
Permintaan pertama ke CheapTokens di Hoppscotch: kunci di environment
Kirim chat completion pertama Anda dari klien web Hoppscotch: base URL dan kunci di environment, body JSON, dan tempat membaca balasan serta usage.
Di halaman ini
Anda dapat membuat permintaan CheapTokens pertama Anda di Hoppscotch tanpa menginstal apa pun atau menulis kode: buka aplikasi web, masukkan base URL dan kunci Anda ke dalam environment, buat satu permintaan POST /, tekan Send. Jawaban dan jumlah token muncul di panel respons.
Satu-satunya hal yang perlu dilakukan dengan hati-hati adalah kuncinya. Jika Anda menempelkannya langsung ke permintaan, kunci itu akan muncul di setiap tangkapan layar dan setiap tautan yang dibagikan. Variabel environment menyimpannya di satu tempat.
Panduan ini mengikuti dokumentasi resmi Hoppscotch (diperiksa 9 November 2026; halaman-halamannya tidak mencantumkan versi atau tanggal). Sisi API adalah base URL CheapTokens https:/, yang berbicara dalam format OpenAI Chat Completions. Selengkapnya tentang keduanya di dokumentasi CheapTokens.
Masukkan base URL dan kunci ke dalam environment#
Hoppscotch memiliki ikon Environments di sidebar. Klik ikon itu, buat environment baru, beri nama cheaptokens, dan tambahkan dua variabel:
Gulir tabel ke kanan →
| Variabel | Tipe | Nilai |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | kunci CheapTokens Anda |
Mengapa dua tipe? Menurut dokumentasi Hoppscotch, variabel Regular terlihat oleh semua orang yang dapat melihat environment, sedangkan variabel Secret disamarkan, tidak pernah disinkronkan atau dibagikan, dan dikeluarkan dari ekspor serta duplikasi. Kunci termasuk jenis kedua: masukkan sebagai nilai variabel. Lalu pilih environment cheaptokens agar permintaan dapat melihatnya.
Dalam permintaan, variabel ditulis sebagai <<name>>: <<baseURL>> dan <<api_key>>. Itulah seluruh triknya.
Bangun permintaan#
REST adalah mode aktif saat Anda membuka Hoppscotch. Ada tiga hal yang harus diatur.
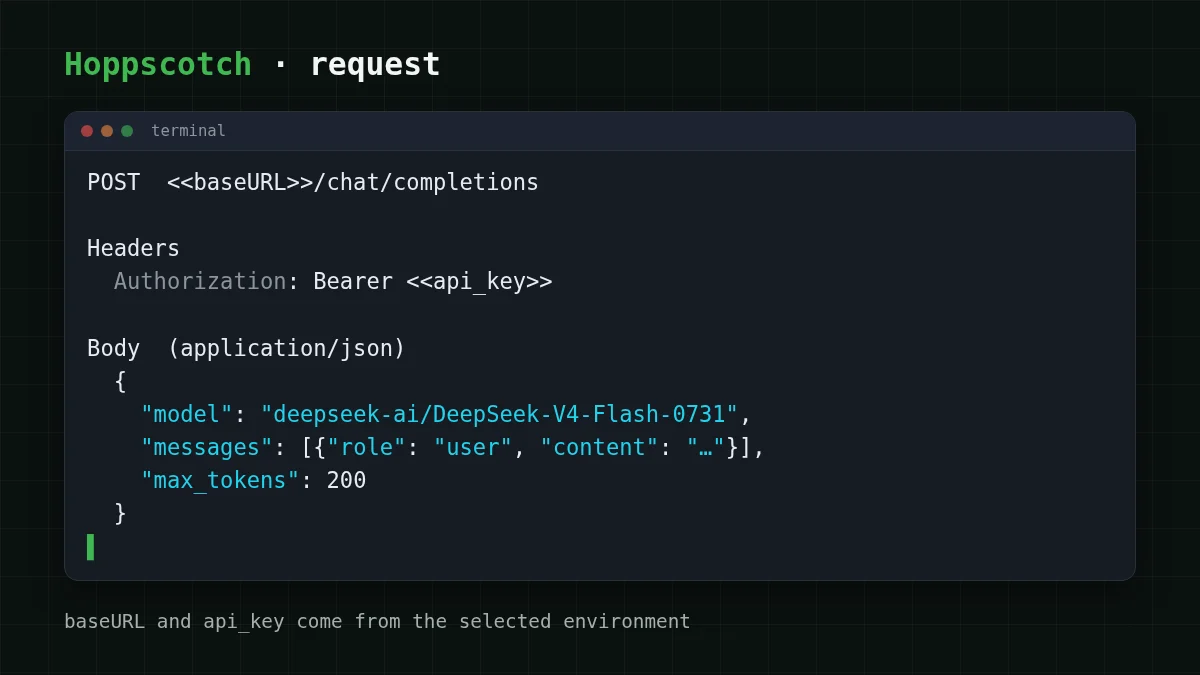
Method dan URL. Pilih POST di dropdown dan masukkan:
<<baseURL>>/chat/completionsKuncinya. Tab Authorization Hoppscotch memiliki tipe Bearer dan menambahkan token ke permintaan sebagai Bearer <token>. Dokumentasi tidak menyebutkan apakah <<api_key>> berfungsi di dalam kolom token tersebut, jadi gunakan cara yang pasti: buka tab Headers dan tambahkan satu header.
Authorization: Bearer <<api_key>>Anda tidak perlu mengganti variabel secara manual di mana pun, dan kunci asli tidak pernah muncul dalam permintaan yang Anda lihat di layar.
Body-nya. Buka tab Body, pilih application/json di dropdown Content Type (dokumentasi mencantumkannya sebagai tipe untuk konten berformat JSON), dan tempelkan:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
Gunakan id lengkap deepseek-. Nama pendek dari daftar harga tidak akan diterima oleh API. DeepSeek-V4-Flash memiliki konteks 380K dan hingga 32.768 token output per jawaban, jadi 200 adalah batas yang sengaja dibuat kecil untuk pengujian. Ingin model lain? Ubah satu kolom itu menjadi zai- (konteks 390K, hingga 8.192 token output) dan kirim lagi.
Daftar periksa
Sebelum menekan Send
Tekan Send dan baca balasannya#
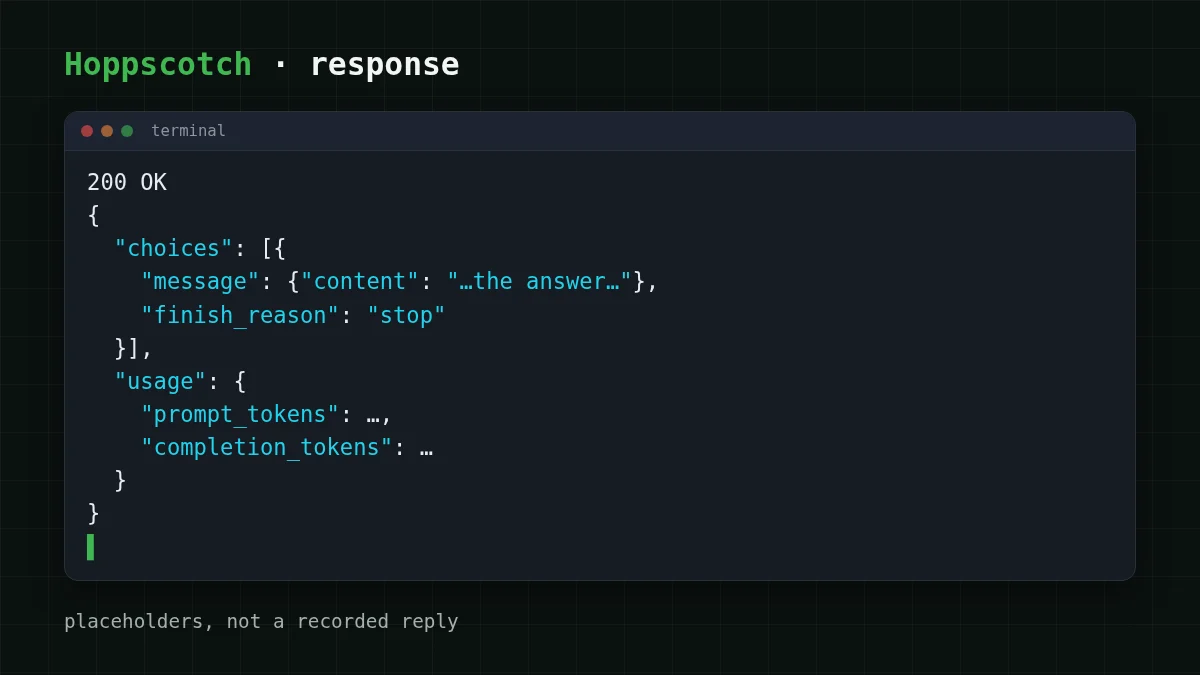
Klik Send. Bagian respons menampilkan kode status, body, header, cookie, dan waktu. Anda menginginkan 200 dan body JSON yang berbentuk seperti format chat completion OpenAI. Dua tempat yang penting:
choices[0].adalah jawaban model.message. content usageberisiprompt_tokens(yang Anda kirim) dancompletion_(yang ditulis model). Itulah yang ditagihkan kepada Anda, jadi di sinilah Anda memeriksa apakah biaya permintaan sesuai perkiraan.tokens
Perhatikan juga choices[0].. stop berarti model selesai dengan sendirinya. length berarti max_tokens Anda memotong jawaban. Jika Anda melihatnya pada pertanyaan satu kalimat, batasnya terlalu rendah. Ada penjelasan lebih panjang di Jawaban AI terpotong? Perbaiki finish_reason "length".
Simpan permintaan ke dalam collection dan permintaan itu dapat digunakan kembali: ubah pesannya, tekan Send lagi.
Berapa biaya satu permintaan uji#
Ambil pertanyaan singkat dan jawaban singkat: misalnya 30 token masuk dan 150 keluar. Satu permintaan seperti itu berbiaya $0.000015, dan tabel langsung di bawah menghitung 100 permintaan tersebut dengan input dan output digabungkan, di samping OpenRouter.
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 100 permintaan | OpenRouter, 100 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 token input dan 150 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Secara total, dengan input dan output dihitung bersama, itu lebih murah daripada OpenRouter untuk model yang sama. Angka Anda sendiri akan berbeda, jadi geser slider sesuai kasus Anda:
Kalkulator biaya
Seratus permintaan uji seperti di atas
Token input per permintaan: 30 · Token output per permintaan: 150 · Permintaan per hari: 100
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
Harga tetap per model, tanpa harga jam sibuk, dan satu saldo mencakup semua model. Tarif terkini ada di halaman harga.
Jika tidak berhasil#
Sebagian besar kegagalan permintaan pertama di klien REST berasal dari tiga kolom. Cocokkan gejala dengan penyebabnya:
Cocokkan pasangan
Cocokkan setiap gejala dengan penyebabnya
Ketuk item di kiri, lalu pasangannya
- 401 UnauthorizedKunci hilang atau salah, atau header
Authorizationtidak dikirim - 404 Not FoundPath URL atau id model salah
- finish_reason adalah "length"Batas
max_tokensmemotong jawaban
Untuk dua yang pertama ada panduan lengkap di Error API 401 atau 404: kunci, base URL, atau id model salah. Jika Anda tidak yakin id mana yang harus digunakan, daftar model dengan GET /v1/models.
Ke mana selanjutnya#
Permintaan yang sama berfungsi di klien lain: lihat versi Postman atau file .http VS Code. Jika Anda lebih suka menjauhkan kunci dari file dan shell sepenuhnya, menyimpan kunci API dengan aman membahas dasarnya. Id model dan endpoint yang kompatibel dengan OpenAI dijelaskan di dokumentasi.


