PagsisimulaGabay
Unang request sa CheapTokens sa Hoppscotch: key sa isang environment
Ipadala ang iyong unang chat completion mula sa Hoppscotch web client: base URL at key sa isang environment, isang JSON body, at kung saan babasahin ang sagot at usage.
Sa pahinang ito
Maaari mong gawin ang iyong unang CheapTokens request sa Hoppscotch nang walang iniinstall o isinusulat na code: buksan ang web app, ilagay ang base URL at ang iyong key sa isang environment, gumawa ng isang POST / request, pindutin ang Send. Lumalabas ang sagot at ang token counts sa response panel.
Ang tanging bagay na dapat gawin nang maingat ay ang key. Kung i-paste mo ito nang direkta sa request, mapupunta ito sa bawat screenshot at bawat shared link. Ang environment variable ay nagpapanatili nito sa isang lugar.
Sinusundan ng gabay na ito ang opisyal na Hoppscotch docs (sinuri noong 9 Nobyembre 2026; walang version o petsa ang mga pahina). Ang API side ay ang CheapTokens base URL https:/, na gumagamit ng OpenAI Chat Completions format. Higit pa sa pareho sa CheapTokens docs.
Ilagay ang base URL at ang key sa isang environment#
May Environments icon ang Hoppscotch sa sidebar. I-click ito, gumawa ng bagong environment, pangalanan itong cheaptokens, at magdagdag ng dalawang variable:
I-scroll ang table pakanan →
| Variable | Type | Value |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | ang iyong CheapTokens key |
Bakit dalawang type? Ayon sa Hoppscotch docs, ang Regular variable ay nakikita ng lahat ng makakakita ng environment, habang ang Secret ay naka-mask, hindi kailanman nisi-sync o nishare, at hindi kasama sa exports at duplicates. Ang key ay nabibilang sa pangalawang uri: ilagay ito bilang value ng variable. Pagkatapos, piliin ang cheaptokens environment para makita ito ng request.
Sa mga request, ang variable ay isinusulat bilang <<name>>: <<baseURL>> at <<api_key>>. Iyon na ang buong trick.
Buuin ang request#
REST ang aktibong mode kapag binuksan mo ang Hoppscotch. Tatlong bagay ang dapat itakda.
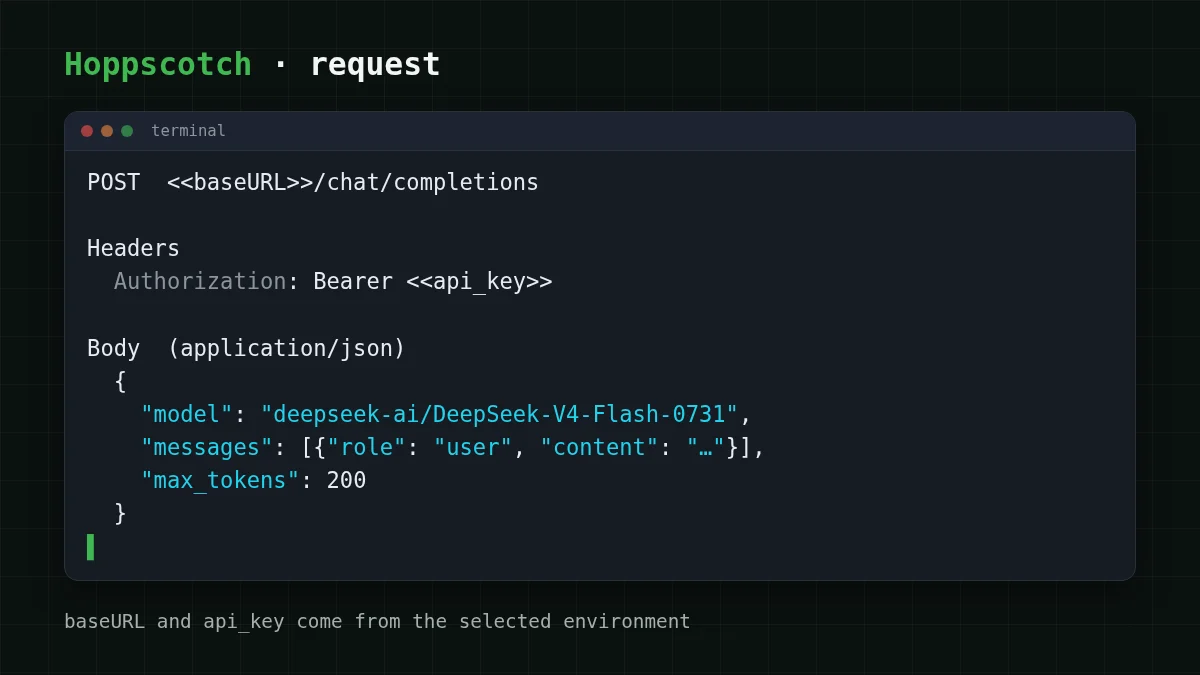
Method at URL. Piliin ang POST sa dropdown at ilagay:
<<baseURL>>/chat/completionsAng key. May Bearer type ang Authorization tab ng Hoppscotch at idinadagdag ang token sa request bilang Bearer <token>. Hindi sinasabi ng docs kung gumagana ang <<api_key>> sa loob ng token field na iyon, kaya gamitin ang siguradong paraan: buksan ang Headers tab at magdagdag ng isang header.
Authorization: Bearer <<api_key>>Wala kang manu-manong pinapalitan na variable, at hindi kailanman lumalabas ang tunay na key sa request na nakikita mo sa screen.
Ang body. Buksan ang Body tab, piliin ang application/json sa Content Type dropdown (inililista ito ng docs bilang type para sa content sa JSON format), at i-paste:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
Gamitin ang buong id deepseek-. Hindi tatanggapin ng API ang maikling pangalan mula sa price list. Ang DeepSeek-V4-Flash ay may 380K context at hanggang 32,768 output tokens bawat sagot, kaya ang 200 ay sadyang maliit na cap para sa test. Gusto ng ibang model? Palitan ang field na iyon ng zai- (390K context, hanggang 8,192 output tokens) at mag-send muli.
Listahan ng dapat gawin
Bago pindutin ang Send
Pindutin ang Send at basahin ang sagot#
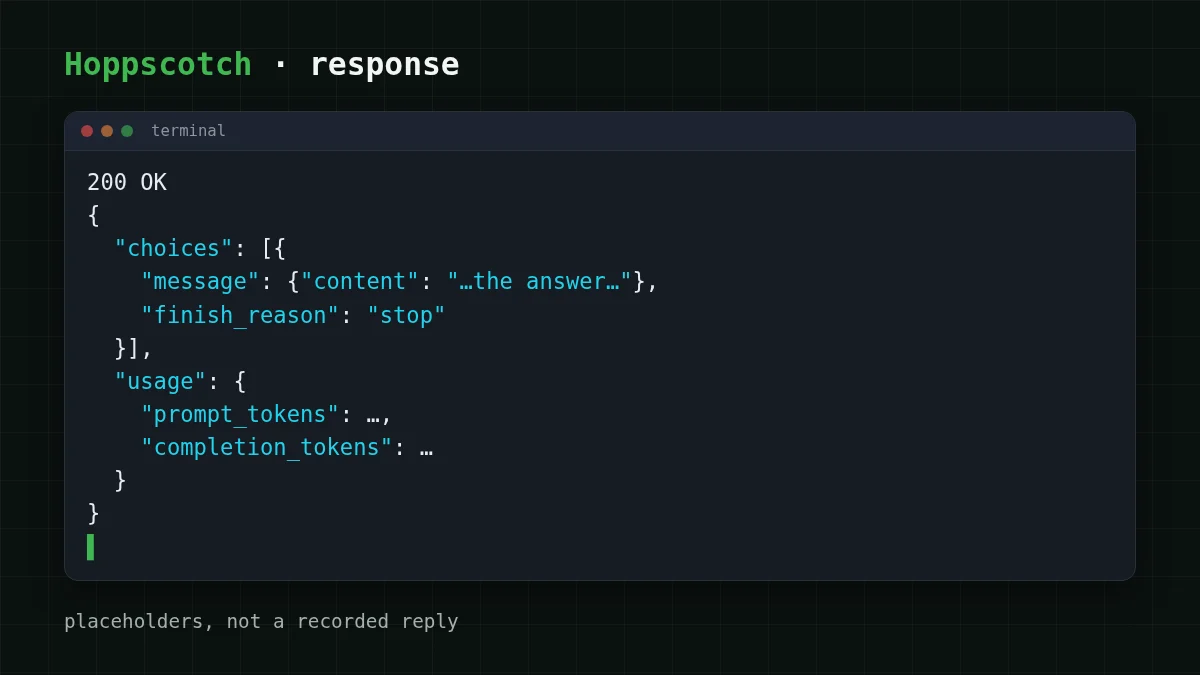
I-click ang Send. Ipinapakita ng response section ang status code, body, headers, cookies at timing. Gusto mo ang 200 at isang JSON body na hugis OpenAI chat completion format. Dalawang lugar ang mahalaga:
- Ang
choices[0].ay ang sagot ng model.message. content - Ang
usageay mayprompt_tokens(ang ipinadala mo) atcompletion_(ang isinulat ng model). Iyon ang binabayaran mo, kaya dito mo sinusuri kung ang isang request ay nagkakahalaga ng inaasahan mo.tokens
Tingnan din ang choices[0].. Ang stop ay nangangahulugang natapos ang model nang kusa. Ang length ay nangangahulugang pinutol ng iyong max_tokens ang sagot. Kung nakita mo iyon sa isang tanong na isang pangungusap, masyadong mababa ang cap. May mas mahabang paliwanag sa AI answer cut off? Fix finish_reason "length".
I-save ang request sa isang collection at magagamit muli ito: palitan ang mensahe, pindutin muli ang Send.
Magkano ang isang test request#
Kumuha ng maikling tanong at maikling sagot: sabihin nating 30 tokens in at 150 out. Ang isang ganoong request ay nagkakahalaga ng $0.000015, at ang live table sa ibaba ay nagbibilang ng 100 sa kanila kasama ang input at output, katabi ng OpenRouter.
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 100 mga kahilingan | OpenRouter, 100 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 input at 150 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa kabuuan, kasama ang input at output, mas mura iyon kaysa OpenRouter para sa parehong model. Mag-iiba ang sarili mong numero, kaya i-drag ang mga slider sa sarili mong kaso:
Calculator ng gastos
Isang daang test request na tulad ng nasa itaas
Mga input token bawat kahilingan: 30 · Mga output token bawat kahilingan: 150 · Mga kahilingan bawat araw: 100
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
Ang mga presyo ay fixed per model, walang peak-hour pricing, at isang balance ang sumasaklaw sa lahat ng model. Ang kasalukuyang rates ay nasa pricing page.
Kung hindi gumana#
Karamihan ng first-request failure sa REST client ay nagmumula sa tatlong field. Itugma ang sintomas sa sanhi:
Itugma ang mga pares
Itugma ang bawat sintomas sa sanhi nito
I-tap ang isang item sa kaliwa, pagkatapos ang pares nito
- 401 UnauthorizedKulang o mali ang key, o hindi ipinapadala ang
Authorizationheader - 404 Not FoundMali ang URL path o ang model id
- finish_reason is "length"Pinutol ng
max_tokenscap ang sagot
Para sa unang dalawa may buong walk-through sa API 401 or 404 error: wrong key, base URL or model id. Kung hindi ka sigurado kung aling id ang gagamitin, list models with GET /v1/models.
Saan pupunta susunod#
Gumagana ang parehong request sa ibang client: tingnan ang Postman version o ang VS Code .http file. Kung mas gusto mong ilayo ang mga key sa mga file at shell, sinasaklaw ng store an API key safely ang mga basic. Ang mga model id at ang OpenAI-compatible endpoint ay inilalarawan sa docs.


