Premiers pasGuide
Première requête vers CheapTokens dans Hoppscotch : la clé dans un environnement
Envoyez votre première chat completion depuis le client web Hoppscotch : URL de base et clé dans un environnement, un corps JSON, et où lire la réponse et l'usage.
Sur cette page
Vous pouvez effectuer votre première requête CheapTokens dans Hoppscotch sans rien installer ni écrire de code : ouvrez l'application web, placez l'URL de base et votre clé dans un environnement, construisez une requête POST /, appuyez sur Send. La réponse et les décomptes de tokens s'affichent dans le panneau de réponse.
Le seul point à soigner est la clé. Si vous la collez directement dans la requête, elle finit dans chaque capture d'écran et chaque lien partagé. Une variable d'environnement la garde à un seul endroit.
Ce guide suit la documentation officielle de Hoppscotch (vérifiée le 9 novembre 2026 ; les pages ne portent ni version ni date). Côté API, l'URL de base CheapTokens est https:/, qui parle le format OpenAI Chat Completions. Plus de détails sur les deux dans la documentation CheapTokens.
Placez l'URL de base et la clé dans un environnement#
Hoppscotch a une icône Environments dans la barre latérale. Cliquez dessus, créez un nouvel environnement, nommez-le cheaptokens et ajoutez deux variables :
Faites défiler le tableau vers la droite →
| Variable | Type | Valeur |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | votre clé CheapTokens |
Pourquoi deux types ? D'après la documentation Hoppscotch, une variable Regular est visible par tous ceux qui peuvent voir l'environnement, tandis qu'une variable Secret est masquée, jamais synchronisée ni partagée, et exclue des exports et des duplications. Une clé relève du second type : saisissez-la comme valeur de la variable. Sélectionnez ensuite l'environnement cheaptokens pour que la requête puisse le voir.
Dans les requêtes, une variable s'écrit <<name>> : <<baseURL>> et <<api_key>>. C'est toute l'astuce.
Construisez la requête#
REST est le mode actif à l'ouverture de Hoppscotch. Trois choses à régler.
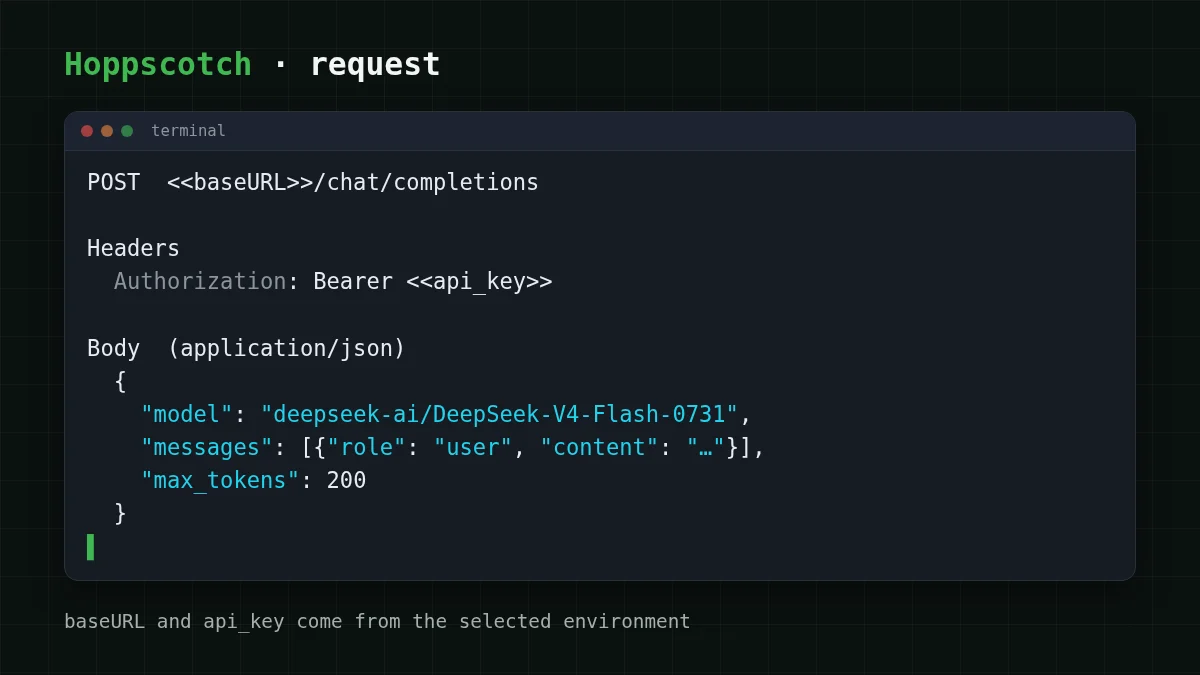
Méthode et URL. Choisissez POST dans la liste déroulante et saisissez :
<<baseURL>>/chat/completionsLa clé. L'onglet Authorization de Hoppscotch propose un type Bearer et ajoute le token à la requête sous la forme Bearer <token>. La documentation ne précise pas si <<api_key>> fonctionne dans ce champ de token, alors empruntez la voie sûre : ouvrez l'onglet Headers et ajoutez un en-tête.
Authorization: Bearer <<api_key>>Vous ne remplacez la variable à la main nulle part, et la vraie clé n'apparaît jamais dans la requête que vous voyez à l'écran.
Le corps. Ouvrez l'onglet Body, choisissez application/json dans la liste Content Type (la documentation le liste comme le type pour un contenu au format JSON) et collez :
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
Utilisez l'id complet deepseek-. Le nom court d'une liste de prix ne sera pas accepté par l'API. DeepSeek-V4-Flash a un contexte de 380K et jusqu'à 32 768 tokens de sortie par réponse, donc 200 est un plafond volontairement bas pour un test. Vous voulez un autre modèle ? Changez ce seul champ en zai- (contexte de 390K, jusqu'à 8 192 tokens de sortie) et renvoyez.
Liste de contrôle
Avant d'appuyer sur Send
Appuyez sur Send et lisez la réponse#
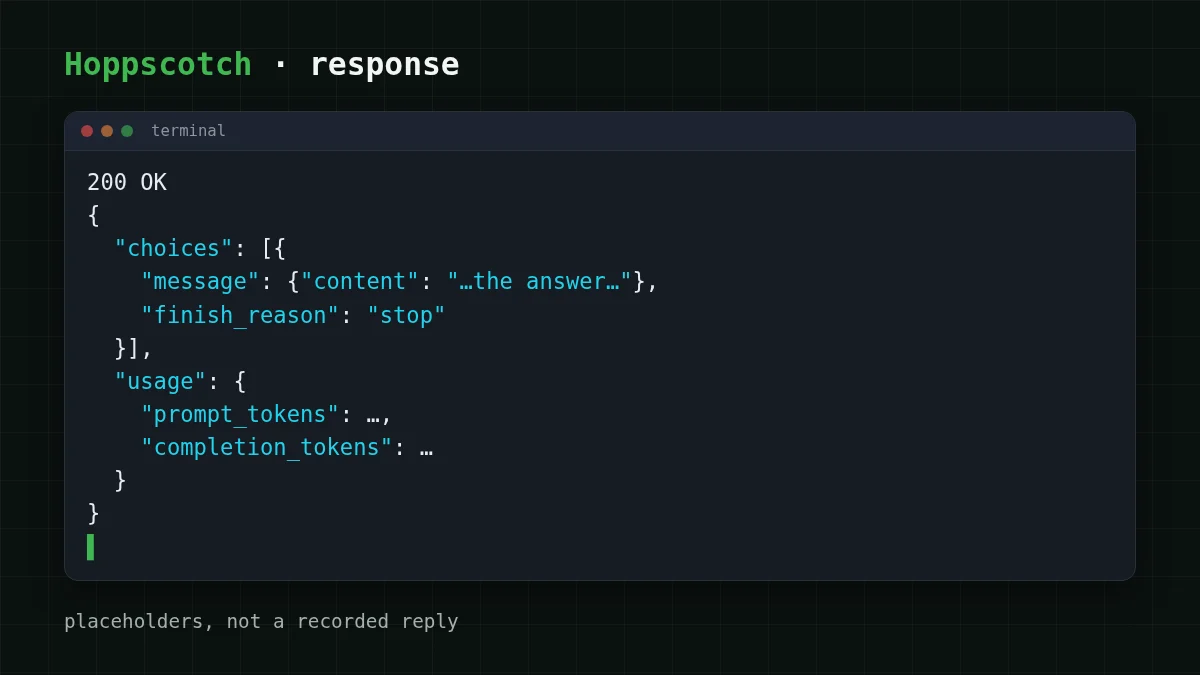
Cliquez sur Send. La section de réponse affiche le code de statut, le corps, les en-têtes, les cookies et le timing. Vous voulez 200 et un corps JSON au format chat completion d'OpenAI. Deux endroits comptent :
choices[0].est la réponse du modèle.message. content usagecontientprompt_tokens(ce que vous avez envoyé) etcompletion_(ce que le modèle a écrit). C'est ce qui vous est facturé, donc c'est là que vous vérifiez qu'une requête a coûté ce que vous attendiez.tokens
Regardez aussi choices[0].. stop signifie que le modèle a terminé de lui-même. length signifie que votre max_tokens a coupé la réponse. Si vous voyez cela sur une question d'une phrase, le plafond est trop bas. Une explication plus longue se trouve dans Réponse IA coupée ? Corriger finish_reason "length".
Enregistrez la requête dans une collection et elle est réutilisable : changez le message, appuyez de nouveau sur Send.
Combien coûte une requête de test#
Prenez une question courte et une réponse courte : disons 30 tokens en entrée et 150 en sortie. Une telle requête coûte $0.000015, et le tableau ci-dessous en compte 100 avec entrée et sortie confondues, à côté d'OpenRouter.
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 100 requêtes | OpenRouter, 100 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 tokens d'entrée et 150 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Au total, entrée et sortie confondues, c'est moins cher qu'OpenRouter pour le même modèle. Vos propres chiffres différeront, alors faites glisser les curseurs sur votre propre cas :
Calculateur de coût
Cent requêtes de test comme celle ci-dessus
Tokens d'entrée par requête: 30 · Tokens de sortie par requête: 150 · Requêtes par jour: 100
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
Les prix sont fixes par modèle, sans tarification aux heures de pointe, et un seul solde couvre tous les modèles. Les tarifs actuels sont sur la page de tarification.
Si ça ne marche pas#
La plupart des échecs de première requête dans un client REST viennent de trois champs. Associez le symptôme à la cause :
Associer les paires
Associez chaque symptôme à sa cause
Touchez un élément à gauche, puis sa paire
- 401 UnauthorizedLa clé est absente ou erronée, ou l'en-tête
Authorizationn'est pas envoyé - 404 Not FoundLe chemin de l'URL ou l'id du modèle est erroné
- finish_reason is "length"Le plafond
max_tokensa coupé la réponse
Pour les deux premiers, un parcours complet se trouve dans Erreur API 401 ou 404 : mauvaise clé, URL de base ou id de modèle. Si vous ne savez pas quel id utiliser, listez les modèles avec GET /v1/models.
Où aller ensuite#
La même requête fonctionne dans d'autres clients : voir la version Postman ou le fichier .http de VS Code. Si vous préférez garder les clés hors des fichiers et des shells, stocker une clé API en sécurité couvre les bases. Les ids de modèles et le point de terminaison compatible OpenAI sont décrits dans la documentation.


