Primeros pasosGuía
Primera solicitud a CheapTokens en Hoppscotch: la clave en un entorno
Envía tu primera chat completion desde el cliente web de Hoppscotch: URL base y clave en un entorno, un cuerpo JSON y dónde leer la respuesta y el uso.
En esta página
Puedes hacer tu primera solicitud a CheapTokens en Hoppscotch sin instalar nada ni escribir código: abre la aplicación web, coloca la URL base y tu clave en un entorno, construye una solicitud POST / y pulsa Send. La respuesta y los recuentos de tokens aparecen en el panel de respuesta.
Lo único que merece la pena hacer con cuidado es la clave. Si la pegas directamente en la solicitud, acaba en cada captura de pantalla y en cada enlace compartido. Una variable de entorno la mantiene en un solo lugar.
Esta guía sigue la documentación oficial de Hoppscotch (consultada el 9 de noviembre de 2026; las páginas no indican versión ni fecha). Del lado de la API está la URL base de CheapTokens https:/, que habla el formato OpenAI Chat Completions. Más sobre ambos en la documentación de CheapTokens.
Coloca la URL base y la clave en un entorno#
Hoppscotch tiene un icono de Environments en la barra lateral. Haz clic en él, crea un entorno nuevo, llámalo cheaptokens y añade dos variables:
Desplaza la tabla hacia la derecha →
| Variable | Tipo | Valor |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | tu clave de CheapTokens |
¿Por qué dos tipos? Según la documentación de Hoppscotch, una variable Regular es visible para todos los que pueden ver el entorno, mientras que una Secret está enmascarada, nunca se sincroniza ni se comparte, y queda fuera de las exportaciones y duplicados. Una clave pertenece al segundo tipo: introdúcela como valor de la variable. Después selecciona el entorno cheaptokens para que la solicitud pueda verlo.
En las solicitudes, una variable se escribe como <<name>>: <<baseURL>> y <<api_key>>. Ese es todo el truco.
Construye la solicitud#
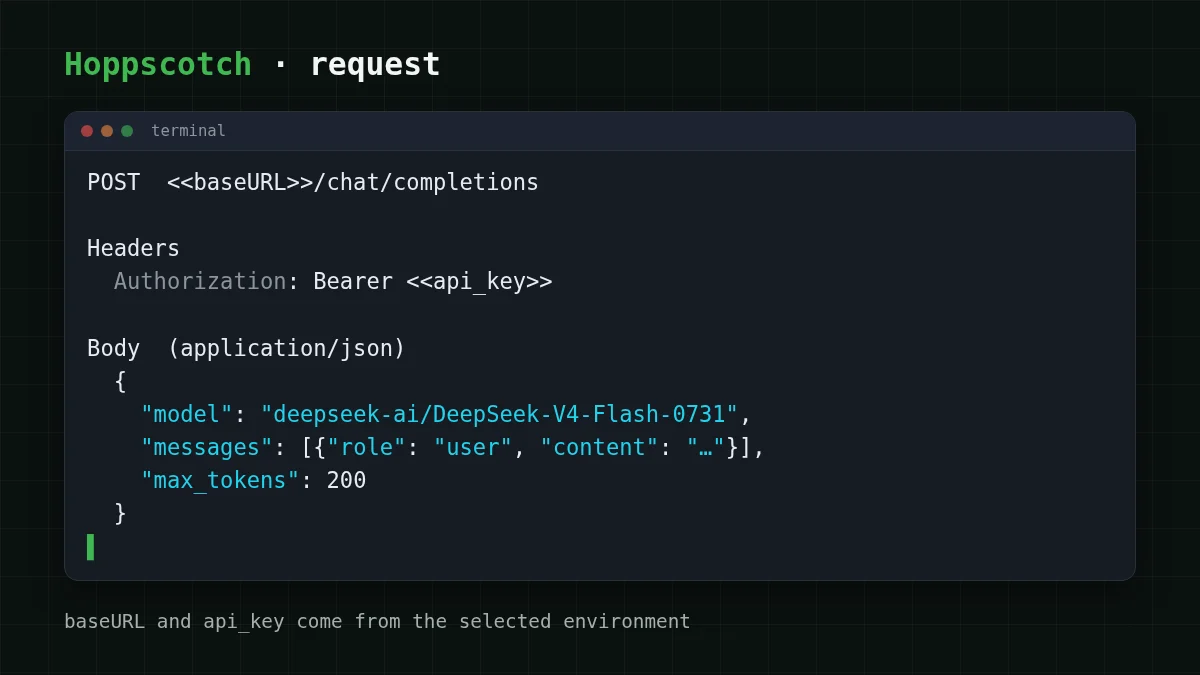
REST es el modo activo cuando abres Hoppscotch. Hay tres cosas que configurar.
Método y URL. Elige POST en el desplegable e introduce:
<<baseURL>>/chat/completionsLa clave. La pestaña Authorization de Hoppscotch tiene un tipo Bearer y añade el token a la solicitud como Bearer <token>. La documentación no dice si <<api_key>> funciona dentro de ese campo de token, así que usa la ruta segura: abre la pestaña Headers y añade una cabecera.
Authorization: Bearer <<api_key>>No reemplazas la variable a mano en ningún sitio, y la clave real nunca aparece en la solicitud que ves en pantalla.
El cuerpo. Abre la pestaña Body, elige application/json en el desplegable Content Type (la documentación lo indica como el tipo para contenido en formato JSON) y pega:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
Usa el id completo deepseek-. El nombre corto de una lista de precios no será aceptado por la API. DeepSeek-V4-Flash tiene un contexto de 380K y hasta 32.768 tokens de salida por respuesta, así que 200 es un límite deliberadamente pequeño para una prueba. ¿Quieres otro modelo? Cambia ese único campo a zai- (contexto de 390K, hasta 8.192 tokens de salida) y envía de nuevo.
Lista de verificación
Antes de pulsar Send
Pulsa Send y lee la respuesta#
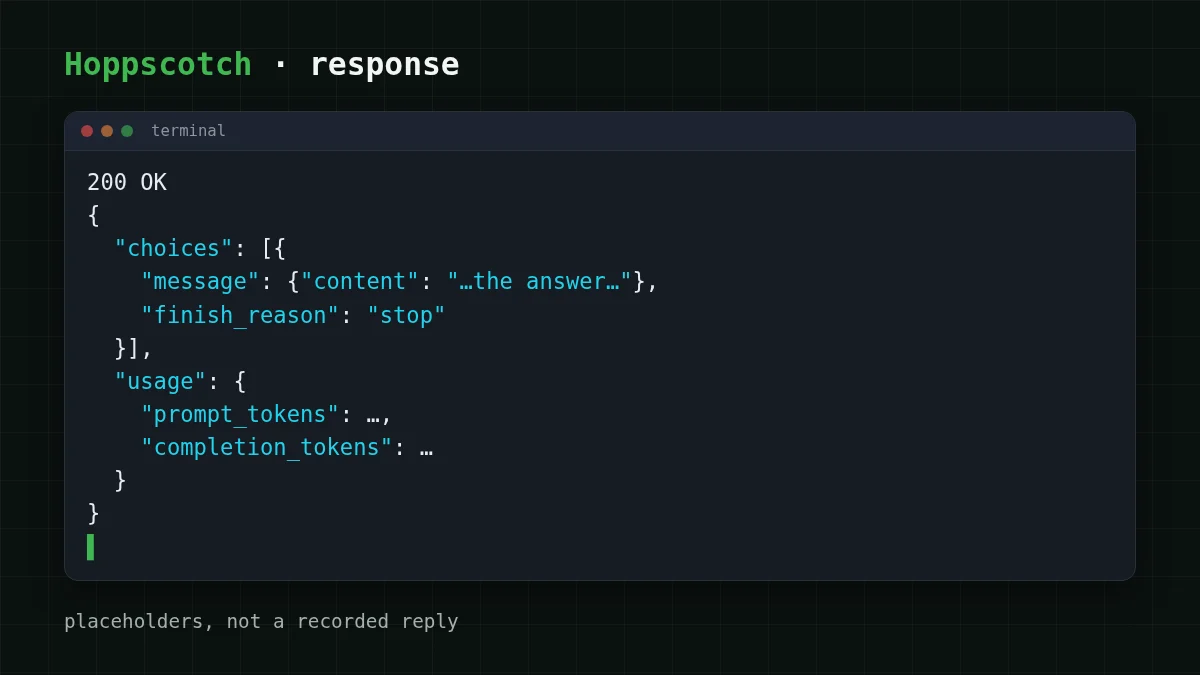
Haz clic en Send. La sección de respuesta muestra el código de estado, el cuerpo, las cabeceras, las cookies y los tiempos. Quieres 200 y un cuerpo JSON con la forma del formato chat completion de OpenAI. Dos lugares importan:
choices[0].es la respuesta del modelo.message. content usagetieneprompt_tokens(lo que enviaste) ycompletion_(lo que escribió el modelo). Eso es lo que se te factura, así que aquí es donde compruebas que una solicitud costó lo que esperabas.tokens
Fíjate también en choices[0].. stop significa que el modelo terminó por sí solo. length significa que tu max_tokens cortó la respuesta. Si ves eso en una pregunta de una sola frase, el límite es demasiado bajo. Hay una explicación más larga en ¿Respuesta de IA cortada? Arregla finish_reason "length".
Guarda la solicitud en una colección y será reutilizable: cambia el mensaje y pulsa Send de nuevo.
Cuánto cuesta una solicitud de prueba#
Toma una pregunta corta y una respuesta corta: digamos 30 tokens de entrada y 150 de salida. Una solicitud así cuesta $0.000015, y la tabla en vivo de abajo cuenta 100 de ellas con entrada y salida juntas, junto a OpenRouter.
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 100 solicitudes | OpenRouter, 100 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 tokens de entrada y 150 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En total, contando entrada y salida juntas, eso es más barato que OpenRouter para el mismo modelo. Tus propias cifras variarán, así que arrastra los controles deslizantes según tu propio caso:
Calculadora de costos
Cien solicitudes de prueba como la de arriba
Tokens de entrada por solicitud: 30 · Tokens de salida por solicitud: 150 · Solicitudes por día: 100
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
Los precios son fijos por modelo, sin tarifas de hora punta, y un solo saldo cubre todos los modelos. Las tarifas actuales están en la página de precios.
Si no funciona#
La mayoría de los fallos en la primera solicitud en un cliente REST provienen de tres campos. Relaciona el síntoma con la causa:
Emparejar los pares
Relaciona cada síntoma con su causa
Toca un elemento de la izquierda, luego su par
- 401 UnauthorizedFalta la clave o es incorrecta, o la cabecera
Authorizationno se está enviando - 404 Not FoundLa ruta de la URL o el id del modelo es incorrecto
- finish_reason es "length"El límite
max_tokenscortó la respuesta
Para los dos primeros hay un recorrido completo en Error 401 o 404 de la API: clave, URL base o id de modelo incorrectos. Si no estás seguro de qué id usar, lista los modelos con GET /v1/models.
A dónde ir después#
La misma solicitud funciona en otros clientes: consulta la versión para Postman o el archivo .http de VS Code. Si prefieres mantener las claves fuera de archivos y shells por completo, almacenar una clave de API de forma segura cubre lo básico. Los ids de modelo y el endpoint compatible con OpenAI se describen en la documentación.


