Pierwsze krokiPrzewodnik
Pierwsze żądanie do CheapTokens w Hoppscotch: klucz w środowisku
Wyślij pierwsze chat completion z klienta webowego Hoppscotch: bazowy URL i klucz w środowisku, treść JSON oraz gdzie odczytać odpowiedź i zużycie.
Na tej stronie
Możesz wysłać pierwsze żądanie do CheapTokens w Hoppscotch bez instalowania czegokolwiek i bez pisania kodu: otwórz aplikację webową, umieść bazowy URL i swój klucz w środowisku, zbuduj jedno żądanie POST /, naciśnij Send. Odpowiedź i liczniki tokenów pojawią się w panelu odpowiedzi.
Jedyne, co warto zrobić starannie, to klucz. Jeśli wkleisz go bezpośrednio do żądania, trafi na każdy zrzut ekranu i każdy udostępniony link. Zmienna środowiskowa trzyma go w jednym miejscu.
Ten przewodnik opiera się na oficjalnej dokumentacji Hoppscotch (sprawdzonej 9 listopada 2026; strony nie zawierają wersji ani daty). Po stronie API jest bazowy URL CheapTokens https:/, który mówi w formacie OpenAI Chat Completions. Więcej o obu w dokumentacji CheapTokens.
Umieść bazowy URL i klucz w środowisku#
Hoppscotch ma ikonę Environments na pasku bocznym. Kliknij ją, utwórz nowe środowisko, nazwij je cheaptokens i dodaj dwie zmienne:
Przewiń tabelę w prawo →
| Zmienna | Typ | Wartość |
|---|---|---|
baseURL |
Regular | https:/ |
api_key |
Secret | twój klucz CheapTokens |
Dlaczego dwa typy? Według dokumentacji Hoppscotch zmienna Regular jest widoczna dla wszystkich, którzy widzą środowisko, natomiast zmienna Secret jest maskowana, nigdy nie jest synchronizowana ani udostępniana i jest pomijana w eksportach i duplikatach. Klucz należy do drugiego rodzaju: wpisz go jako wartość zmiennej. Następnie wybierz środowisko cheaptokens, aby żądanie mogło je zobaczyć.
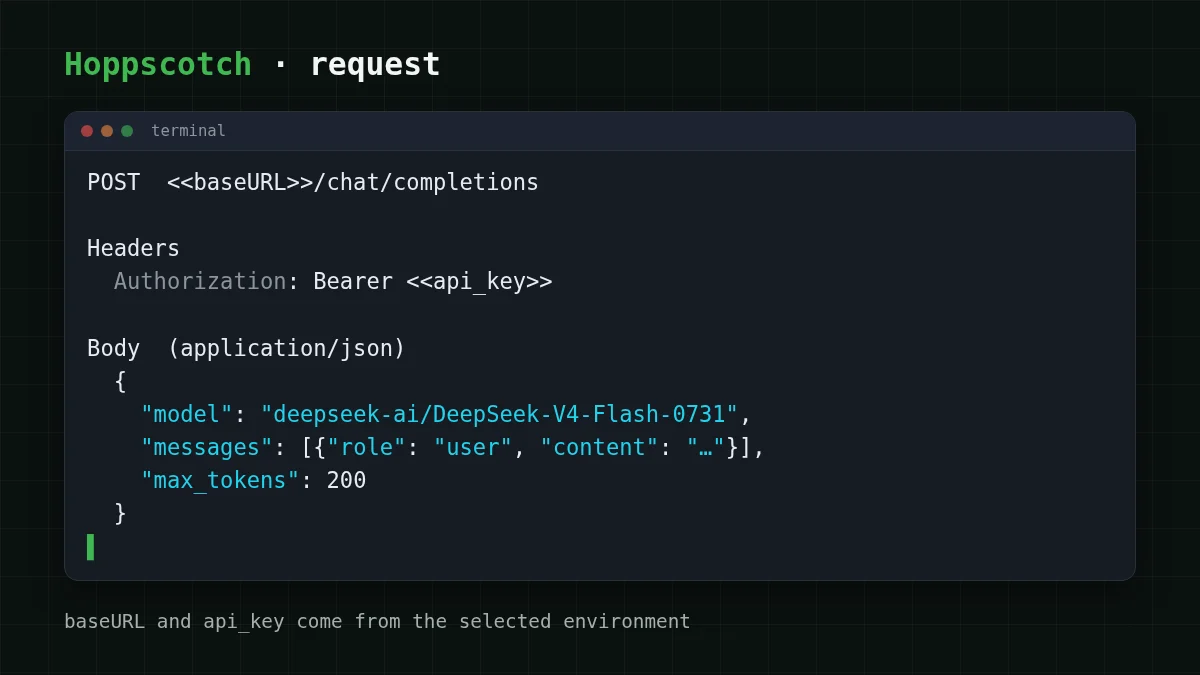
W żądaniach zmienną zapisuje się jako <<name>>: <<baseURL>> i <<api_key>>. To cała sztuczka.
Zbuduj żądanie#
REST jest aktywnym trybem po otwarciu Hoppscotch. Trzy rzeczy do ustawienia.
Metoda i URL. Wybierz POST z listy rozwijanej i wpisz:
<<baseURL>>/chat/completionsKlucz. Zakładka Authorization w Hoppscotch ma typ Bearer i dodaje token do żądania jako Bearer <token>. Dokumentacja nie mówi, czy <<api_key>> działa w tym polu tokena, więc użyj pewnej drogi: otwórz zakładkę Headers i dodaj jeden nagłówek.
Authorization: Bearer <<api_key>>Nigdzie nie zastępujesz zmiennej ręcznie, a prawdziwy klucz nigdy nie pojawia się w żądaniu widocznym na ekranie.
Treść. Otwórz zakładkę Body, wybierz application/json z listy rozwijanej Content Type (dokumentacja wymienia go jako typ dla treści w formacie JSON) i wklej:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    {"role": "user", "content": "Explain what a token is in one sentence."}
  ],
  "max_tokens": 200
}
Użyj pełnego identyfikatora deepseek-. Krótka nazwa z cennika nie zostanie zaakceptowana przez API. DeepSeek-V4-Flash ma kontekst 380K i do 32 768 tokenów wyjściowych na odpowiedź, więc 200 to celowo mały limit na test. Chcesz inny model? Zmień to jedno pole na zai- (kontekst 390K, do 8192 tokenów wyjściowych) i wyślij ponownie.
Lista kontrolna
Zanim naciśniesz Send
Naciśnij Send i odczytaj odpowiedź#
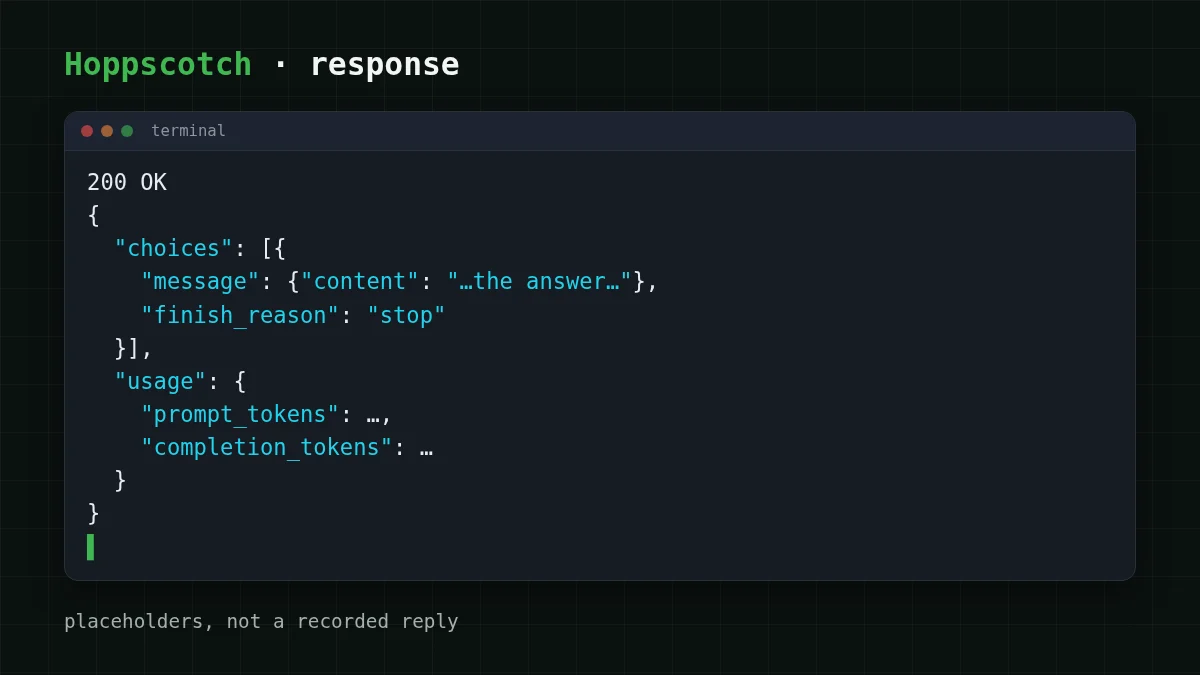
Kliknij Send. Sekcja odpowiedzi pokazuje kod statusu, treść, nagłówki, ciasteczka i czas. Chcesz zobaczyć 200 i treść JSON w kształcie formatu OpenAI chat completion. Dwa miejsca mają znaczenie:
choices[0].to odpowiedź modelu.message. content usagezawieraprompt_tokens(to, co wysłałeś) icompletion_(to, co napisał model). Za to płacisz, więc tutaj sprawdzasz, czy żądanie kosztowało tyle, ile oczekiwałeś.tokens
Spójrz też na choices[0].. stop oznacza, że model zakończył samodzielnie. length oznacza, że twoje max_tokens ucięło odpowiedź. Jeśli widzisz to przy pytaniu o jedno zdanie, limit jest za niski. Dłuższe wyjaśnienie znajdziesz w Odpowiedź AI ucięta? Napraw finish_reason "length".
Zapisz żądanie w kolekcji, a będzie wielokrotnego użytku: zmień wiadomość, naciśnij Send ponownie.
Ile kosztuje żądanie testowe#
Weź krótkie pytanie i krótką odpowiedź: powiedzmy 30 tokenów na wejściu i 150 na wyjściu. Jedno takie żądanie kosztuje $0.000015, a tabela na żywo poniżej liczy 100 takich żądań z wejściem i wyjściem razem, obok OpenRouter.
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 100 żądań | OpenRouter, 100 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000066 | $0.00066 | $0.0013 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000015 | $0.0015 | $0.0023 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000024 | $0.0024 | $0.0288 |
30 tokenów wejściowych i 150 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W sumie, licząc wejście i wyjście razem, to taniej niż OpenRouter dla tego samego modelu. Twoje własne liczby będą inne, więc przeciągnij suwaki na swoim przypadku:
Kalkulator kosztów
Sto żądań testowych jak powyższe
Tokeny wejściowe na żądanie: 30 · Tokeny wyjściowe na żądanie: 150 · Żądania dziennie: 100
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.00066 | $0.0198 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0015 | $0.0464 |
| MiniMax-M2.7$0.05$0.15 | $0.0024 | $0.072 |
Ceny są stałe dla modelu, bez cen w godzinach szczytu, a jedno saldo obejmuje wszystkie modele. Aktualne stawki są na stronie cennika.
Jeśli nie działa#
Większość niepowodzeń pierwszego żądania w kliencie REST wynika z trzech pól. Dopasuj objaw do przyczyny:
Dopasuj pary
Dopasuj każdy objaw do jego przyczyny
Dotknij element po lewej, a następnie jego parę
- 401 UnauthorizedBrakuje klucza lub jest błędny, albo nagłówek
Authorizationnie jest wysyłany - 404 Not FoundŚcieżka URL lub identyfikator modelu jest błędny
- finish_reason to "length"Limit
max_tokensuciął odpowiedź
Dla pierwszych dwóch jest pełny opis w Błąd API 401 lub 404: zły klucz, bazowy URL lub identyfikator modelu. Jeśli nie wiesz, którego identyfikatora użyć, wylistuj modele przez GET /v1/models.
Dokąd dalej#
To samo żądanie działa w innych klientach: zobacz wersję dla Postmana lub plik .http w VS Code. Jeśli wolisz całkowicie trzymać klucze poza plikami i powłokami, bezpieczne przechowywanie klucza API omawia podstawy. Identyfikatory modeli i endpoint zgodny z OpenAI są opisane w dokumentacji.


