API i SDKPrzewodnik
Pierwsze żądanie w Rust z async-openai: bazowy URL, klucz, usage
Mały program w Rust z tokio i async-openai, który wysyła jedno uzupełnienie czatu do CheapTokens i wypisuje odpowiedź oraz liczby tokenów.
Na tej stronie
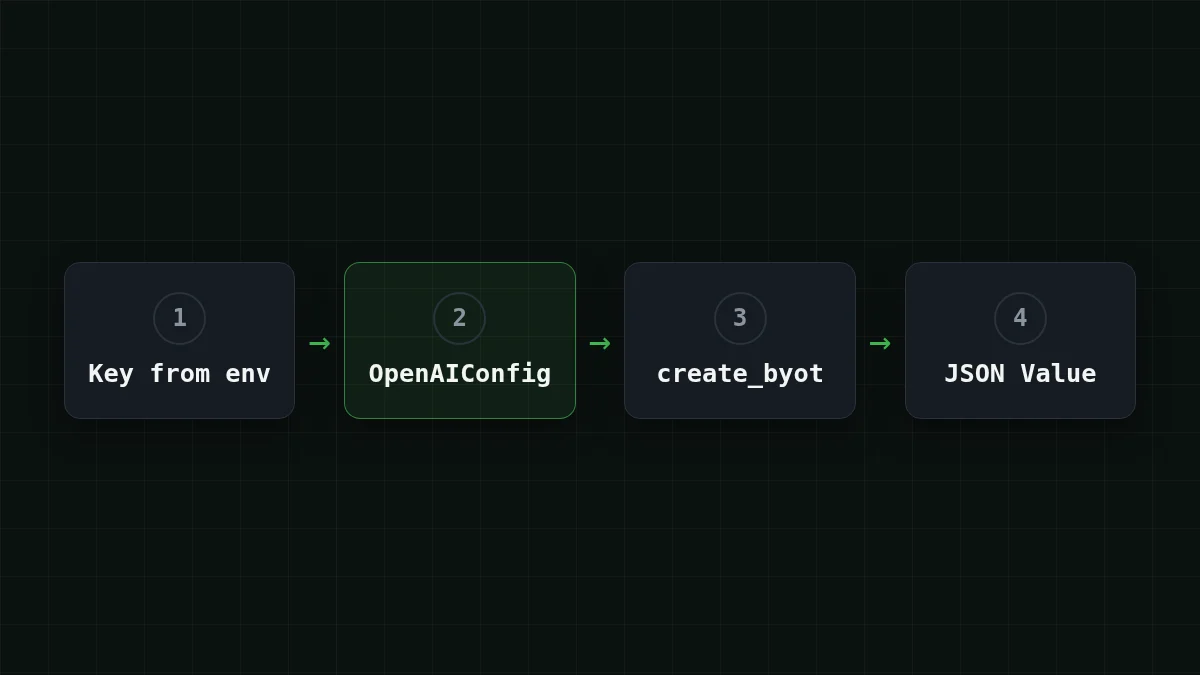
Aby wywołać CheapTokens z Rusta za pomocą async-openai, zbuduj OpenAIConfig z bazowym adresem URL https:/ i swoim kluczem, a następnie wyślij żądanie za pomocą create_byot i treści JSON. Tekst odpowiedzi i liczby tokenów pochodzą z JSON-a, który wraca. To około 25 linii kodu, a ten sam program działa dla dowolnego modelu na stronie modeli CheapTokens po zmianie jednego ciągu znaków.
Strona docs.rs tego crate'a (sprawdzona 8 listopada 2026) wymienia wersję 0.43.0 na licencji MIT i tej wersji dotyczy ten przewodnik.
Dlaczego create_byot zamiast typowanych żądań#
async-openai normalnie daje ci typowany builder żądań: wypełniasz strukturę, dostajesz strukturę z powrotem. To wygodne, dopóki bramka nie zwróci pola, którego struktury nie znają. Funkcja byot ("bring your own types") dodaje metody *_byot, które przyjmują dowolną treść JSON i zwracają dowolny typ, do którego możesz deserializować, w tym zwykły serde_.
Dla pierwszego żądania to jest dokładnie to, czego chcesz. Piszesz ten sam JSON, który wstawiłbyś do wywołania curl, i czytasz usage prosto z odpowiedzi, bez szukania typu.
Skonfiguruj projekt#
Krok po kroku
Utwórz projekt i ustaw klucz
Dodaj crate'y
W nowym projekcie (cargo new cheaptokens-) dodaj trzy zależności. async-openai potrzebuje tu dwóch funkcji: byot dla metod create_byot i chat-completion dla sekcji czatu.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Umieść klucz w zmiennej środowiskowej
Utwórz klucz na swoim koncie CheapTokens i trzymaj go poza kodem źródłowym. Jeśli chcesz dłuższą wersję, zobacz jak bezpiecznie przechowywać klucz API.
export CHEAPTOKENS_API_KEY="paste-your-key-here"W Windows PowerShell ta sama linia to $env:CHEAPTOKENS_.
Uruchom program
Wklej kod z następnej sekcji do src/main.rs i uruchom go.
cargo runProgram#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Trzy linie niosą cały pomysł. with_api_base to miejsce, w które wchodzi CheapTokens: bazowy adres URL kończy się na /v1, a async-openai sam dodaje ścieżkę endpointu. with_api_key przyjmuje wartość odczytaną ze środowiska. A model to pełny identyfikator deepseek- — krótkie nazwy z tabel cen nie są akceptowane przez API.
Indeksowanie Value z brakującym kluczem daje null zamiast paniki, więc literówka w nazwie pola pojawia się jako null w wyniku, a nie jako awaria. To przydatne, gdy poznajesz odpowiedź.
Co wraca#
Bramka mówi w formacie OpenAI Chat Completions, więc odpowiedź ma zwykły kształt (przycięty tutaj, znaki ... oznaczają pola, które pomijamy):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
Liczby w usage to rzeczywiste zliczenia dla twojego żądania, więc zastępują zera po uruchomieniu. prompt_tokens to to, co wysłałeś, completion_ to to, co napisał model. Są rozliczane według różnych cen i właśnie dlatego je wypisujemy. Jeśli ta różnica jest dla ciebie nowa, tokeny wejściowe vs wyjściowe wyjaśniają ją w pięć minut.
Spróbuj samSpróbuj: ustaw "max_tokens" na 5 i uruchom ponownie. Co mówi finish_reason?Pokaż odpowiedź
W formacie OpenAI Chat Completions mówi length. Model osiągnął twój limit i zdanie jest ucięte w połowie. Przy normalnej odpowiedzi mówi stop. Jeśli widzisz length w prawdziwym zadaniu, zwiększ max_tokens — ten artykuł omawia rozwiązanie.
Ile kosztuje jedno żądanie#
Załóżmy, że uruchamiasz to wywołanie w pętli, małe pytanie na wejściu i krótka odpowiedź na wyjściu: 300 tokenów wejściowych i 200 wyjściowych za każdym razem. Na DeepSeek-V4-Flash to $0.000025 za żądanie, z aktualnej ceny $0.015 za 1M tokenów wejściowych i $0.10 za 1M tokenów wyjściowych. Liczone razem, wejście i wyjście, to taniej niż OpenRouter, a model utrzymuje kontekst 380K i odpowiada do 32 768 tokenów.
Poniższa tabela pokazuje to samo żądanie na każdym modelu, razy 1 000.
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 tokenów wejściowych i 200 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Ceny są na stronie cen.
Zmiana modelu#
Kod się nie zmienia, gdy zmienia się model; zmienia się tylko ciąg znaków w "model". Na przykład zai- ma kontekst 390K i odpowiada do 8 192 tokenów. Aby w ogóle nie edytować kodu, odczytaj identyfikator z drugiej zmiennej za pomocą std::env::var("CHEAPTOKENS_. Jeśli nie jesteś pewien, jakie identyfikatory widzi twój klucz, wylistuj modele za pomocą GET /v1/models.
Jeśli nie działa#
environment variable not foundna samym początku: klucz nie jest wyeksportowany w tym terminalu. Wyeksportuj go ponownie w tym samym oknie, w którym uruchamiaszcargo run.- Błąd 401 z API: klucz jest błędny lub ma wokół siebie zbędną spację albo cudzysłów.
- Błąd 404: sprawdź, czy bazowy adres URL kończy się na
/v1i czy identyfikator modelu jest pełny, z prefiksemdeepseek-ai/. API 401 lub 404: klucz, bazowy URL, identyfikator modelu przeprowadza przez to krok po kroku. - Kompilator nie znajduje
create_byot: funkcjabyotnie jest włączona. Uruchom ponownie linięcargo addz konfiguracji.
W przypadku problemu z połączeniem, który nie jest żadnym z powyższych, zobacz typowe błędy połączenia.
To samo pierwsze żądanie istnieje dla innych języków: Go i Ruby. Więcej o samym API znajdziesz w dokumentacji CheapTokens.


