API i SDKPrzewodnik
Pierwsze żądanie w Go z openai-go: bazowy adres URL, klucz, usage
Kompletny program w Go, który wywołuje model CheapTokens przez openai-go i wypisuje odpowiedź, finish_reason i zużycie tokenów, z ponowieniami i limitem czasu.
Na tej stronie
Masz już kod w Go, który rozmawia z API w stylu OpenAI, albo zaraz go napiszesz. Aby wysłać go do CheapTokens, zmieniasz dwie opcje klienta i jeden ciąg znaków — identyfikator modelu. SDK pozostaje ten sam: oficjalny pakiet openai-go, wersja v3.
Poniżej znajduje się cały program, a następnie opis każdej linii, sposób odczytu odpowiedzi i liczników tokenów oraz to, jak zapobiec zawieszeniu usługi przez zablokowane żądanie. Wersje sprawdzone względem README openai-go z 3 listopada 2026: najnowszy tag na tej stronie to v3.91.1, wymaga Go 1.26 lub nowszego.
Co musisz mieć przed rozpoczęciem#
- Go 1.26 lub nowszy. W Go 1.25 przypnij
v3.74.0; w Go 1.22–1.24 przypnijv3.44.0(README mówi, że starsza linia nie ma gwarantowanych poprawek). - Klucz API CheapTokens. Trzymaj go w zmiennej środowiskowej, a nie w pliku źródłowym.
- Adres API:
https:/. Mówi w formacie OpenAI Chat Completions, więc openai-go działa bez nakładki. Dokumentacja zawiera ten sam adres i stronę z kluczem./ api. cheaptokens. dev/ v1 - Identyfikator modelu. Używamy
deepseek-: kontekst 380K i do 32 768 tokenów w jednej odpowiedzi. Używaj pełnego identyfikatora; krótka nazwa z tabel cen nie jest akceptowana przez API.ai/ DeepSeek- V4- Flash- 0731
Krok po kroku
Skonfiguruj projekt
Zainstaluj SDK
W pustym folderze:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Ścieżka importu to github., nazwa pakietu to openai.
Umieść klucz w środowisku
export CHEAPTOKENS_API_KEY="paste-your-key-here"W Windows PowerShell: $env:CHEAPTOKENS_. Symbol zastępczy nie jest prawdziwym kluczem.
Utwórz main.go i uruchom go
Wklej program z następnej sekcji do main.go, a następnie uruchom go run ..
Cały program#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
Najważniejsze elementy:
option.to jedyna linia, która przenosi SDK z OpenAI do CheapTokens. Użyj adresu dokładnie tak, jak w dokumentacji.WithBaseURL(. . . ) option.przekazuje klucz jawnie. Bez tego klient odczytujeWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, co jest przydatne przy przenoszeniu istniejącego kodu: ustaw tę zmienną na klucz CheapTokens, a kod nie wymaga zmiany klucza. To samo dotyczyOPENAI_BASE_URL, ale jawneWithBaseURLma pierwszeństwo, więc nie ma niespodzianki, jeśli istnieją oba.Modelto zwykły ciąg znaków w SDK (ChatModeljest aliasemstring), więc działa dowolny identyfikator modelu, nie tylko stałe pokazane w README.openai.to jedna tura użytkownika. Przykład w README używaUserMessage(. . . ) DeveloperMessagei stałej GPT; tutaj wystarczy wiadomość użytkownika i identyfikator w postaci ciągu znaków.
Odczytaj odpowiedź, finish_reason i usage#
Wszystkie trzy pochodzą z pól, które SDK już analizuje za Ciebie:
resp.to tekst (Choices[0]. Message. Content string).resp.to równieżChoices[0]. FinishReason string.stopoznacza, że model zakończył samodzielnie;lengthoznacza, że odpowiedź osiągnęła limit tokenów i została ucięta. Jeśli zobaczyszlength, przeczytaj dlaczego odpowiedź urywa się w połowie zdania.resp.UsagezawieraPromptTokens(to, co wysłałeś),CompletionTokens(to, co napisał model) iTotalTokens, wszystkieint64.
Dane wyjściowe będą wyglądać tak: odpowiedź, następnie finish_reason: z wartością, a potem trzy liczby tokenów. Liczby różnią się przy każdym uruchomieniu, więc je loguj. To za nie płacisz, a tokeny wyjściowe są droższą stroną.
Spróbuj samWypróbuj: co się zmieni, jeśli zamienisz model?Pokaż odpowiedź
Zmień ciąg Model na zai- i uruchom ponownie. Nic innego w programie się nie zmienia. Tekst odpowiedzi i trzy liczby usage będą inne, co jest najszybszym sposobem porównania dwóch modeli na własnym prompcie. GLM-5.3-Flash ma kontekst 390K i do 8192 tokenów w jednej odpowiedzi.
Ponowienia i limity czasu: trzy różne ograniczenia#
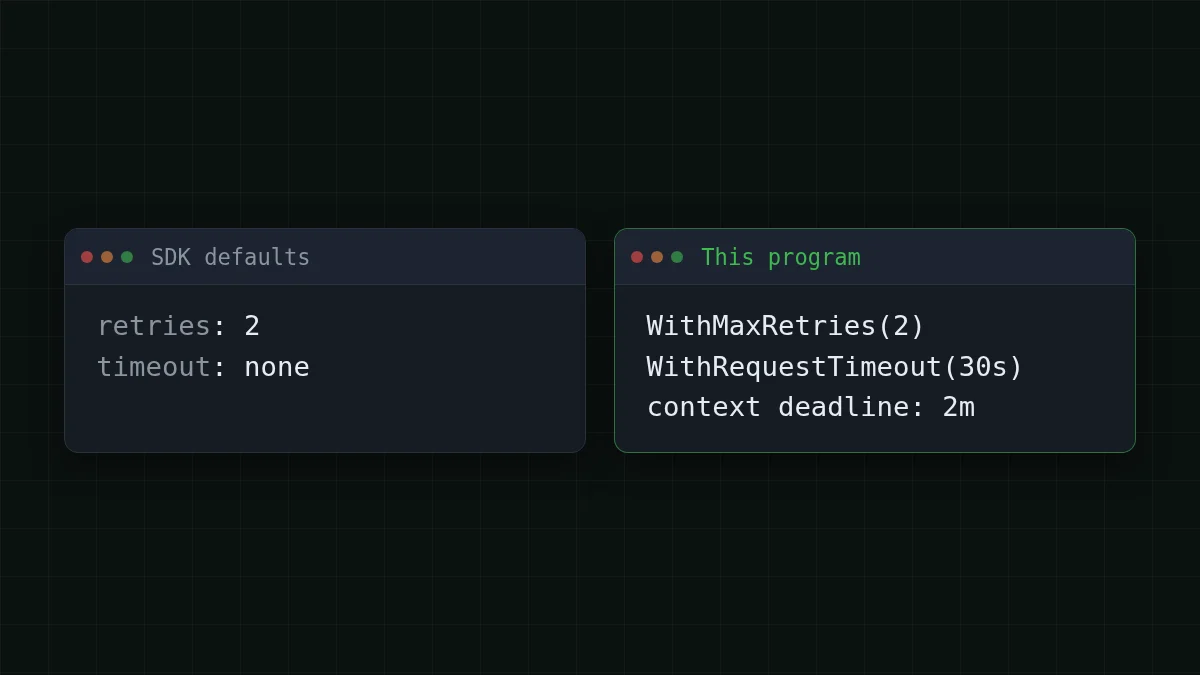
To tutaj usługi w Go zwykle ucierpią: domyślnie SDK nie ma żadnego limitu czasu, więc zawieszone połączenie może czekać wiecznie. Trzy ustawienia to naprawiają i działają na różnych poziomach:
option.: SDK ponawia błędy połączenia, 408, 409, 429 i 5xx z krótkim wykładniczym oczekiwaniem. Dwa ponowienia są już domyślne;WithMaxRetries(2) 0wyłącza ponowienia. Możesz ustawić to na kliencie lub na pojedynczym wywołaniu.option.: limit dla jednej próby.WithRequestTimeout(30*time. Second) - Termin
context: limit dla całego wywołania, łącznie z ponowieniami i oczekiwaniem.
Więc przy 2 ponowieniach mogą być do 3 prób: 3 × 30 = 90 sekund oczekiwania w najgorszym przypadku, plus krótkie przerwy między próbami. Dwuminutowy kontekst to pokrywa. Jeśli chcesz twardej reguły odpowiedzi w ciągu 20 sekund dla handlera WWW, skróć kontekst, a nie tylko limit czasu na próbę.
Aby uzyskać szersze tło dotyczące wyboru tych liczb, wersja Python tej samej porady znajduje się w OpenAI Python SDK timeout and retries. Logika przenosi się na Go.
Ile kosztuje tysiąc takich wywołań#
Powiedzmy, że prowadzisz małą usługę, która wykonuje 1000 żądań dziennie, każde z około 800 tokenami wejściowymi i 300 tokenami wyjściowymi. W deepseek- ten dzień kosztuje $0.042 (1000 × 800 tokenów wejściowych, 1000 × 300 tokenów wyjściowych). Tabela pokazuje to samo obciążenie dla naszych modeli; liczone łącznie, z wejściem i wyjściem razem, jest tańsze niż OpenRouter.
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Wstaw własne liczby. Pierwsze uruchomienie wypisuje rzeczywiste PromptTokens i CompletionTokens, więc nie musisz zgadywać średniej:
Kalkulator kosztów
Jeden dzień małej usługi w Go
Tokeny wejściowe na żądanie: 800 · Tokeny wyjściowe na żądanie: 300 · Żądania dziennie: 1000
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Ceny na stronie cen i stronie modeli są aktualne i używają jednej stałej ceny za model, bez godzin szczytu.
Jeśli nie działa#
- Błąd wspomina o 401: klucz jest pusty lub nieprawidłowy.
os.Getenvzwraca pusty ciąg dla nieustawionej zmiennej, więc sprawdźecho $CHEAPTOKENS_w tym samym terminalu, w którym uruchamiaszAPI_ KEY go run .. - Błąd wspomina o 404 lub nieznanym modelu: identyfikator. Skopiuj go w całości, z prefiksem
deepseek-ai/. Możesz wyświetlić identyfikatory w wywołaniu listy modeli. go: module requires Go 1.: Twój zestaw narzędzi jest starszy. Przypnij starszy tag SDK, jak pokazano na górze.26 - Wywołanie zawiesza się, a potem kończy niepowodzeniem: to limit czasu robi swoje. Najpierw sprawdź ścieżkę sieciową, a następnie zwiększ
WithRequestTimeout, jeśli model naprawdę potrzebuje więcej czasu na długą odpowiedź.
Jeśli koncepcja bazowego adresu URL jest dla Ciebie nowa, czym jest base_url i jak przełączyć wyjaśnia to bez kodu.


