API और SDKगाइड
openai-go के साथ Go में पहली रिक्वेस्ट: base URL, कुंजी, usage
एक पूरा Go प्रोग्राम जो openai-go के माध्यम से CheapTokens मॉडल को कॉल करता है और उत्तर, finish_reason और टोकन usage प्रिंट करता है, रीट्राई और टाइमआउट के साथ।
इस पृष्ठ पर
आपके पास पहले से Go कोड है जो OpenAI-शैली API से बात करता है, या आप इसे लिखने वाले हैं। इसे CheapTokens पर भेजने के लिए आप क्लाइंट पर दो विकल्प और एक स्ट्रिंग, मॉडल आईडी, बदलते हैं। SDK वही रहता है: आधिकारिक openai-go पैकेज, v3।
नीचे पूरा प्रोग्राम है, फिर हर पंक्ति क्या करती है, उत्तर और टोकन गणनाएँ कैसे पढ़ें, और कैसे एक अटकी हुई रिक्वेस्ट को आपकी सेवा को हैंग करने से रोकें। संस्करण 3 नवंबर 2026 को openai-go README के विरुद्ध जाँचे गए: उस पृष्ठ पर नवीनतम टैग v3.91.1 है, और इसके लिए Go 1.26 या नया चाहिए।
शुरू करने से पहले आपको क्या चाहिए#
- Go 1.26 या नया। Go 1.25 पर
v3.74.0पिन करें; Go 1.22–1.24 परv3.44.0पिन करें (README कहता है कि पुरानी लाइन को कोई गारंटीड फ़िक्स नहीं मिलते)। - एक CheapTokens API कुंजी। इसे एनवायरनमेंट वेरिएबल में रखें, सोर्स फ़ाइल में नहीं।
- API पता:
https:/। यह OpenAI Chat Completions प्रारूप बोलता है, इसलिए openai-go बिना किसी रैपर के काम करता है। डॉक्स में वही पता और कुंजी पृष्ठ है।/ api. cheaptokens. dev/ v1 - एक मॉडल आईडी। हम
deepseek-का उपयोग करते हैं: 380K कॉन्टेक्स्ट और एक उत्तर में अधिकतम 32,768 टोकन। पूरी आईडी का उपयोग करें; मूल्य तालिकाओं का छोटा नाम API द्वारा स्वीकार नहीं किया जाता।ai/ DeepSeek- V4- Flash- 0731
चरण दर चरण
प्रोजेक्ट सेट करें
SDK इंस्टॉल करें
एक खाली फ़ोल्डर में:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
इम्पोर्ट पथ github. है, पैकेज का नाम openai है।
कुंजी को एनवायरनमेंट में रखें
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell पर: $env:CHEAPTOKENS_। प्लेसहोल्डर असली कुंजी नहीं है।
main.go बनाएँ और चलाएँ
अगले अनुभाग का प्रोग्राम main.go में पेस्ट करें, फिर go run . चलाएँ।
पूरा प्रोग्राम#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}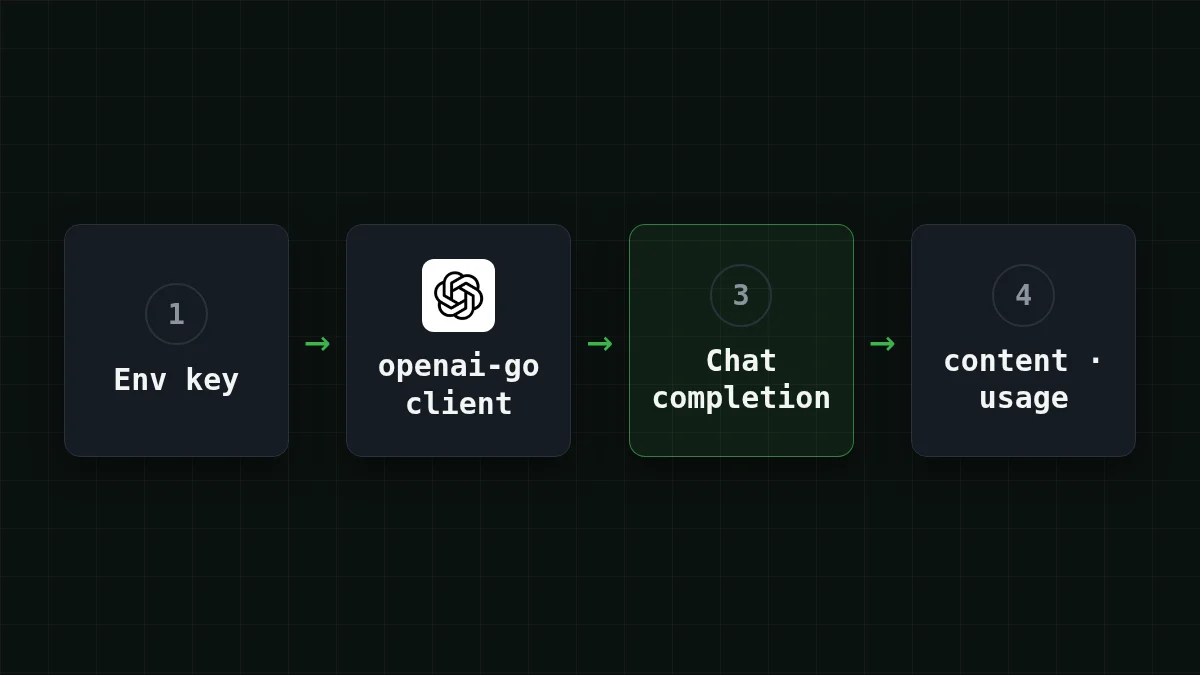
महत्वपूर्ण हिस्से:
option.एकमात्र पंक्ति है जो SDK को OpenAI से CheapTokens पर ले जाती है। पता ठीक वैसे ही उपयोग करें जैसे डॉक्स में है।WithBaseURL(. . . ) option.कुंजी को स्पष्ट रूप से पास करता है। इसके बिना क्लाइंटWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEYपढ़ता है, जो मौजूदा कोड पोर्ट करते समय उपयोगी है: उस वेरिएबल को CheapTokens कुंजी पर सेट करें और कोड में कुंजी बदलने की ज़रूरत नहीं। यहीOPENAI_BASE_URLपर भी लागू होता है, लेकिन एक स्पष्टWithBaseURLइसे ओवरराइड करता है, इसलिए दोनों मौजूद होने पर कोई आश्चर्य नहीं।ModelSDK में एक सादा स्ट्रिंग है (ChatModel,stringका उपनाम है), इसलिए कोई भी मॉडल आईडी काम करती है, केवल वे कॉन्स्टेंट नहीं जो README दिखाता है।openai.एक उपयोगकर्ता टर्न है। README उदाहरणUserMessage(. . . ) DeveloperMessageऔर एक GPT कॉन्स्टेंट का उपयोग करता है; यहाँ एक उपयोगकर्ता संदेश और एक स्ट्रिंग आईडी पर्याप्त है।
उत्तर, finish_reason और usage पढ़ें#
तीनों उन फ़ील्ड्स से आते हैं जिन्हें SDK पहले से आपके लिए पार्स करता है:
resp.टेक्स्ट है (एकChoices[0]. Message. Content string)।resp.भी एकChoices[0]. FinishReason stringहै।stopका अर्थ है कि मॉडल ने अपने आप समाप्त किया;lengthका अर्थ है कि उत्तर टोकन सीमा तक पहुँच गया और काट दिया गया। यदि आपlengthदेखते हैं, तो उत्तर वाक्य के बीच में क्यों रुकता है पढ़ें।resp.UsageमेंPromptTokens(जो आपने भेजा),CompletionTokens(जो मॉडल ने लिखा) औरTotalTokensहैं, सभीint64।
आउटपुट ऐसा दिखेगा: उत्तर, फिर एक मान के साथ finish_reason:, फिर तीन टोकन गणनाएँ। संख्याएँ हर रन पर भिन्न होती हैं, इसलिए उन्हें लॉग करें। वे ही हैं जिनके लिए आप भुगतान करते हैं, और आउटपुट टोकन अधिक महँगा पक्ष हैं।
स्वयं आज़माएँइसे आज़माएँ: मॉडल बदलने पर क्या बदलता है?उत्तर दिखाएँ
Model स्ट्रिंग को zai- में बदलें और फिर से चलाएँ। प्रोग्राम में और कुछ नहीं बदलता। उत्तर का टेक्स्ट और तीन usage संख्याएँ भिन्न होंगी, जो आपके अपने प्रॉम्प्ट पर दो मॉडलों की तुलना करने का सबसे तेज़ तरीका है। GLM-5.3-Flash में 390K कॉन्टेक्स्ट और एक उत्तर में अधिकतम 8,192 टोकन हैं।
रीट्राई और टाइमआउट: तीन अलग सीमाएँ#
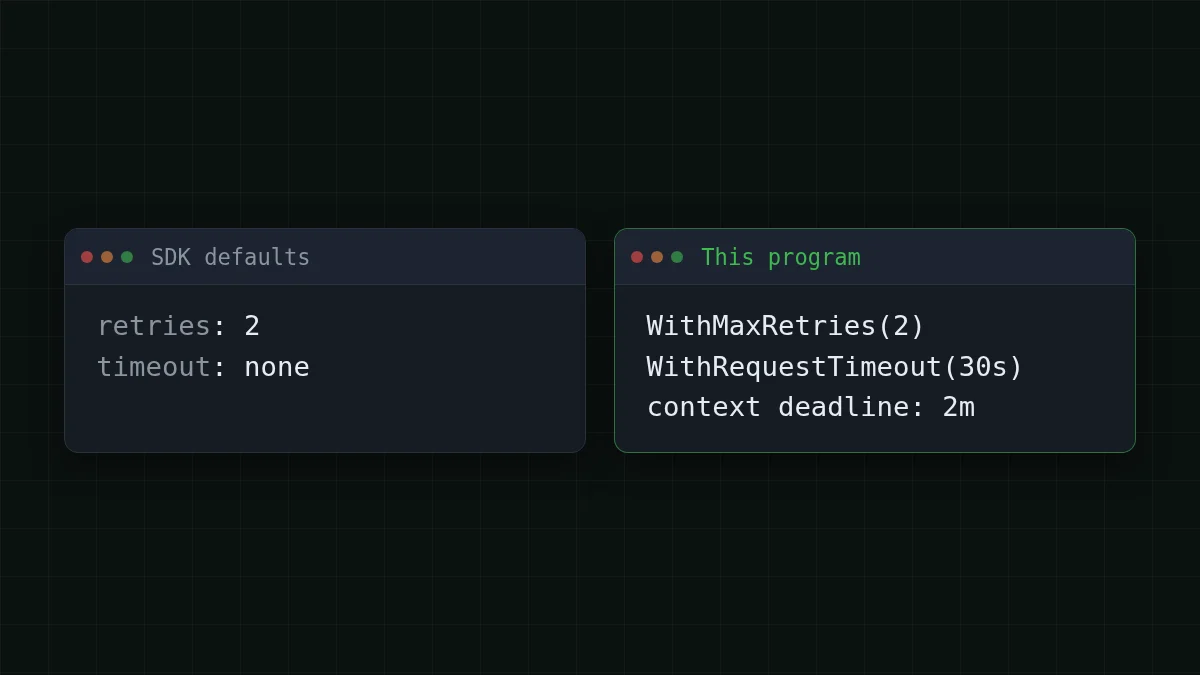
यहीं Go सेवाओं को आमतौर पर चोट पहुँचती है: डिफ़ॉल्ट रूप से SDK में कोई टाइमआउट नहीं होता, इसलिए एक अटका हुआ कनेक्शन हमेशा प्रतीक्षा कर सकता है। तीन सेटिंग्स इसे ठीक करती हैं, और वे अलग-अलग स्तरों पर काम करती हैं:
option.: SDK कनेक्शन त्रुटियों, 408, 409, 429 और 5xx को छोटी एक्सपोनेंशियल प्रतीक्षा के साथ रीट्राई करता है। दो रीट्राई पहले से डिफ़ॉल्ट हैं;WithMaxRetries(2) 0रीट्राई बंद कर देता है। आप इसे क्लाइंट पर, या एकल कॉल पर सेट कर सकते हैं।option.: एक प्रयास की सीमा।WithRequestTimeout(30*time. Second) contextडेडलाइन: पूरी कॉल की सीमा, रीट्राई और प्रतीक्षाओं सहित।
तो 2 रीट्राई के साथ अधिकतम 3 प्रयास हो सकते हैं: 3 × 30 = 90 सेकंड की प्रतीक्षा सबसे खराब स्थिति में, साथ में प्रयासों के बीच छोटे विराम। दो मिनट का कॉन्टेक्स्ट इसे कवर करता है। यदि आप वेब हैंडलर के लिए 20 सेकंड के भीतर कठोर उत्तर नियम चाहते हैं, तो कॉन्टेक्स्ट छोटा करें, केवल प्रति-प्रयास टाइमआउट नहीं।
इन संख्याओं को चुनने की लंबी पृष्ठभूमि के लिए, उसी सलाह का Python संस्करण OpenAI Python SDK timeout and retries में है। तर्क Go पर भी लागू होता है।
ऐसी एक हज़ार कॉल की लागत#
मान लें आप एक छोटी सेवा चलाते हैं जो प्रतिदिन 1,000 रिक्वेस्ट करती है, प्रत्येक में लगभग 800 इनपुट टोकन और 300 आउटपुट टोकन। deepseek- पर उस दिन की लागत $0.042 है (1,000 × 800 इनपुट टोकन, 1,000 × 300 आउटपुट टोकन)। तालिका हमारे मॉडलों में वही लोड दिखाती है; कुल में गिना जाए, इनपुट और आउटपुट सहित, यह OpenRouter से सस्ता है।
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
प्रति अनुरोध 800 इनपुट और 300 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
अपनी संख्याएँ डालें। आपका पहला रन असली PromptTokens और CompletionTokens प्रिंट करता है, इसलिए आपको औसत का अनुमान लगाने की ज़रूरत नहीं:
लागत कैलकुलेटर
एक छोटी Go सेवा का एक दिन
प्रति अनुरोध इनपुट टोकन: 800 · प्रति अनुरोध आउटपुट टोकन: 300 · प्रति दिन अनुरोध: 1,000
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
मूल्य पृष्ठ और मॉडल पृष्ठ पर कीमतें लाइव हैं और प्रति मॉडल एक निश्चित मूल्य का उपयोग करती हैं, बिना किसी पीक आवर्स के।
यदि यह काम न करे#
- त्रुटि में 401 का उल्लेख है: कुंजी खाली या गलत है।
os.Getenvअनसेट वेरिएबल के लिए खाली स्ट्रिंग लौटाता है, इसलिए उसी टर्मिनल मेंecho $CHEAPTOKENS_जाँचें जहाँ आपAPI_ KEY go run .चलाते हैं। - त्रुटि में 404 या अज्ञात मॉडल का उल्लेख है: आईडी। इसे पूरा कॉपी करें,
deepseek-ai/प्रीफ़िक्स के साथ। आप मॉडल सूची कॉल में आईडी सूचीबद्ध कर सकते हैं। go: module requires Go 1.: आपका टूलचेन पुराना है। ऊपर दिखाए अनुसार पुराना SDK टैग पिन करें।26 - कॉल हैंग होकर फिर विफल हो जाती है: यह टाइमआउट अपना काम कर रहा है। पहले नेटवर्क पथ जाँचें, फिर
WithRequestTimeoutबढ़ाएँ यदि मॉडल को लंबे उत्तर के लिए वास्तव में अधिक समय चाहिए।
यदि base URL का विचार आपके लिए नया है, तो base_url क्या है और कैसे स्विच करें इसे बिना कोड के समझाता है।


