API اور SDKگائیڈ
openai-go کے ساتھ Go میں پہلی درخواست: base URL، key، usage
ایک مکمل Go پروگرام جو openai-go کے ذریعے CheapTokens ماڈل کال کرتا ہے اور جواب، finish_reason اور token usage پرنٹ کرتا ہے، retries اور timeout کے ساتھ۔
اس صفحہ پر
آپ کے پاس پہلے سے Go کوڈ موجود ہے جو OpenAI طرز کی API سے بات کرتا ہے، یا آپ ایسا لکھنے والے ہیں۔ اسے CheapTokens پر بھیجنے کے لیے آپ کلائنٹ پر دو آپشنز اور ایک سٹرنگ، یعنی model id، تبدیل کرتے ہیں۔ SDK وہی رہتا ہے: آفیشل openai-go پیکیج، v3۔
نیچے پورا پروگرام ہے، پھر ہر لائن کیا کرتی ہے، جواب اور token counts کیسے پڑھیں، اور کیسے ایک اٹکی ہوئی درخواست کو آپ کی سروس کو لٹکانے سے روکیں۔ ورژنز 3 نومبر 2026 کو openai-go README کے مطابق جانچے گئے: اس صفحے پر تازہ ترین ٹیگ v3.91.1 ہے، اور اسے Go 1.26 یا اس سے نیا درکار ہے۔
شروع کرنے سے پہلے آپ کو کیا چاہیے#
- Go 1.26 یا اس سے نیا۔ Go 1.25 پر
v3.74.0پن کریں؛ Go 1.22–1.24 پرv3.44.0پن کریں (README کہتا ہے کہ پرانی لائن کو کوئی یقینی فکس نہیں ملتی)۔ - ایک CheapTokens API key۔ اسے environment variable میں رکھیں، سورس فائل میں نہیں۔
- API ایڈریس:
https:/۔ یہ OpenAI Chat Completions فارمیٹ بولتا ہے، اس لیے openai-go بغیر کسی wrapper کے کام کرتا ہے۔ docs میں وہی ایڈریس اور key کا صفحہ ہے۔/ api. cheaptokens. dev/ v1 - ایک model id۔ ہم
deepseek-استعمال کرتے ہیں: 380K context اور ایک جواب میں زیادہ سے زیادہ 32,768 tokens۔ مکمل id استعمال کریں؛ قیمت کے جدولوں والا مختصر نام API قبول نہیں کرتا۔ai/ DeepSeek- V4- Flash- 0731
قدم بہ قدم
پروجیکٹ سیٹ اپ کریں
SDK انسٹال کریں
ایک خالی فولڈر میں:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
import path github. ہے، پیکیج کا نام openai ہے۔
key کو environment میں رکھیں
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell پر: $env:CHEAPTOKENS_۔ placeholder کوئی حقیقی key نہیں ہے۔
main.go بنائیں اور چلائیں
اگلے سیکشن کا پروگرام main.go میں پیسٹ کریں، پھر go run . چلائیں۔
پورا پروگرام#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
اہم حصے:
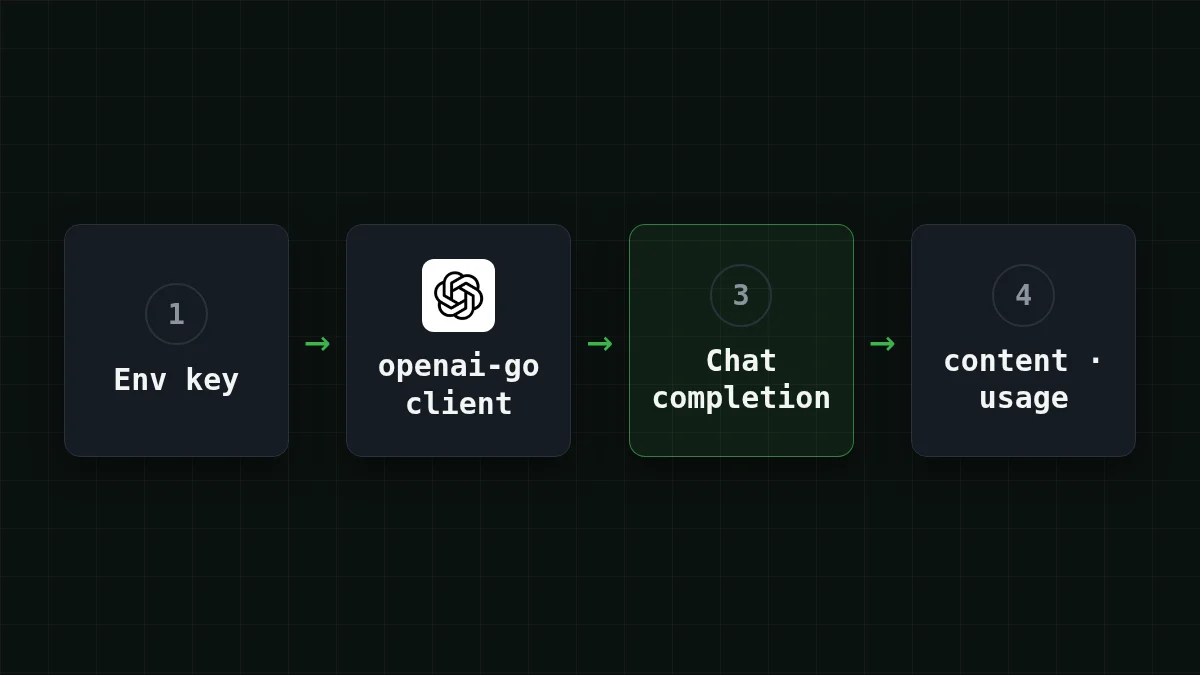
option.واحد لائن ہے جو SDK کو OpenAI سے CheapTokens پر منتقل کرتی ہے۔ ایڈریس بالکل ویسا ہی استعمال کریں جیسا docs میں ہے۔WithBaseURL(. . . ) option.key کو واضح طور پر پاس کرتا ہے۔ اس کے بغیر کلائنٹWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEYپڑھتا ہے، جو موجودہ کوڈ پورٹ کرتے وقت آسان ہے: اس variable کو CheapTokens key پر سیٹ کریں اور کوڈ میں key کی کوئی تبدیلی درکار نہیں۔ یہیOPENAI_BASE_URLکے لیے بھی ہے، لیکن واضحWithBaseURLاسے override کرتا ہے، اس لیے دونوں موجود ہوں تو کوئی حیرت نہیں۔ModelSDK میں ایک سادہ سٹرنگ ہے (ChatModel،stringکا alias ہے)، اس لیے کوئی بھی model id کام کرتا ہے، صرف وہ constants نہیں جو README دکھاتا ہے۔openai.ایک user turn ہے۔ README کی مثالUserMessage(. . . ) DeveloperMessageاور ایک GPT constant استعمال کرتی ہے؛ یہاں ایک user message اور سٹرنگ id کافی ہیں۔
جواب، finish_reason اور usage پڑھیں#
تینوں SDK کے ان فیلڈز سے آتے ہیں جو یہ آپ کے لیے پہلے سے parse کرتا ہے:
resp.متن ہے (ایکChoices[0]. Message. Content string)۔resp.بھی ایکChoices[0]. FinishReason stringہے۔stopکا مطلب ہے کہ ماڈل خود ختم ہوا؛lengthکا مطلب ہے کہ جواب token limit پر پہنچ کر کاٹ دیا گیا۔ اگر آپ کوlengthنظر آئے تو جواب جملے کے بیچ کیوں رکتا ہے پڑھیں۔resp.UsageمیںPromptTokens(جو آپ نے بھیجا)،CompletionTokens(جو ماڈل نے لکھا) اورTotalTokensہیں، سبint64۔
آؤٹ پٹ ایسا دکھے گا: جواب، پھر finish_reason: ایک ویلیو کے ساتھ، پھر تین token counts۔ نمبر ہر رن پر مختلف ہوتے ہیں، اس لیے انہیں log کریں۔ یہی وہ چیز ہے جس کی آپ ادائیگی کرتے ہیں، اور output tokens زیادہ مہنگا پہلو ہیں۔
خود آزمائیںآزمائیں: ماڈل بدلیں تو کیا بدلتا ہے؟جواب دکھائیں
Model سٹرنگ کو zai- میں بدلیں اور دوبارہ چلائیں۔ پروگرام میں کچھ اور نہیں ہلتا۔ جواب کا متن اور تینوں usage نمبر مختلف ہوں گے، جو آپ کے اپنے prompt پر دو ماڈلز کا موازنہ کرنے کا تیز ترین طریقہ ہے۔ GLM-5.3-Flash کا 390K context اور ایک جواب میں زیادہ سے زیادہ 8,192 tokens ہیں۔
Retries اور timeouts: تین مختلف حدیں#
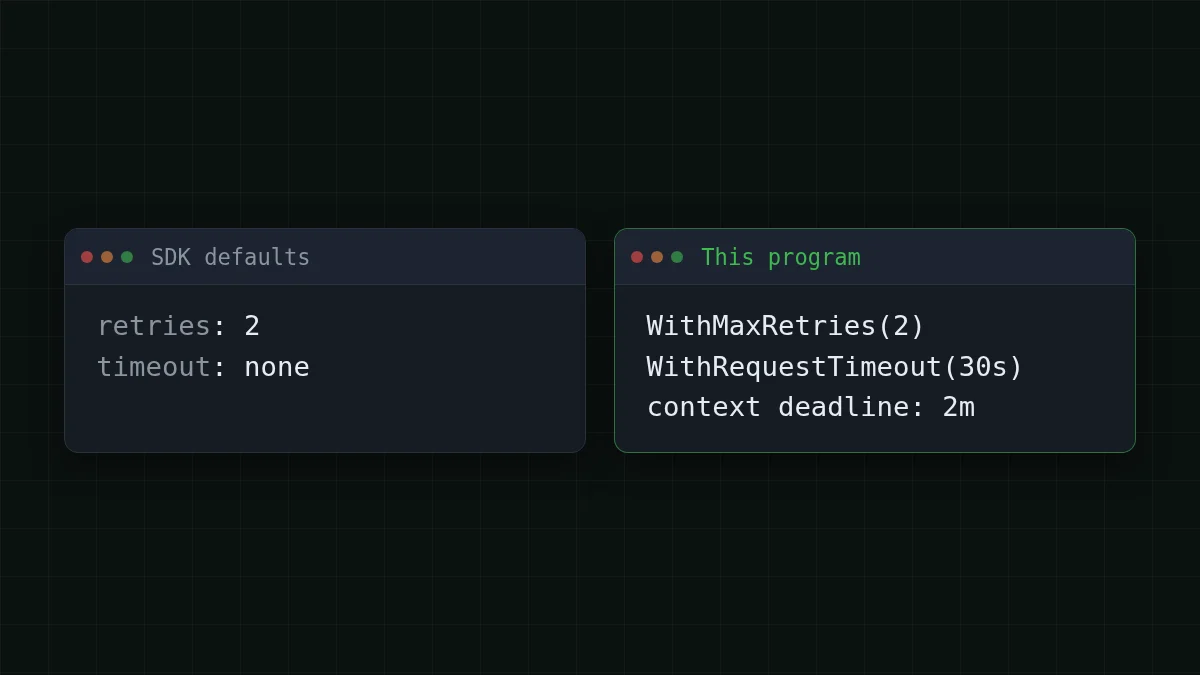
یہیں Go سروسز عام طور پر نقصان اٹھاتی ہیں: بطور ڈیفالٹ SDK کا کوئی timeout نہیں ہوتا، اس لیے اٹکی ہوئی کنکشن ہمیشہ انتظار کر سکتی ہے۔ تین سیٹنگز اسے ٹھیک کرتی ہیں، اور وہ مختلف سطحوں پر کام کرتی ہیں:
option.: SDK کنکشن errors، 408، 409، 429 اور 5xx کو مختصر exponential وقفے کے ساتھ retry کرتا ہے۔ دو retries پہلے سے ڈیفالٹ ہیں؛WithMaxRetries(2) 0retries بند کر دیتا ہے۔ آپ اسے کلائنٹ پر، یا کسی ایک کال پر سیٹ کر سکتے ہیں۔option.: ایک کوشش کی حد۔WithRequestTimeout(30*time. Second) contextdeadline: پوری کال کی حد، retries اور وقفوں سمیت۔
تو 2 retries کے ساتھ زیادہ سے زیادہ 3 کوششیں ہو سکتی ہیں: بدترین صورت میں 3 × 30 = 90 سیکنڈ انتظار، علاوہ کوششوں کے درمیان مختصر وقفوں کے۔ دو منٹ کا context اسے ڈھانپ لیتا ہے۔ اگر آپ ویب handler کے لیے 20 سیکنڈ میں سخت جواب کا اصول چاہتے ہیں تو context مختصر کریں، صرف per-attempt timeout نہیں۔
ان نمبروں کے انتخاب پر مزید پس منظر کے لیے، اسی مشورے کا Python ورژن OpenAI Python SDK timeout and retries میں ہے۔ منطق Go پر بھی لاگو ہوتی ہے۔
ایسی ایک ہزار کالز کی قیمت#
فرض کریں آپ ایک چھوٹی سروس چلاتے ہیں جو روزانہ 1,000 درخواستیں کرتی ہے، ہر ایک میں تقریباً 800 input tokens اور 300 output tokens۔ deepseek- پر اس دن کی قیمت $0.042 ہے (1,000 × 800 input tokens، 1,000 × 300 output tokens)۔ جدول ہمارے ماڈلز پر وہی لوڈ دکھاتا ہے؛ مجموعی طور پر، input اور output ملا کر، یہ OpenRouter سے سستا ہے۔
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
فی درخواست 800 ان پٹ اور 300 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
اپنے نمبر ڈالیں۔ آپ کا پہلا رن اصل PromptTokens اور CompletionTokens پرنٹ کرتا ہے، اس لیے آپ کو اوسط کا اندازہ لگانے کی ضرورت نہیں:
لاگت کیلکولیٹر
ایک چھوٹی Go سروس کا ایک دن
فی درخواست ان پٹ ٹوکنز: 800 · فی درخواست آؤٹ پٹ ٹوکنز: 300 · فی دن درخواستیں: 1,000
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
pricing page اور models page پر قیمتیں لائیو ہیں اور فی ماڈل ایک مقررہ قیمت استعمال کرتی ہیں، بغیر peak hours کے۔
اگر یہ کام نہ کرے#
- ایرر میں 401 کا ذکر ہو: key خالی یا غلط ہے۔
os.Getenvغیر سیٹ variable کے لیے خالی سٹرنگ لوٹاتا ہے، اس لیے اسی ٹرمینل میںecho $CHEAPTOKENS_چیک کریں جہاں آپAPI_ KEY go run .چلاتے ہیں۔ - ایرر میں 404 یا نامعلوم ماڈل کا ذکر ہو: id۔ اسے مکمل کاپی کریں،
deepseek-ai/prefix کے ساتھ۔ آپ the models list call میں ids کی فہرست دیکھ سکتے ہیں۔ go: module requires Go 1.: آپ کا toolchain پرانا ہے۔ اوپر دکھائے گئے مطابق پرانا SDK ٹیگ پن کریں۔26 - کال لٹکتی ہے اور پھر ناکام ہوتی ہے: یہ timeout اپنا کام کر رہا ہے۔ پہلے نیٹ ورک راستہ چیک کریں، پھر
WithRequestTimeoutبڑھائیں اگر ماڈل کو لمبے جواب کے لیے واقعی زیادہ وقت چاہیے۔
اگر base URL کا تصور آپ کے لیے نیا ہے تو what base_url is and how to switch اسے بغیر کوڈ کے سمجھاتا ہے۔


