API & SDKHướng dẫn
Request đầu tiên bằng Go với openai-go: base URL, key, usage
Một chương trình Go hoàn chỉnh gọi model CheapTokens qua openai-go và in câu trả lời, finish_reason và token usage, kèm thử lại và timeout.
Trên trang này
Bạn đã có sẵn mã Go gọi API kiểu OpenAI, hoặc sắp viết. Để gửi nó tới CheapTokens, bạn đổi hai tùy chọn trên client và một chuỗi, id model. SDK giữ nguyên: gói chính thức openai-go, v3.
Dưới đây là toàn bộ chương trình, rồi từng dòng làm gì, cách đọc câu trả lời và số token, và cách ngăn một request bị treo làm treo dịch vụ của bạn. Phiên bản đối chiếu với README của openai-go ngày 3 tháng 11 năm 2026: tag mới nhất trên trang đó là v3.91.1, và nó cần Go 1.26 trở lên.
Những gì bạn cần trước khi bắt đầu#
- Go 1.26 trở lên. Trên Go 1.25 ghim
v3.74.0; trên Go 1.22–1.24 ghimv3.44.0(README nói dòng cũ hơn không được đảm bảo sửa lỗi). - Một API key CheapTokens. Giữ nó trong biến môi trường, không trong tệp nguồn.
- Địa chỉ API:
https:/. Nó nói định dạng OpenAI Chat Completions, nên openai-go chạy được mà không cần wrapper. Tài liệu có cùng địa chỉ và trang key./ api. cheaptokens. dev/ v1 - Một id model. Chúng ta dùng
deepseek-: ngữ cảnh 380K và tối đa 32.768 token trong một câu trả lời. Dùng id đầy đủ; tên ngắn từ bảng giá không được API chấp nhận.ai/ DeepSeek- V4- Flash- 0731
Từng bước một
Thiết lập dự án
Cài SDK
Trong một thư mục trống:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Đường dẫn import là github., tên gói là openai.
Đưa key vào môi trường
export CHEAPTOKENS_API_KEY="paste-your-key-here"Trên Windows PowerShell: $env:CHEAPTOKENS_. Placeholder không phải key thật.
Tạo main.go và chạy nó
Dán chương trình ở phần tiếp theo vào main.go, rồi chạy go run ..
Toàn bộ chương trình#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}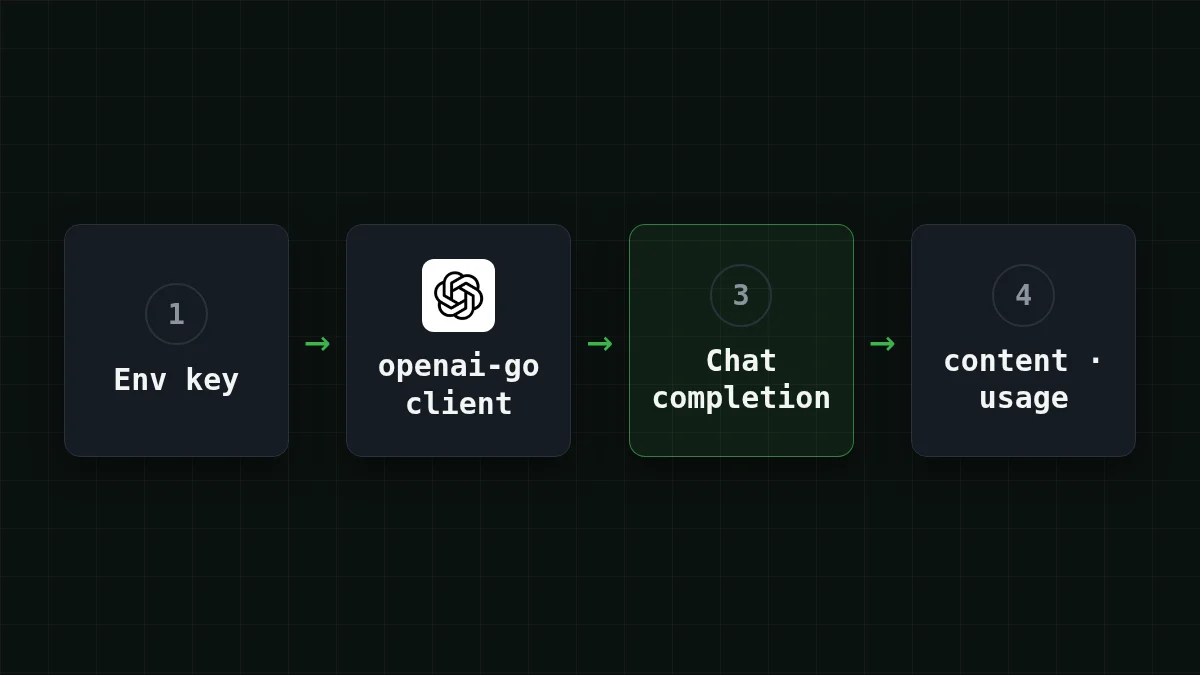
Những phần quan trọng:
option.là dòng duy nhất chuyển SDK từ OpenAI sang CheapTokens. Dùng địa chỉ đúng như trong tài liệu.WithBaseURL(. . . ) option.truyền key tường minh. Không có nó, client đọcWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, tiện khi bạn chuyển mã có sẵn: đặt biến đó thành key CheapTokens và mã không cần đổi key. Tương tự vớiOPENAI_BASE_URL, nhưngWithBaseURLtường minh sẽ ghi đè nó, nên không bất ngờ nếu cả hai cùng tồn tại.Modellà chuỗi thuần trong SDK (ChatModellà bí danh củastring), nên id model nào cũng được, không chỉ các hằng số README hiển thị.openai.là một lượt người dùng. Ví dụ trong README dùngUserMessage(. . . ) DeveloperMessagevà một hằng số GPT; ở đây một tin nhắn người dùng và id dạng chuỗi là đủ.
Đọc câu trả lời, finish_reason và usage#
Cả ba đến từ các trường SDK đã phân tích sẵn cho bạn:
resp.là văn bản (mộtChoices[0]. Message. Content string).resp.cũng là mộtChoices[0]. FinishReason string.stopnghĩa là model tự kết thúc;lengthnghĩa là câu trả lời chạm giới hạn token và bị cắt. Nếu bạn thấylength, đọc vì sao câu trả lời dừng giữa câu.resp.UsagechứaPromptTokens(những gì bạn gửi),CompletionTokens(những gì model viết) vàTotalTokens, tất cả làint64.
Kết quả sẽ trông như thế này: câu trả lời, rồi finish_reason: với một giá trị, rồi ba số token. Các con số khác nhau mỗi lần chạy, nên hãy ghi log chúng. Chúng là thứ bạn trả tiền, và token đầu ra là phía đắt hơn.
Tự mình thử xemThử: điều gì thay đổi nếu bạn đổi model?Hiện đáp án
Đổi chuỗi Model thành zai- và chạy lại. Không gì khác trong chương trình thay đổi. Văn bản câu trả lời và ba số usage sẽ khác, đó là cách nhanh nhất để so sánh hai model trên prompt của chính bạn. GLM-5.3-Flash có ngữ cảnh 390K và tối đa 8.192 token trong một câu trả lời.
Thử lại và timeout: ba giới hạn khác nhau#
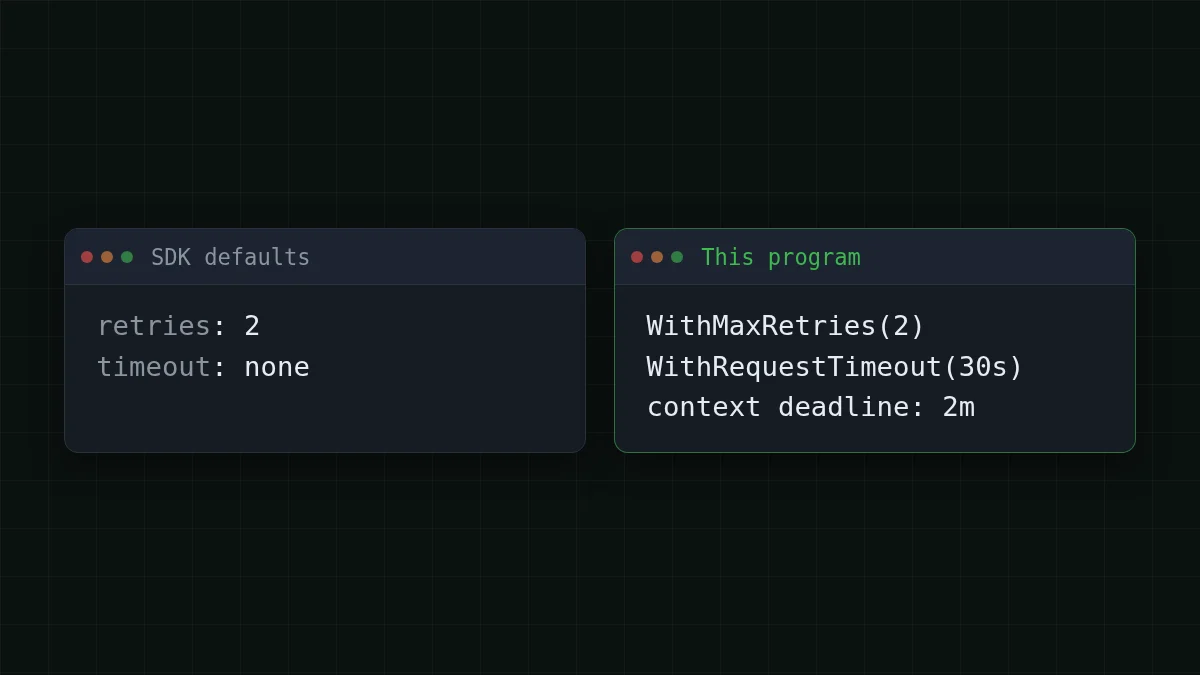
Đây là chỗ các dịch vụ Go thường bị tổn thương: mặc định SDK không có timeout nào cả, nên một kết nối bị kẹt có thể chờ mãi mãi. Ba thiết lập khắc phục điều đó, và chúng hoạt động ở các mức khác nhau:
option.: SDK thử lại lỗi kết nối, 408, 409, 429 và 5xx với thời gian chờ lũy thừa ngắn. Hai lần thử lại đã là mặc định;WithMaxRetries(2) 0tắt thử lại. Bạn có thể đặt trên client, hoặc trên một lần gọi.option.: giới hạn cho một lần thử.WithRequestTimeout(30*time. Second) - Hạn chót
context: giới hạn cho toàn bộ lần gọi, gồm cả thử lại và chờ đợi.
Vậy với 2 lần thử lại có thể có tới 3 lần thử: 3 × 30 = 90 giây chờ trong trường hợp xấu nhất, cộng các khoảng dừng ngắn giữa các lần thử. Một ngữ cảnh hai phút bao được điều đó. Nếu bạn muốn quy tắc cứng là trả lời trong 20 giây cho một web handler, hãy rút ngắn ngữ cảnh, không chỉ timeout mỗi lần thử.
Để có nền tảng dài hơn về chọn các con số này, phiên bản Python của cùng lời khuyên nằm trong OpenAI Python SDK timeout and retries. Logic áp dụng được cho Go.
Một nghìn lần gọi như thế tốn bao nhiêu#
Giả sử bạn chạy một dịch vụ nhỏ thực hiện 1.000 request mỗi ngày, mỗi request khoảng 800 token đầu vào và 300 token đầu ra. Trên deepseek-, ngày đó tốn $0.042 (1.000 × 800 token đầu vào, 1.000 × 300 token đầu ra). Bảng hiển thị cùng tải đó trên các model của chúng tôi; tính tổng, gồm cả đầu vào và đầu ra, nó rẻ hơn OpenRouter.
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 token đầu vào và 300 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Điền số của chính bạn. Lần chạy đầu tiên in ra PromptTokens và CompletionTokens thật, nên bạn không phải đoán trung bình:
Máy tính chi phí
Một ngày của một dịch vụ Go nhỏ
Token đầu vào mỗi yêu cầu: 800 · Token đầu ra mỗi yêu cầu: 300 · Số yêu cầu mỗi ngày: 1.000
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Giá trên trang giá và trang model là trực tiếp và dùng một mức giá cố định cho mỗi model, không có giờ cao điểm.
Nếu nó không chạy#
- Lỗi nhắc tới 401: key trống hoặc sai.
os.Getenvtrả về chuỗi rỗng cho biến chưa đặt, nên kiểm traecho $CHEAPTOKENS_trong cùng terminal nơi bạn chạyAPI_ KEY go run .. - Lỗi nhắc tới 404 hoặc model không xác định: id. Sao chép đầy đủ, kèm tiền tố
deepseek-ai/. Bạn có thể liệt kê id trong lệnh gọi danh sách model. go: module requires Go 1.: toolchain của bạn cũ hơn. Ghim một tag SDK cũ hơn như hiển thị ở đầu.26 - Lần gọi bị treo rồi thất bại: đó là timeout đang làm việc của nó. Kiểm tra đường mạng trước, rồi tăng
WithRequestTimeoutnếu model thực sự cần thêm thời gian cho một câu trả lời dài.
Nếu ý tưởng base URL còn mới với bạn, base_url là gì và cách chuyển giải thích không cần mã.


