API & SDKAnleitung
Erste Anfrage in Go mit openai-go: Base-URL, Key, Usage
Ein vollständiges Go-Programm, das über openai-go ein CheapTokens-Modell aufruft und Antwort, finish_reason und Token-Usage ausgibt, mit Retries und einem Timeout.
Auf dieser Seite
Du hast bereits Go-Code, der mit einer OpenAI-kompatiblen API spricht, oder du stehst kurz davor, welchen zu schreiben. Um ihn an CheapTokens zu senden, änderst du zwei Optionen am Client und einen String, die Model-ID. Das SDK bleibt dasselbe: das offizielle openai-go-Paket, v3.
Unten steht das ganze Programm, dann was jede Zeile tut, wie du die Antwort und die Token-Zählungen liest und wie du verhinderst, dass eine hängende Anfrage deinen Service blockiert. Versionen geprüft gegen die openai-go-README vom 3. November 2026: das neueste Tag auf dieser Seite ist v3.91.1, und es benötigt Go 1.26 oder neuer.
Was du vor dem Start brauchst#
- Go 1.26 oder neuer. Auf Go 1.25 pinne
v3.74.0; auf Go 1.22–1.24 pinnev3.44.0(laut README bekommt die ältere Linie keine garantierten Fixes). - Einen CheapTokens-API-Key. Bewahre ihn in einer Umgebungsvariable auf, nicht in der Quelldatei.
- Die API-Adresse:
https:/. Sie spricht das OpenAI-Chat-Completions-Format, also funktioniert openai-go ohne Wrapper. Die Docs enthalten dieselbe Adresse und die Key-Seite./ api. cheaptokens. dev/ v1 - Eine Model-ID. Wir verwenden
deepseek-: 380K Kontext und bis zu 32.768 Tokens in einer Antwort. Verwende die vollständige ID; der Kurzname aus Preistabellen wird von der API nicht akzeptiert.ai/ DeepSeek- V4- Flash- 0731
Schritt für Schritt
Projekt einrichten
SDK installieren
In einem leeren Ordner:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Der Importpfad ist github., der Paketname ist openai.
Key in die Umgebung legen
export CHEAPTOKENS_API_KEY="paste-your-key-here"Unter Windows PowerShell: $env:CHEAPTOKENS_. Der Platzhalter ist kein echter Key.
main.go anlegen und ausführen
Füge das Programm aus dem nächsten Abschnitt in main.go ein und führe dann go run . aus.
Das ganze Programm#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}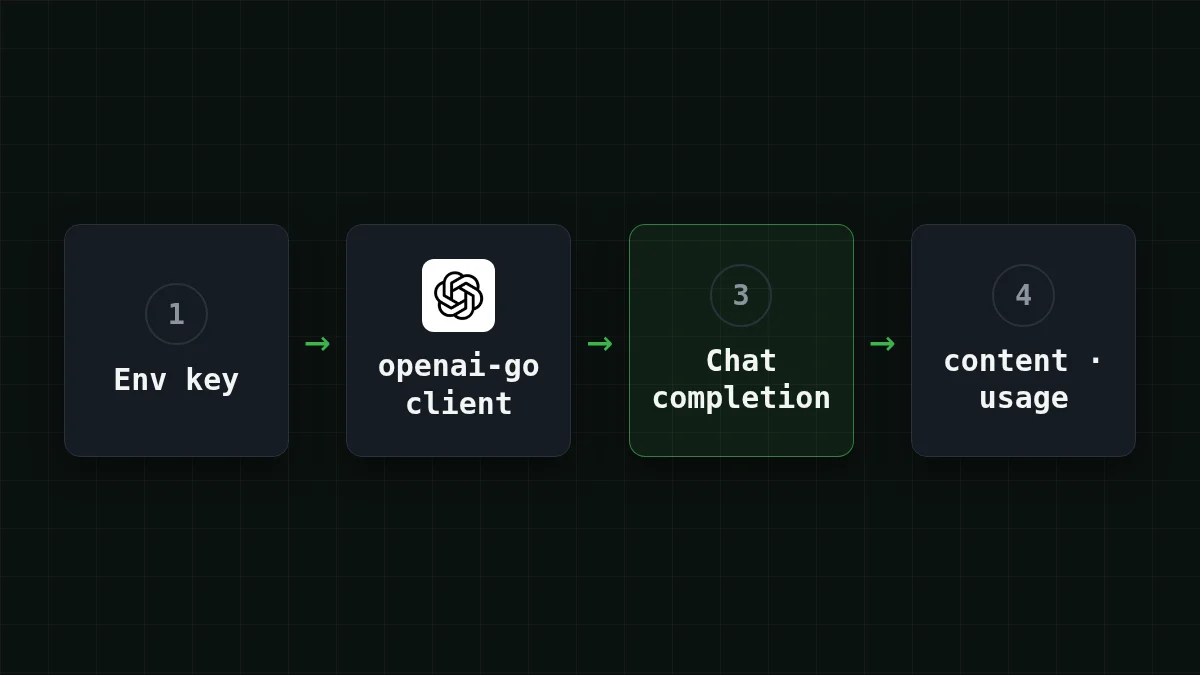
Die entscheidenden Stellen:
option.ist die einzige Zeile, die das SDK von OpenAI auf CheapTokens umstellt. Verwende die Adresse genau wie in den Docs.WithBaseURL(. . . ) option.übergibt den Key explizit. Ohne sie liest der ClientWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, was praktisch ist, wenn du bestehenden Code portierst: setze diese Variable auf einen CheapTokens-Key, und der Code braucht keine Key-Änderung. Dasselbe gilt fürOPENAI_BASE_URL, aber ein explizitesWithBaseURLüberschreibt es, sodass es keine Überraschung gibt, wenn beides existiert.Modelist im SDK ein einfacher String (ChatModelist ein Alias vonstring), also funktioniert jede Model-ID, nicht nur die Konstanten, die die README zeigt.openai.ist ein User-Turn. Das README-Beispiel verwendetUserMessage(. . . ) DeveloperMessageund eine GPT-Konstante; hier reichen eine User-Nachricht und eine String-ID.
Die Antwort, finish_reason und usage lesen#
Alle drei kommen aus Feldern, die das SDK bereits für dich parst:
resp.ist der Text (einChoices[0]. Message. Content string).resp.ist ebenfalls einChoices[0]. FinishReason string.stopbedeutet, dass das Modell von selbst fertig wurde;lengthbedeutet, dass die Antwort das Token-Limit erreicht hat und abgeschnitten wurde. Wenn dulengthsiehst, lies warum eine Antwort mitten im Satz endet.resp.UsageenthältPromptTokens(was du gesendet hast),CompletionTokens(was das Modell geschrieben hat) undTotalTokens, alleint64.
Die Ausgabe sieht so aus: die Antwort, dann finish_reason: mit einem Wert, dann drei Token-Zählungen. Die Zahlen unterscheiden sich bei jedem Lauf, also logge sie. Sie sind das, wofür du bezahlst, und Output-Tokens sind die teurere Seite.
Probier es selbstProbier es aus: Was ändert sich, wenn du das Modell tauschst?Antwort anzeigen
Ändere den String Model zu zai- und führe es erneut aus. Sonst bewegt sich nichts im Programm. Der Antworttext und die drei Usage-Zahlen unterscheiden sich, was der schnellste Weg ist, zwei Modelle mit deinem eigenen Prompt zu vergleichen. GLM-5.3-Flash hat einen 390K-Kontext und bis zu 8.192 Tokens in einer Antwort.
Retries und Timeouts: drei verschiedene Limits#
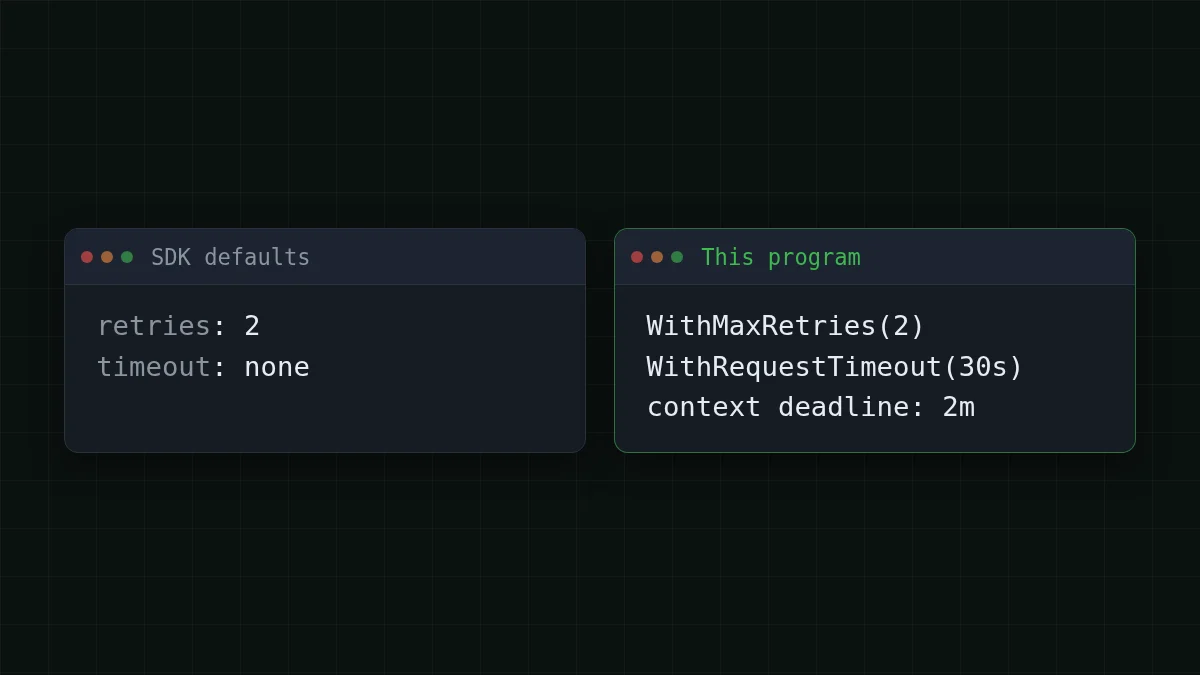
Hier werden Go-Services üblicherweise getroffen: standardmäßig hat das SDK überhaupt keinen Timeout, sodass eine hängende Verbindung ewig warten kann. Drei Einstellungen beheben das, und sie wirken auf unterschiedlichen Ebenen:
option.: Das SDK wiederholt Verbindungsfehler, 408, 409, 429 und 5xx mit kurzer exponentieller Wartezeit. Zwei Retries sind bereits der Standard;WithMaxRetries(2) 0schaltet Retries ab. Du kannst es am Client oder für einen einzelnen Aufruf setzen.option.: das Limit für einen Versuch.WithRequestTimeout(30*time. Second) - Die
context-Deadline: das Limit für den gesamten Aufruf, Retries und Wartezeiten eingeschlossen.
Mit 2 Retries gibt es also bis zu 3 Versuche: 3 × 30 = 90 Sekunden Wartezeit im schlimmsten Fall, plus die kurzen Pausen zwischen den Versuchen. Ein Kontext von zwei Minuten deckt das ab. Wenn du für einen Web-Handler eine harte Regel „Antwort innerhalb von 20 Sekunden“ willst, verkürze den Kontext, nicht nur den Timeout pro Versuch.
Für mehr Hintergrund zur Wahl dieser Zahlen findest du die Python-Version desselben Rats in OpenAI Python SDK timeout and retries. Die Logik überträgt sich auf Go.
Was tausend dieser Aufrufe kosten#
Angenommen, du betreibst einen kleinen Service mit 1.000 Anfragen pro Tag, jede mit etwa 800 Input-Tokens und 300 Output-Tokens. Auf deepseek- kostet dieser Tag $0.042 (1.000 × 800 Input-Tokens, 1.000 × 300 Output-Tokens). Die Tabelle zeigt dieselbe Last über unsere Modelle; insgesamt gezählt, Input und Output zusammen, ist es günstiger als OpenRouter.
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Setze deine eigenen Zahlen ein. Dein erster Lauf gibt die echten PromptTokens und CompletionTokens aus, sodass du den Durchschnitt nicht raten musst:
Kostenrechner
Ein Tag eines kleinen Go-Service
Eingabe-Tokens pro Anfrage: 800 · Ausgabe-Tokens pro Anfrage: 300 · Anfragen pro Tag: 1.000
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Preise auf der Preisseite und der Modellseite sind live und verwenden einen festen Preis pro Modell, ohne Stoßzeiten.
Wenn es nicht funktioniert#
- Der Fehler nennt 401: Der Key ist leer oder falsch.
os.Getenvgibt für eine nicht gesetzte Variable einen leeren String zurück, also prüfeecho $CHEAPTOKENS_in demselben Terminal, in dem duAPI_ KEY go run .ausführst. - Der Fehler nennt 404 oder ein unbekanntes Modell: die ID. Kopiere sie vollständig, mit dem Präfix
deepseek-ai/. Du kannst IDs im Models-List-Aufruf auflisten. go: module requires Go 1.: Deine Toolchain ist älter. Pinne ein älteres SDK-Tag wie oben gezeigt.26 - Der Aufruf hängt und schlägt dann fehl: Das ist der Timeout, der seine Arbeit tut. Prüfe zuerst den Netzwerkpfad und erhöhe dann
WithRequestTimeout, wenn das Modell für eine lange Antwort wirklich mehr Zeit braucht.
Wenn dir die Idee der Base-URL neu ist, erklärt was base_url ist und wie man wechselt es ohne Code.


