API & SDKPanduan
Permintaan pertama di Go dengan openai-go: base URL, kunci, usage
Program Go lengkap yang memanggil model CheapTokens melalui openai-go dan mencetak jawaban, finish_reason dan penggunaan token, dengan percobaan ulang dan timeout.
Di halaman ini
Anda sudah memiliki kode Go yang berbicara dengan API bergaya OpenAI, atau Anda akan segera menulisnya. Untuk mengirimkannya ke CheapTokens Anda mengubah dua opsi pada klien dan satu string, yaitu id model. SDK tetap sama: paket resmi openai-go, v3.
Di bawah ini adalah seluruh program, lalu apa yang dilakukan setiap baris, cara membaca jawaban dan jumlah token, serta cara mencegah permintaan yang macet menggantungkan layanan Anda. Versi diperiksa terhadap README openai-go pada 3 November 2026: tag terbaru di halaman itu adalah v3.91.1, dan membutuhkan Go 1.26 atau lebih baru.
Yang Anda butuhkan sebelum memulai#
- Go 1.26 atau lebih baru. Pada Go 1.25 pin
v3.74.0; pada Go 1.22–1.24 pinv3.44.0(README menyatakan lini lama tidak mendapat perbaikan yang dijamin). - Kunci API CheapTokens. Simpan di variabel lingkungan, bukan di file sumber.
- Alamat API:
https:/. Ini berbicara format OpenAI Chat Completions, jadi openai-go bekerja tanpa pembungkus. Dokumentasi memiliki alamat yang sama dan halaman kunci./ api. cheaptokens. dev/ v1 - Id model. Kami menggunakan
deepseek-: konteks 380K dan hingga 32.768 token dalam satu jawaban. Gunakan id lengkap; nama pendek dari tabel harga tidak diterima oleh API.ai/ DeepSeek- V4- Flash- 0731
Langkah demi langkah
Siapkan proyek
Pasang SDK
Di folder kosong:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Jalur impor adalah github., nama paket adalah openai.
Letakkan kunci di lingkungan
export CHEAPTOKENS_API_KEY="paste-your-key-here"Di Windows PowerShell: $env:CHEAPTOKENS_. Placeholder bukan kunci asli.
Buat main.go dan jalankan
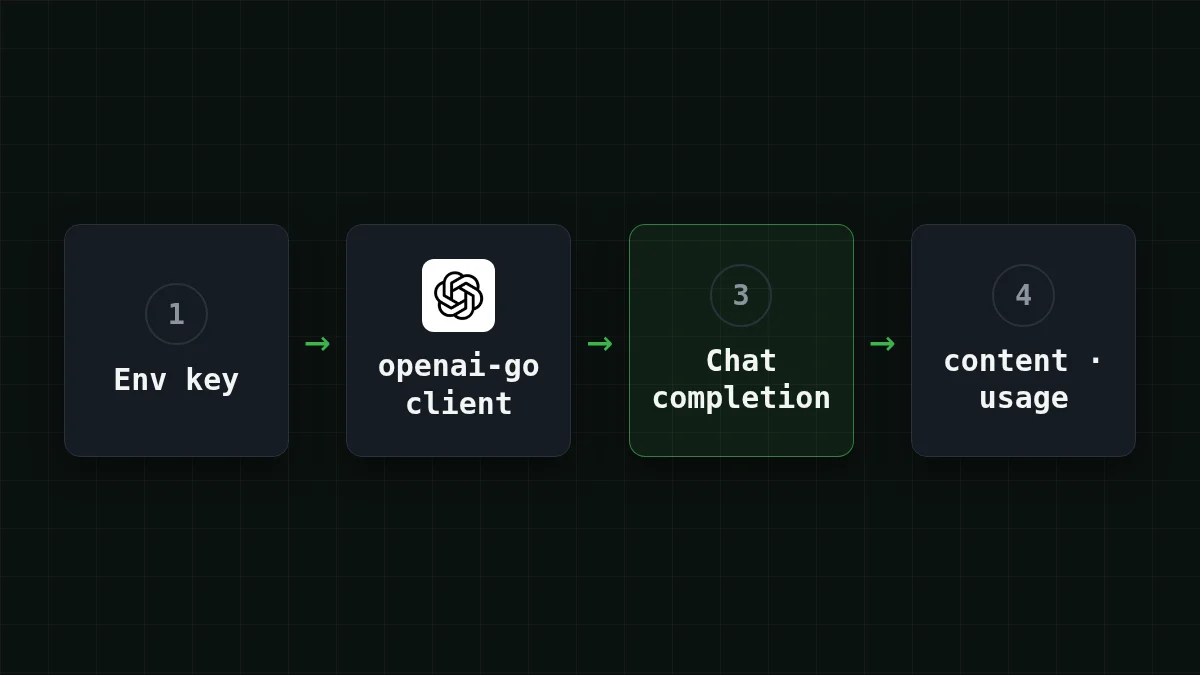
Tempel program dari bagian berikutnya ke main.go, lalu jalankan go run ..
Seluruh program#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
Bagian yang penting:
option.adalah satu-satunya baris yang memindahkan SDK dari OpenAI ke CheapTokens. Gunakan alamat persis seperti di dokumentasi.WithBaseURL(. . . ) option.meneruskan kunci secara eksplisit. Tanpanya klien membacaWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, yang berguna saat Anda memindahkan kode yang ada: atur variabel itu ke kunci CheapTokens dan kode tidak perlu mengubah kunci. Hal yang sama berlaku untukOPENAI_BASE_URL, tetapiWithBaseURLeksplisit menimpanya, jadi tidak ada kejutan jika keduanya ada.Modeladalah string biasa di SDK (ChatModeladalah alias daristring), jadi id model apa pun berfungsi, bukan hanya konstanta yang ditunjukkan README.openai.adalah satu giliran pengguna. Contoh README menggunakanUserMessage(. . . ) DeveloperMessagedan konstanta GPT; di sini pesan pengguna dan id string sudah cukup.
Baca jawaban, finish_reason dan usage#
Ketiganya berasal dari field yang sudah diurai SDK untuk Anda:
resp.adalah teksnya (sebuahChoices[0]. Message. Content string).resp.juga sebuahChoices[0]. FinishReason string.stopberarti model selesai sendiri;lengthberarti jawaban mencapai batas token dan terpotong. Jika Anda melihatlength, baca mengapa jawaban berhenti di tengah kalimat.resp.UsageberisiPromptTokens(yang Anda kirim),CompletionTokens(yang ditulis model) danTotalTokens, semuanyaint64.
Outputnya akan terlihat seperti ini: jawaban, lalu finish_reason: dengan sebuah nilai, lalu tiga jumlah token. Angkanya berbeda di setiap eksekusi, jadi catatlah. Itulah yang Anda bayar, dan token output adalah sisi yang lebih mahal.
Coba sendiriCoba: apa yang berubah jika Anda menukar model?Tampilkan jawaban
Ubah string Model menjadi zai- dan jalankan lagi. Tidak ada hal lain dalam program yang berubah. Teks jawaban dan tiga angka usage akan berbeda, yang merupakan cara tercepat untuk membandingkan dua model pada prompt Anda sendiri. GLM-5.3-Flash memiliki konteks 390K dan hingga 8.192 token dalam satu jawaban.
Percobaan ulang dan timeout: tiga batas berbeda#
Di sinilah layanan Go biasanya dirugikan: secara default SDK tidak memiliki timeout sama sekali, jadi koneksi yang macet dapat menunggu selamanya. Tiga pengaturan memperbaikinya, dan mereka bekerja pada tingkat yang berbeda:
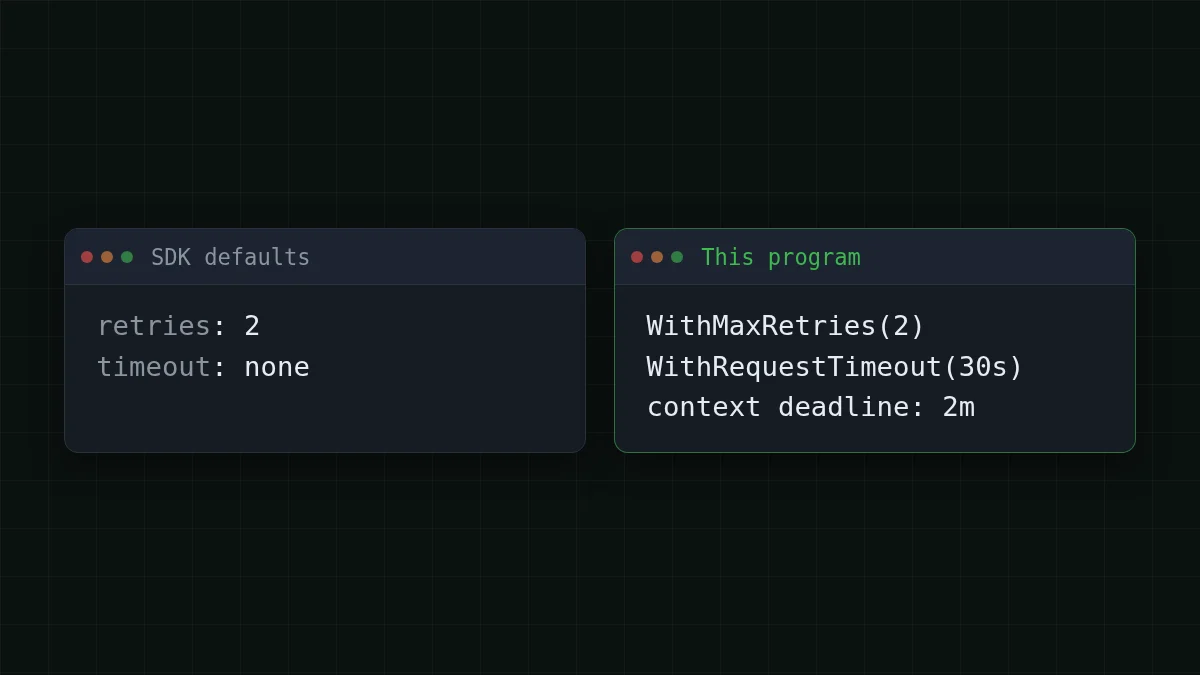
option.: SDK mencoba ulang kesalahan koneksi, 408, 409, 429 dan 5xx dengan jeda eksponensial singkat. Dua percobaan ulang sudah menjadi default;WithMaxRetries(2) 0mematikan percobaan ulang. Anda dapat mengaturnya pada klien, atau pada satu panggilan.option.: batas untuk satu percobaan.WithRequestTimeout(30*time. Second) - Tenggat
context: batas untuk seluruh panggilan, termasuk percobaan ulang dan jeda.
Jadi dengan 2 percobaan ulang bisa ada hingga 3 percobaan: 3 × 30 = 90 detik menunggu paling buruk, ditambah jeda singkat antar percobaan. Konteks dua menit mencakup itu. Jika Anda ingin aturan keras jawaban-dalam-20-detik untuk handler web, perpendek konteksnya, bukan hanya timeout per percobaan.
Untuk latar belakang lebih panjang tentang memilih angka-angka ini, versi Python dari saran yang sama ada di timeout dan percobaan ulang OpenAI Python SDK. Logikanya berlaku juga untuk Go.
Berapa biaya seribu panggilan seperti ini#
Katakanlah Anda menjalankan layanan kecil yang membuat 1.000 permintaan sehari, masing-masing dengan sekitar 800 token input dan 300 token output. Pada deepseek- hari itu berbiaya $0.042 (1.000 × 800 token input, 1.000 × 300 token output). Tabel menunjukkan beban yang sama di seluruh model kami; dihitung secara total, dengan input dan output bersama, ini lebih murah daripada OpenRouter.
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 token input dan 300 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Masukkan angka Anda sendiri. Eksekusi pertama Anda mencetak PromptTokens dan CompletionTokens yang sebenarnya, jadi Anda tidak perlu menebak rata-ratanya:
Kalkulator biaya
Satu hari layanan Go kecil
Token input per permintaan: 800 · Token output per permintaan: 300 · Permintaan per hari: 1.000
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Harga di halaman harga dan halaman model bersifat langsung dan menggunakan satu harga tetap per model, tanpa jam sibuk.
Jika tidak berhasil#
- Kesalahan menyebutkan 401: kuncinya kosong atau salah.
os.Getenvmengembalikan string kosong untuk variabel yang tidak diatur, jadi periksaecho $CHEAPTOKENS_di terminal yang sama tempat Anda menjalankanAPI_ KEY go run .. - Kesalahan menyebutkan 404 atau model tidak dikenal: id-nya. Salin secara lengkap, dengan awalan
deepseek-ai/. Anda dapat mendaftar id di panggilan daftar model. go: module requires Go 1.: toolchain Anda lebih lama. Pin tag SDK yang lebih lama seperti yang ditunjukkan di atas.26 - Panggilan menggantung lalu gagal: itu timeout yang menjalankan tugasnya. Periksa jalur jaringan terlebih dahulu, lalu naikkan
WithRequestTimeoutjika model benar-benar membutuhkan lebih banyak waktu untuk jawaban panjang.
Jika ide base URL baru bagi Anda, apa itu base_url dan cara beralih menjelaskannya tanpa kode.


