API y SDKGuía
Primera petición en Go con openai-go: base URL, clave, usage
Un programa Go completo que llama a un modelo de CheapTokens mediante openai-go e imprime la respuesta, finish_reason y el uso de tokens, con reintentos y un tiempo de espera.
En esta página
Ya tienes código Go que habla con una API al estilo OpenAI, o estás a punto de escribirlo. Para enviarlo a CheapTokens cambias dos opciones del cliente y una cadena, el id del modelo. El SDK sigue siendo el mismo: el paquete oficial openai-go, v3.
A continuación está el programa completo, luego qué hace cada línea, cómo leer la respuesta y los recuentos de tokens, y cómo evitar que una petición atascada cuelgue tu servicio. Versiones comprobadas con el README de openai-go el 3 de noviembre de 2026: la última etiqueta de esa página es v3.91.1, y necesita Go 1.26 o superior.
Qué necesitas antes de empezar#
- Go 1.26 o superior. En Go 1.25 fija
v3.74.0; en Go 1.22–1.24 fijav3.44.0(el README dice que la línea antigua no recibe correcciones garantizadas). - Una clave de API de CheapTokens. Guárdala en una variable de entorno, no en el archivo fuente.
- La dirección de la API:
https:/. Habla el formato OpenAI Chat Completions, así que openai-go funciona sin un wrapper. La documentación tiene la misma dirección y la página de la clave./ api. cheaptokens. dev/ v1 - Un id de modelo. Usamos
deepseek-: 380K de contexto y hasta 32.768 tokens en una respuesta. Usa el id completo; la API no acepta el nombre corto de las tablas de precios.ai/ DeepSeek- V4- Flash- 0731
Paso a paso
Configura el proyecto
Instala el SDK
En una carpeta vacía:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
La ruta de importación es github., el nombre del paquete es openai.
Pon la clave en el entorno
export CHEAPTOKENS_API_KEY="paste-your-key-here"En Windows PowerShell: $env:CHEAPTOKENS_. El marcador de posición no es una clave real.
Crea main.go y ejecútalo
Pega el programa de la siguiente sección en main.go, luego ejecuta go run ..
El programa completo#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}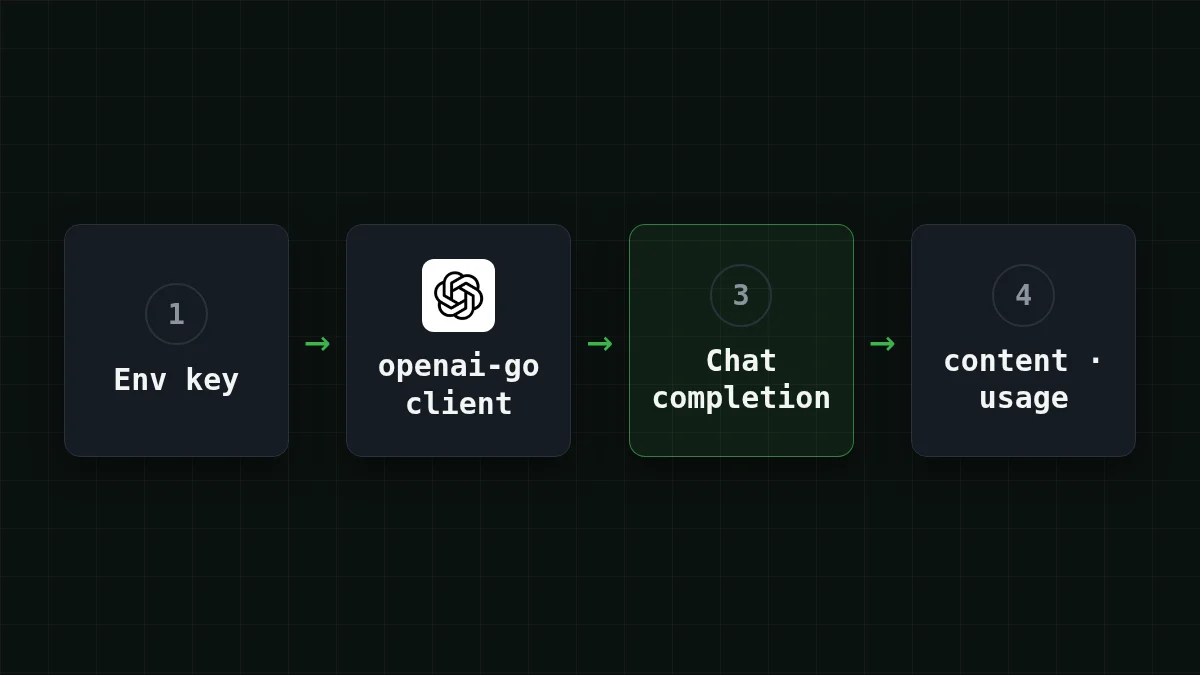
Las piezas que importan:
option.es la única línea que mueve el SDK de OpenAI a CheapTokens. Usa la dirección exactamente como en la documentación.WithBaseURL(. . . ) option.pasa la clave explícitamente. Sin ella, el cliente leeWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, lo cual es útil cuando portas código existente: asigna esa variable a una clave de CheapTokens y el código no necesita cambiar la clave. Lo mismo ocurre conOPENAI_BASE_URL, pero unWithBaseURLexplícito lo anula, así que no hay sorpresa si existen ambos.Modeles una cadena simple en el SDK (ChatModeles un alias destring), así que cualquier id de modelo funciona, no solo las constantes que muestra el README.openai.es un turno de usuario. El ejemplo del README usaUserMessage(. . . ) DeveloperMessagey una constante de GPT; aquí un mensaje de usuario y un id de cadena son suficientes.
Lee la respuesta, finish_reason y usage#
Los tres vienen de campos que el SDK ya analiza por ti:
resp.es el texto (unChoices[0]. Message. Content string).resp.también es unChoices[0]. FinishReason string.stopsignifica que el modelo terminó por su cuenta;lengthsignifica que la respuesta alcanzó el límite de tokens y se cortó. Si veslength, lee por qué una respuesta se detiene a mitad de frase.resp.UsagecontienePromptTokens(lo que enviaste),CompletionTokens(lo que escribió el modelo) yTotalTokens, todosint64.
La salida se verá así: la respuesta, luego finish_reason: con un valor, luego tres recuentos de tokens. Los números cambian en cada ejecución, así que regístralos. Son lo que pagas, y los tokens de salida son el lado más caro.
Pruébalo tú mismoPruébalo: ¿qué cambia si intercambias el modelo?Mostrar respuesta
Cambia la cadena Model a zai- y ejecuta de nuevo. Nada más en el programa se mueve. El texto de la respuesta y los tres números de usage serán distintos, que es la forma más rápida de comparar dos modelos con tu propio prompt. GLM-5.3-Flash tiene 390K de contexto y hasta 8.192 tokens en una respuesta.
Reintentos y tiempos de espera: tres límites distintos#
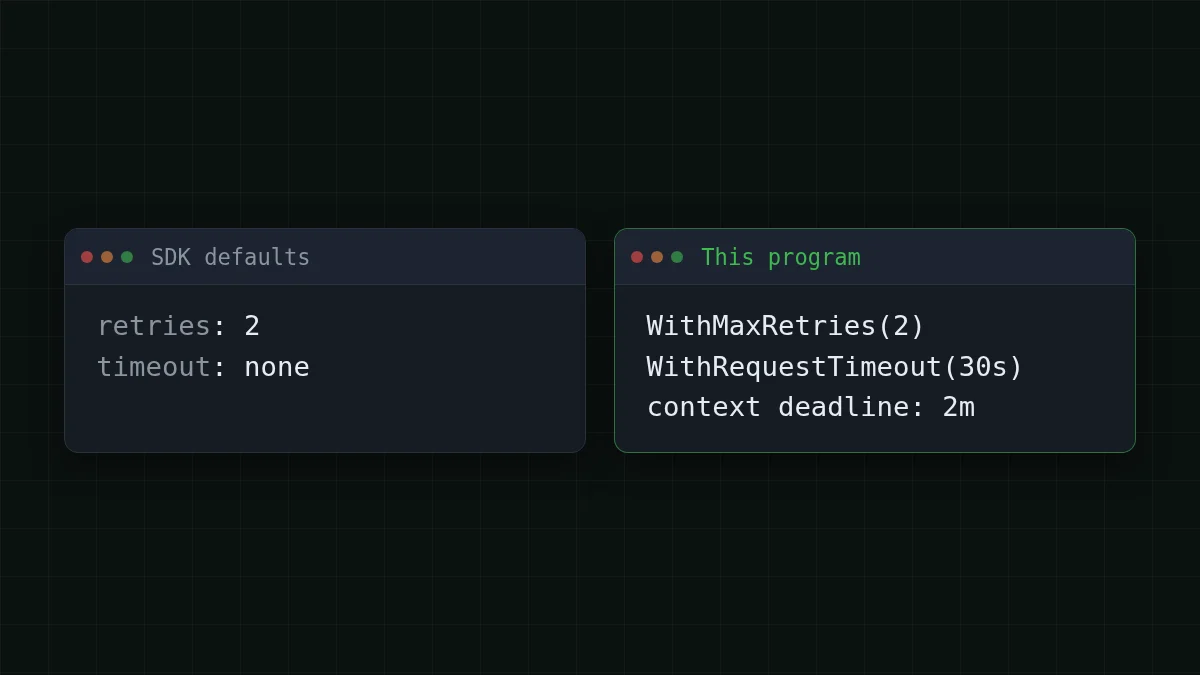
Aquí es donde los servicios Go suelen sufrir: por defecto el SDK no tiene ningún tiempo de espera, así que una conexión atascada puede esperar para siempre. Tres ajustes lo solucionan, y funcionan en niveles distintos:
option.: el SDK reintenta errores de conexión, 408, 409, 429 y 5xx con una breve espera exponencial. Dos reintentos ya es el valor por defecto;WithMaxRetries(2) 0desactiva los reintentos. Puedes configurarlo en el cliente, o en una llamada concreta.option.: el límite para un intento.WithRequestTimeout(30*time. Second) - El plazo de
context: el límite para toda la llamada, reintentos y esperas incluidos.
Así que con 2 reintentos puede haber hasta 3 intentos: 3 × 30 = 90 segundos de espera en el peor caso, más las breves pausas entre intentos. Un contexto de dos minutos lo cubre. Si quieres una regla estricta de respuesta en 20 segundos para un handler web, acorta el contexto, no solo el tiempo de espera por intento.
Para más contexto sobre cómo elegir estos números, la versión en Python del mismo consejo está en Tiempos de espera y reintentos del SDK de OpenAI para Python. La lógica se traslada a Go.
Cuánto cuestan mil de estas llamadas#
Digamos que ejecutas un pequeño servicio que hace 1.000 peticiones al día, cada una con unos 800 tokens de entrada y 300 de salida. En deepseek- ese día cuesta $0.042 (1.000 × 800 tokens de entrada, 1.000 × 300 tokens de salida). La tabla muestra la misma carga en nuestros modelos; contado en total, con entrada y salida juntas, es más barato que OpenRouter.
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Introduce tus propios números. Tu primera ejecución imprime los PromptTokens y CompletionTokens reales, así que no tienes que adivinar la media:
Calculadora de costos
Un día de un pequeño servicio Go
Tokens de entrada por solicitud: 800 · Tokens de salida por solicitud: 300 · Solicitudes por día: 1000
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Los precios de la página de precios y la página de modelos están en vivo y usan un precio fijo por modelo, sin horas punta.
Si no funciona#
- El error menciona 401: la clave está vacía o es incorrecta.
os.Getenvdevuelve una cadena vacía para una variable no definida, así que compruebaecho $CHEAPTOKENS_en la misma terminal donde ejecutasAPI_ KEY go run .. - El error menciona 404 o un modelo desconocido: el id. Cópialo completo, con el prefijo
deepseek-ai/. Puedes listar los ids en la llamada de listado de modelos. go: module requires Go 1.: tu toolchain es más antiguo. Fija una etiqueta del SDK más antigua como se muestra arriba.26 - La llamada se cuelga y luego falla: eso es el tiempo de espera haciendo su trabajo. Comprueba primero la ruta de red, luego aumenta
WithRequestTimeoutsi el modelo realmente necesita más tiempo para una respuesta larga.
Si la idea de base URL es nueva para ti, qué es base_url y cómo cambiarlo lo explica sin código.


