API и SDKИнструкция
Первый запрос на Go через openai-go: base URL, ключ, usage
Готовая программа на Go: вызываем модель CheapTokens через openai-go, печатаем ответ, finish_reason и расход токенов, задаём повторы и таймаут.
Содержание
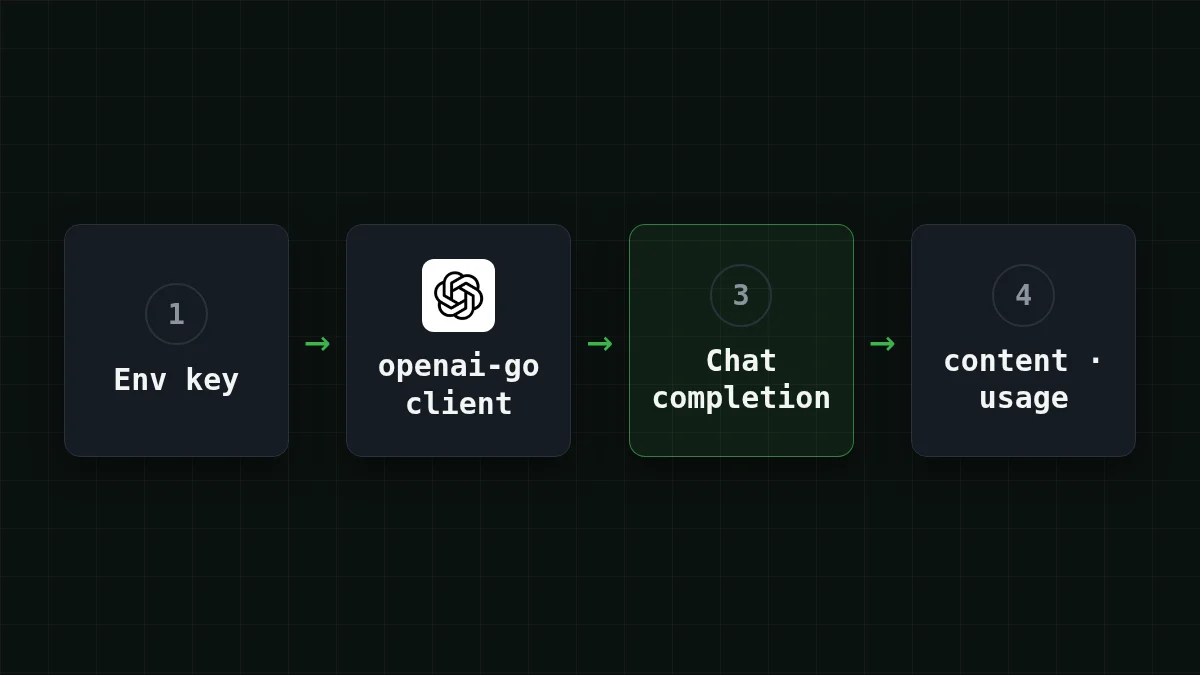
Допустим, у вас уже есть Go-код для OpenAI-совместимого API, или вы только собираетесь его писать. Чтобы отправить его в CheapTokens, нужно поменять две опции клиента и одну строку, id модели. SDK остаётся тем же: официальный пакет openai-go, v3.
Ниже целая программа, потом разбор строк, чтение ответа и счётчиков токенов и защита от зависшего запроса. Версии сверены с README openai-go 3 ноября 2026 года: последний тег на странице — v3.91.1, нужен Go 1.26 или новее.
Что понадобится#
- Go 1.26 или новее. На Go 1.25 закрепите
v3.74.0, на Go 1.22–1.24 —v3.44.0(README: у старой ветки нет гарантированных исправлений). - Ключ CheapTokens. Храните его в переменной окружения, а не в исходнике.
- Адрес API:
https:/. Он понимает формат OpenAI Chat Completions, поэтому openai-go работает без обёрток. Тот же адрес и страница с ключом — в документации./ api. cheaptokens. dev/ v1 - Id модели. Берём
deepseek-: контекст 380K и до 32 768 токенов в одном ответе. Нужен полный id; короткое имя из таблиц цен API не принимает.ai/ DeepSeek- V4- Flash- 0731
Шаг за шагом
Подготовьте проект
Установите SDK
В пустой папке:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Путь импорта — github., имя пакета — openai.
Положите ключ в окружение
export CHEAPTOKENS_API_KEY="paste-your-key-here"В Windows PowerShell: $env:CHEAPTOKENS_. Это заглушка, а не настоящий ключ.
Создайте main.go и запустите
Вставьте программу из следующего раздела в main.go и выполните go run ..
Вся программа#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
Что здесь важно:
option.— единственная строка, которая переводит SDK с OpenAI на CheapTokens. Адрес берите ровно как в документации.WithBaseURL(. . . ) option.передаёт ключ явно. Без неё клиент читаетWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY— удобно при переносе готового кода: положите в эту переменную ключ CheapTokens, и код менять не нужно. СOPENAI_BASE_URLтак же, но явныйWithBaseURLего переопределяет, так что при обеих настройках сюрпризов нет.Modelв SDK — обычная строка (ChatModel— алиасstring), поэтому подходит любой id модели, а не только константы из README.openai.— одна реплика пользователя. В примере README стоятUserMessage(. . . ) DeveloperMessageи константа GPT; нам хватает пользовательского сообщения и строки с id.
Ответ, finish_reason и usage#
Всё это SDK уже разобрал в поля:
resp.— текст (Choices[0]. Message. Content string).resp.— тожеChoices[0]. FinishReason string.stop— модель закончила сама,length— ответ упёрся в лимит токенов и обрезан. Если видитеlength, прочитайте почему ответ обрывается на полуслове.resp.Usage—PromptTokens(что вы отправили),CompletionTokens(что написала модель) иTotalTokens, всеint64.
На экране будет так: сначала ответ, затем finish_reason: со значением и три счётчика токенов. Числа каждый раз разные, так что логируйте их: именно за них вы платите, причём выходные токены стоят дороже.
Попробуйте самиПопробуйте: что изменится, если сменить модель?Показать ответ
Замените строку Model на zai- и запустите снова. Остальная программа не меняется. Текст ответа и три числа usage будут другими — это самый быстрый способ сравнить две модели на вашем промпте. У GLM-5.3-Flash контекст 390K и до 8 192 токенов в одном ответе.
Повторы и таймауты: три разных лимита#
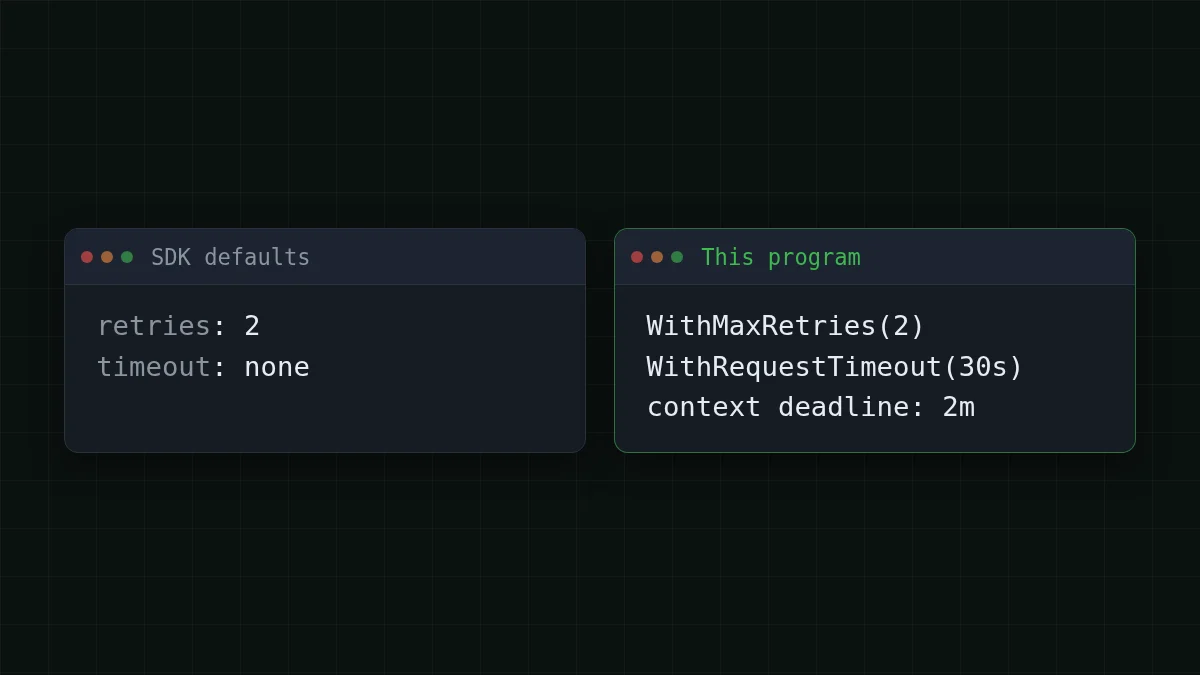
Именно здесь Go-сервисы обычно обжигаются: по умолчанию у SDK вообще нет таймаута, и зависшее соединение может ждать вечно. Исправляют это три настройки, и работают они на разных уровнях:
option.: SDK повторяет запрос при ошибках соединения, 408, 409, 429 и 5xx с короткой экспоненциальной паузой. Два повтора — это и так значение по умолчанию;WithMaxRetries(2) 0отключает повторы. Задаётся на клиенте или на отдельном вызове.option.: лимит одной попытки.WithRequestTimeout(30*time. Second) - Дедлайн
context: лимит всего вызова вместе с повторами и паузами.
При двух повторах попыток может быть до трёх: 3 × 30 = 90 секунд ожидания в худшем случае плюс короткие паузы между попытками. Контекста на две минуты хватает. Если для веб-обработчика нужно жёсткое «ответить за 20 секунд», сокращайте контекст, а не только таймаут попытки.
О том, как подобрать числа, подробнее — в статье про таймауты и повторы в Python SDK: логика переносится на Go.
Сколько стоит тысяча таких вызовов#
Допустим, небольшой сервис делает 1 000 запросов в день, в каждом около 800 токенов входа и 300 токенов выхода. На deepseek- такой день стоит $0.042 (1 000 × 800 токенов входа, 1 000 × 300 токенов выхода). Таблица показывает ту же нагрузку по нашим моделям; в сумме, с учётом входа и выхода, это дешевле OpenRouter.
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 входных и 300 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Подставьте свои числа. Первый запуск напечатает настоящие PromptTokens и CompletionTokens, так что среднее гадать не придётся:
Калькулятор стоимости
День небольшого Go-сервиса
Входные токены на запрос: 800 · Выходные токены на запрос: 300 · Запросов в день: 1 000
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Цены на странице цен и на странице моделей живые: у каждой модели одна цена, без пиковых часов.
Если не работает#
- В ошибке 401: ключ пустой или неверный.
os.Getenvдля незаданной переменной возвращает пустую строку, поэтому выполнитеecho $CHEAPTOKENS_в том же терминале, где запускаетеAPI_ KEY go run .. - В ошибке 404 или «неизвестная модель»: id. Скопируйте его целиком, с префиксом
deepseek-ai/. Список id можно получить запросом списка моделей. go: module requires Go 1.: тулчейн старше. Закрепите более старый тег SDK, как написано в начале.26 - Вызов висит, потом падает: это таймаут делает свою работу. Сначала проверьте сеть, затем увеличьте
WithRequestTimeout, если модели правда нужно больше времени на длинный ответ.
Если идея base URL для вас нова, что такое base_url и как его сменить объяснено без кода.


