API & SDK가이드
openai-go로 Go에서 첫 요청: base URL, 키, usage
openai-go를 통해 CheapTokens 모델을 호출하고 응답, finish_reason, 토큰 사용량을 출력하는 완전한 Go 프로그램으로, 재시도와 타임아웃을 포함합니다.
이 페이지의 내용
OpenAI 스타일 API와 통신하는 Go 코드가 이미 있거나, 곧 작성하려고 합니다. 이를 CheapTokens로 보내려면 클라이언트의 옵션 두 개와 문자열 하나, 즉 모델 id만 바꾸면 됩니다. SDK는 그대로입니다: 공식 openai-go 패키지, v3.
아래에는 전체 프로그램, 각 줄이 하는 일, 응답과 토큰 수를 읽는 방법, 멈춘 요청이 서비스를 멈추지 않게 하는 방법이 나옵니다. 버전은 2026년 11월 3일 openai-go README 기준으로 확인했습니다: 해당 페이지의 최신 태그는 v3.91.1이며, Go 1.26 이상이 필요합니다.
시작하기 전에 필요한 것#
- Go 1.26 이상. Go 1.25에서는
v3.74.0를 고정하고, Go 1.22–1.24에서는v3.44.0를 고정하세요(README에 따르면 이전 라인은 수정이 보장되지 않습니다). - CheapTokens API 키. 소스 파일이 아니라 환경 변수에 보관하세요.
- API 주소:
https:/. OpenAI Chat Completions 형식을 사용하므로 openai-go가 래퍼 없이 동작합니다. 문서에 같은 주소와 키 페이지가 있습니다./ api. cheaptokens. dev/ v1 - 모델 id.
deepseek-를 사용합니다: 380K 컨텍스트와 한 응답에 최대 32,768 토큰. 전체 id를 사용하세요. 가격표의 짧은 이름은 API에서 허용되지 않습니다.ai/ DeepSeek- V4- Flash- 0731
단계별로
프로젝트 설정
SDK 설치
빈 폴더에서:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
임포트 경로는 github.이고, 패키지 이름은 openai입니다.
키를 환경에 넣기
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell에서는 $env:CHEAPTOKENS_입니다. 플레이스홀더는 실제 키가 아닙니다.
main.go를 만들고 실행하기
다음 섹션의 프로그램을 main.go에 붙여넣은 다음 go run .를 실행하세요.
전체 프로그램#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
중요한 부분:
option.는 SDK를 OpenAI에서 CheapTokens로 옮기는 유일한 줄입니다. 문서에 나온 주소를 그대로 사용하세요.WithBaseURL(. . . ) option.는 키를 명시적으로 전달합니다. 이것이 없으면 클라이언트는WithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY를 읽는데, 기존 코드를 이식할 때 편리합니다: 그 변수를 CheapTokens 키로 설정하면 코드에서 키를 바꿀 필요가 없습니다.OPENAI_BASE_URL도 마찬가지지만, 명시적인WithBaseURL가 이를 덮어쓰므로 둘 다 있어도 놀랄 일은 없습니다.Model는 SDK에서 일반 문자열입니다(ChatModel는string의 별칭). 따라서 README에 나온 상수뿐 아니라 어떤 모델 id든 사용할 수 있습니다.openai.는 사용자 턴 하나입니다. README 예제는UserMessage(. . . ) DeveloperMessage와 GPT 상수를 사용하지만, 여기서는 사용자 메시지와 문자열 id로 충분합니다.
응답, finish_reason, usage 읽기#
세 가지 모두 SDK가 이미 파싱해 주는 필드에서 나옵니다:
resp.는 텍스트입니다(Choices[0]. Message. Content string).resp.도Choices[0]. FinishReason string입니다.stop은 모델이 스스로 끝냈다는 뜻이고,length는 응답이 토큰 한도에 걸려 잘렸다는 뜻입니다.length가 보이면 응답이 문장 중간에 멈추는 이유를 읽어 보세요.resp.Usage에는PromptTokens(보낸 것),CompletionTokens(모델이 쓴 것),TotalTokens이 들어 있으며, 모두int64입니다.
출력은 다음과 같습니다: 응답, 그다음 값이 있는 finish_reason:, 그다음 세 개의 토큰 수. 숫자는 실행할 때마다 다르므로 로그로 남기세요. 이것이 지불하는 대상이며, 출력 토큰이 더 비싼 쪽입니다.
직접 해보기시도해 보기: 모델을 바꾸면 무엇이 달라질까?정답 보기
Model 문자열을 zai-로 바꾸고 다시 실행하세요. 프로그램의 다른 부분은 바뀌지 않습니다. 응답 텍스트와 세 개의 usage 숫자가 달라지며, 이것이 자신의 프롬프트에서 두 모델을 비교하는 가장 빠른 방법입니다. GLM-5.3-Flash는 390K 컨텍스트와 한 응답에 최대 8,192 토큰을 가집니다.
재시도와 타임아웃: 세 가지 다른 한도#
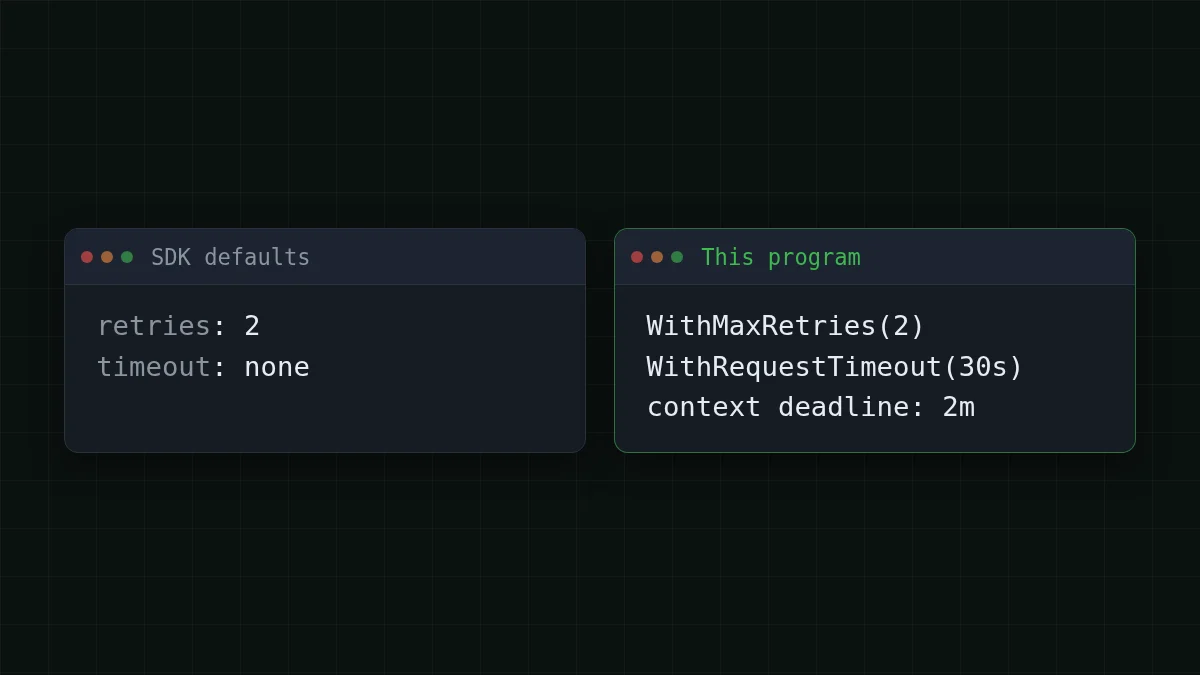
Go 서비스가 보통 상처받는 지점입니다: 기본적으로 SDK에는 타임아웃이 전혀 없어서, 멈춘 연결이 영원히 기다릴 수 있습니다. 세 가지 설정이 이를 해결하며, 서로 다른 수준에서 동작합니다:
option.: SDK는 연결 오류, 408, 409, 429, 5xx를 짧은 지수 대기로 재시도합니다. 두 번 재시도가 이미 기본값이며,WithMaxRetries(2) 0는 재시도를 끕니다. 클라이언트에 설정하거나 단일 호출에 설정할 수 있습니다.option.: 한 번 시도의 한도.WithRequestTimeout(30*time. Second) context데드라인: 재시도와 대기를 포함한 전체 호출의 한도.
따라서 재시도 2회면 최대 3번 시도가 가능합니다: 최악의 경우 3 × 30 = 90초 대기, 여기에 시도 사이의 짧은 멈춤이 더해집니다. 2분 컨텍스트면 이를 커버합니다. 웹 핸들러에 20초 내 응답이라는 엄격한 규칙을 원한다면, 시도별 타임아웃만이 아니라 컨텍스트를 줄이세요.
이 숫자를 고르는 데 대한 더 긴 배경은 같은 조언의 Python 버전인 OpenAI Python SDK timeout and retries에 있습니다. 논리는 Go에도 그대로 적용됩니다.
이런 호출 1,000번의 비용#
하루에 1,000건의 요청을 보내는 작은 서비스를 운영하고, 각 요청이 약 800 입력 토큰과 300 출력 토큰이라고 가정해 봅시다. deepseek-에서 그날 비용은 $0.042입니다(1,000 × 800 입력 토큰, 1,000 × 300 출력 토큰). 표는 같은 부하를 우리 모델 전반에 보여줍니다. 입력과 출력을 합친 총량으로 계산하면 OpenRouter보다 저렴합니다.
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,000회 요청 | OpenRouter, 1,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
요청당 입력 800개 및 출력 300개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
자신의 숫자를 넣어 보세요. 첫 실행에서 실제 PromptTokens와 CompletionTokens가 출력되므로 평균을 추측할 필요가 없습니다:
비용 계산기
작은 Go 서비스의 하루
요청당 입력 토큰: 800 · 요청당 출력 토큰: 300 · 일일 요청 수: 1,000
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
가격 페이지와 모델 페이지의 가격은 실시간이며 모델당 하나의 고정 가격을 사용하고 피크 시간이 없습니다.
동작하지 않을 때#
- 오류에 401이 언급됨: 키가 비어 있거나 잘못되었습니다.
os.Getenv는 설정되지 않은 변수에 빈 문자열을 반환하므로,go run .를 실행하는 같은 터미널에서echo $CHEAPTOKENS_를 확인하세요.API_ KEY - 오류에 404 또는 알 수 없는 모델이 언급됨: id입니다.
deepseek-ai/접두사를 포함해 전체를 복사하세요. 모델 목록 호출에서 id를 나열할 수 있습니다. go: module requires Go 1.: 툴체인이 오래되었습니다. 위에 나온 대로 이전 SDK 태그를 고정하세요.26 - 호출이 멈췄다가 실패함: 타임아웃이 제 역할을 한 것입니다. 먼저 네트워크 경로를 확인한 다음, 모델이 긴 응답에 정말 더 많은 시간이 필요하다면
WithRequestTimeout를 늘리세요.
base URL 개념이 처음이라면, base_url이 무엇이고 어떻게 전환하는지를 코드 없이 설명합니다.


