API e SDKGuia
Primeira requisição em Go com openai-go: base URL, chave, usage
Um programa Go completo que chama um modelo CheapTokens via openai-go e imprime a resposta, finish_reason e o uso de tokens, com retentativas e timeout.
Nesta página
Você já tem código Go que conversa com uma API no estilo OpenAI, ou está prestes a escrever algum. Para enviá-lo ao CheapTokens, você muda duas opções no client e uma string, o id do modelo. O SDK continua o mesmo: o pacote oficial openai-go, v3.
Abaixo está o programa completo, depois o que cada linha faz, como ler a resposta e as contagens de tokens, e como impedir que uma requisição travada deixe seu serviço pendurado. Versões verificadas no README do openai-go em 3 de novembro de 2026: a tag mais recente naquela página é v3.91.1, e ela exige Go 1.26 ou mais novo.
O que você precisa antes de começar#
- Go 1.26 ou mais novo. No Go 1.25 fixe
v3.74.0; no Go 1.22–1.24 fixev3.44.0(o README diz que a linha mais antiga não recebe correções garantidas). - Uma chave de API do CheapTokens. Mantenha-a em uma variável de ambiente, não no arquivo de código.
- O endereço da API:
https:/. Ele fala o formato OpenAI Chat Completions, então o openai-go funciona sem wrapper. A documentação tem o mesmo endereço e a página da chave./ api. cheaptokens. dev/ v1 - Um id de modelo. Usamos
deepseek-: contexto de 380K e até 32.768 tokens em uma resposta. Use o id completo; o nome curto das tabelas de preço não é aceito pela API.ai/ DeepSeek- V4- Flash- 0731
Passo a passo
Configure o projeto
Instale o SDK
Em uma pasta vazia:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
O caminho de importação é github., o nome do pacote é openai.
Coloque a chave no ambiente
export CHEAPTOKENS_API_KEY="paste-your-key-here"No Windows PowerShell: $env:CHEAPTOKENS_. O placeholder não é uma chave real.
Crie main.go e execute
Cole o programa da próxima seção em main.go, depois execute go run ..
O programa completo#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
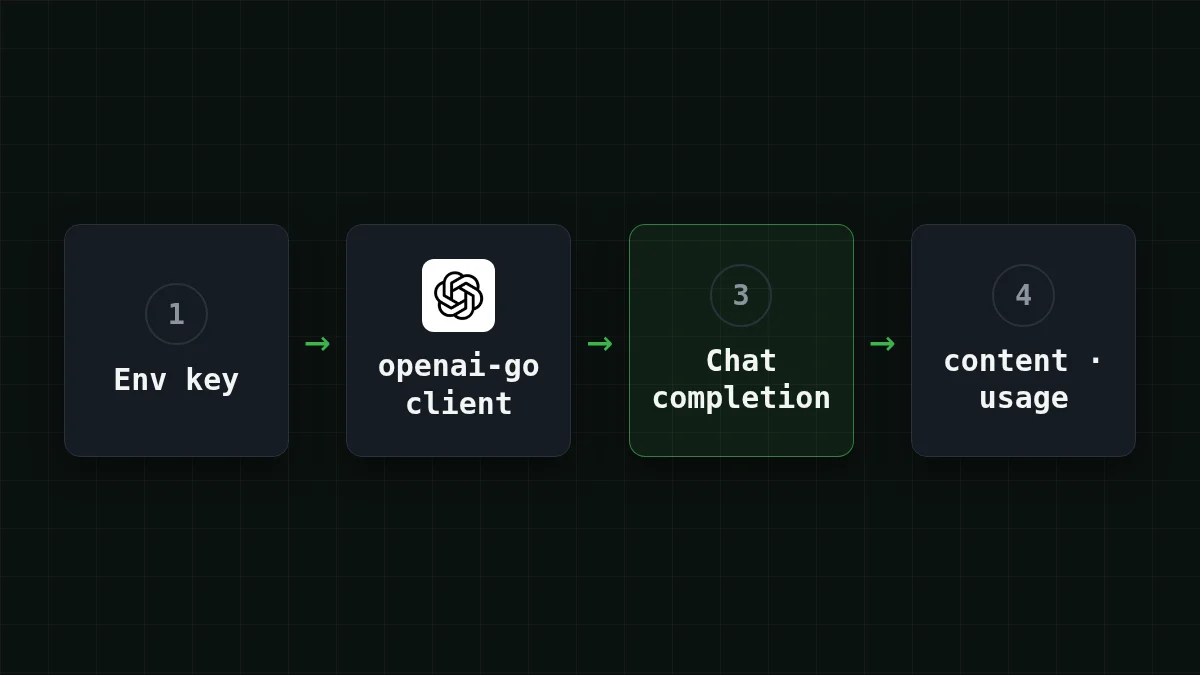
}
As partes que importam:
option.é a única linha que move o SDK da OpenAI para o CheapTokens. Use o endereço exatamente como na documentação.WithBaseURL(. . . ) option.passa a chave explicitamente. Sem ela, o client lêWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, o que é útil quando você porta código existente: defina essa variável com uma chave do CheapTokens e o código não precisa de mudança de chave. O mesmo vale paraOPENAI_BASE_URL, mas umWithBaseURLexplícito tem precedência, então não há surpresa se ambos existirem.Modelé uma string simples no SDK (ChatModelé um alias destring), então qualquer id de modelo funciona, não só as constantes que o README mostra.openai.é um turno de usuário. O exemplo do README usaUserMessage(. . . ) DeveloperMessagee uma constante GPT; aqui uma mensagem de usuário e um id em string bastam.
Leia a resposta, finish_reason e usage#
Os três vêm de campos que o SDK já analisa para você:
resp.é o texto (umChoices[0]. Message. Content string).resp.também é umChoices[0]. FinishReason string.stopsignifica que o modelo terminou por conta própria;lengthsignifica que a resposta atingiu o limite de tokens e foi cortada. Se você virlength, leia por que uma resposta para no meio da frase.resp.UsagecontémPromptTokens(o que você enviou),CompletionTokens(o que o modelo escreveu) eTotalTokens, todosint64.
A saída será assim: a resposta, depois finish_reason: com um valor, depois três contagens de tokens. Os números mudam a cada execução, então registre-os. Eles são o que você paga, e os tokens de saída são o lado mais caro.
Experimente você mesmoExperimente: o que muda se você trocar o modelo?Mostrar resposta
Troque a string Model por zai- e execute de novo. Nada mais no programa muda. O texto da resposta e os três números de usage serão diferentes, o que é a forma mais rápida de comparar dois modelos no seu próprio prompt. O GLM-5.3-Flash tem contexto de 390K e até 8.192 tokens em uma resposta.
Retries e timeouts: três limites diferentes#
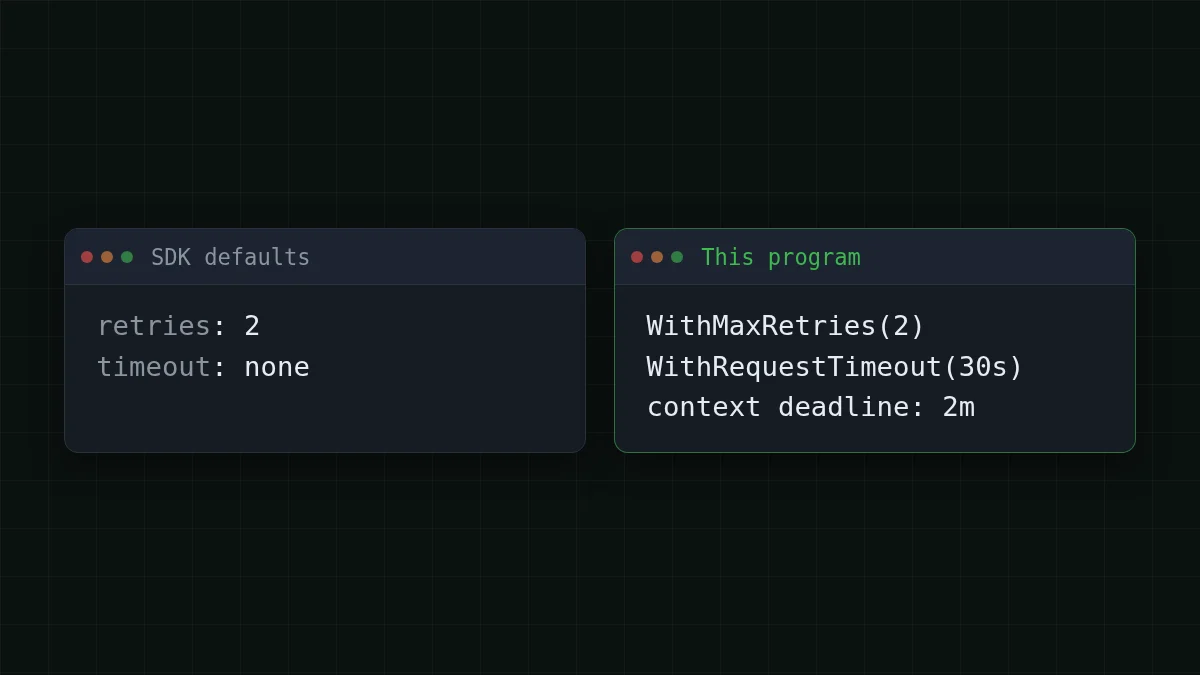
É aqui que os serviços Go costumam se machucar: por padrão o SDK não tem timeout nenhum, então uma conexão travada pode esperar para sempre. Três configurações resolvem isso, e elas atuam em níveis diferentes:
option.: o SDK tenta de novo erros de conexão, 408, 409, 429 e 5xx com uma espera exponencial curta. Duas tentativas já é o padrão;WithMaxRetries(2) 0desliga as retentativas. Você pode definir no client ou em uma chamada individual.option.: o limite para uma tentativa.WithRequestTimeout(30*time. Second) - O deadline do
context: o limite para a chamada inteira, incluindo retentativas e esperas.
Então, com 2 retentativas, pode haver até 3 tentativas: 3 × 30 = 90 segundos de espera no pior caso, mais as pausas curtas entre tentativas. Um contexto de dois minutos cobre isso. Se você quer uma regra rígida de resposta em até 20 segundos para um handler web, encurte o contexto, não só o timeout por tentativa.
Para um histórico mais longo sobre como escolher esses números, a versão em Python do mesmo conselho está em OpenAI Python SDK timeout and retries. A lógica vale para Go.
Quanto custam mil dessas chamadas#
Digamos que você rode um pequeno serviço que faz 1.000 requisições por dia, cada uma com cerca de 800 tokens de entrada e 300 tokens de saída. No deepseek- esse dia custa $0.042 (1.000 × 800 tokens de entrada, 1.000 × 300 tokens de saída). A tabela mostra a mesma carga entre nossos modelos; contado no total, com entrada e saída juntas, é mais barato que o OpenRouter.
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokens de entrada e 300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Coloque seus próprios números. Sua primeira execução imprime os PromptTokens e CompletionTokens reais, então você não precisa adivinhar a média:
Calculadora de custos
Um dia de um pequeno serviço Go
Tokens de entrada por solicitação: 800 · Tokens de saída por solicitação: 300 · Solicitações por dia: 1.000
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Os preços na página de preços e na página de modelos são ao vivo e usam um preço fixo por modelo, sem horários de pico.
Se não funcionar#
- O erro menciona 401: a chave está vazia ou errada.
os.Getenvretorna uma string vazia para uma variável não definida, então verifiqueecho $CHEAPTOKENS_no mesmo terminal em que você executaAPI_ KEY go run .. - O erro menciona 404 ou um modelo desconhecido: o id. Copie-o por completo, com o prefixo
deepseek-ai/. Você pode listar os ids na chamada de listagem de modelos. go: module requires Go 1.: seu toolchain é mais antigo. Fixe uma tag mais antiga do SDK como mostrado no topo.26 - A chamada trava e depois falha: é o timeout fazendo seu trabalho. Verifique o caminho de rede primeiro, depois aumente
WithRequestTimeoutse o modelo realmente precisar de mais tempo para uma resposta longa.
Se a ideia de base URL é nova para você, o que é base_url e como trocar explica sem código.


