API e SDKGuia
Primeira requisição em Rust com async-openai: URL base, chave, uso
Um pequeno programa Rust com tokio e async-openai que envia uma chat completion ao CheapTokens e imprime a resposta e as contagens de tokens.
Nesta página
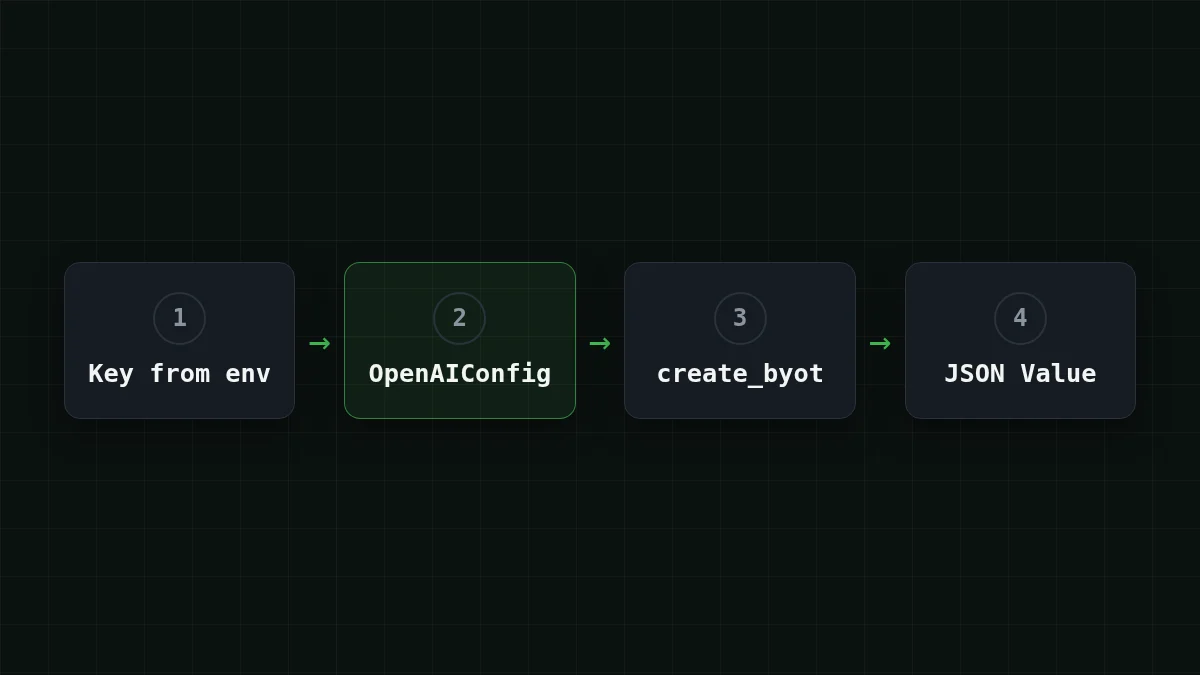
Para chamar o CheapTokens a partir do Rust com async-openai, construa um OpenAIConfig com a URL base https:/ e sua chave, depois envie a requisição com create_byot e um corpo JSON. O texto da resposta e as contagens de tokens saem do JSON retornado. São cerca de 25 linhas de código, e o mesmo programa funciona para qualquer modelo na página de modelos do CheapTokens depois de alterar uma string.
A página docs.rs do crate (verificada em 8 de novembro de 2026) lista a versão 0.43.0 sob a licença MIT, e é essa a versão que este guia segue.
Por que create_byot em vez de requisições tipadas#
O async-openai normalmente oferece um construtor de requisição tipado: você preenche uma struct e recebe uma struct de volta. Isso é confortável até que um gateway retorne um campo que as structs não conhecem. O recurso byot ("traga seus próprios tipos") adiciona métodos *_byot que aceitam qualquer corpo JSON e retornam qualquer tipo em que você consiga desserializar, incluindo um serde_ simples.
Para uma primeira requisição é exatamente o que você quer. Você escreve o mesmo JSON que colocaria numa chamada curl e lê usage direto da resposta, sem precisar procurar nenhum tipo.
Configure o projeto#
Passo a passo
Crie o projeto e defina a chave
Adicione os crates
Em um projeto novo (cargo new cheaptokens-), adicione três dependências. O async-openai precisa de dois recursos aqui: byot para os métodos create_byot e chat-completion para a seção de chat.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Coloque a chave em uma variável de ambiente
Crie a chave na sua conta CheapTokens e mantenha-a fora do código-fonte. Se quiser a versão longa, veja como armazenar uma chave de API com segurança.
export CHEAPTOKENS_API_KEY="paste-your-key-here"No Windows PowerShell a mesma linha é $env:CHEAPTOKENS_.
Execute o programa
Cole o código da próxima seção em src/main.rs e inicie-o.
cargo runO programa#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Três linhas carregam toda a ideia. with_api_base é onde o CheapTokens entra: a URL base termina com /v1, e o async-openai adiciona o caminho do endpoint por conta própria. with_api_key recebe o valor que lemos do ambiente. E model é o id completo deepseek- — os nomes curtos das tabelas de preços não são aceitos pela API.
Indexar um Value com uma chave ausente retorna null em vez de causar panic, então um erro de digitação no nome de um campo aparece como null na saída em vez de um crash. Isso é útil quando você está explorando uma resposta.
O que retorna#
O gateway fala o formato OpenAI Chat Completions, então a resposta tem a forma usual (resumida aqui, os ... marcam campos que omitimos):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
Os números em usage são contagens reais da sua requisição, então eles substituem os zeros quando você executa. prompt_tokens é o que você enviou, completion_ é o que o modelo escreveu. Eles são cobrados a preços diferentes, que é o motivo de imprimi-los. Se a diferença é novidade para você, tokens de entrada vs saída explica em cinco minutos.
Experimente você mesmoExperimente: defina "max_tokens" como 5 e execute novamente. O que finish_reason diz?Mostrar resposta
No formato OpenAI Chat Completions ele diz length. O modelo atingiu seu limite e a frase é cortada no meio. Com uma resposta normal ele diz stop. Se você vir length em um trabalho real, aumente max_tokens — este artigo cobre a correção.
Quanto custa uma requisição#
Digamos que você execute esta chamada em loop, uma pergunta pequena na entrada e uma resposta curta na saída: 300 tokens de entrada e 200 tokens de saída cada. No DeepSeek-V4-Flash isso é $0.000025 por requisição, a partir do preço ao vivo de $0.015 por 1M tokens de entrada e $0.10 por 1M tokens de saída. Somados, entrada e saída, isso é mais barato que o OpenRouter, e o modelo mantém um contexto de 380K e responde até 32.768 tokens.
A tabela abaixo mostra a mesma requisição em todos os modelos, vezes 1.000.
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 tokens de entrada e 200 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Os preços ficam na página de preços.
Trocando o modelo#
O código não muda quando o modelo muda; apenas a string em "model" muda. Por exemplo, zai- tem um contexto de 390K e responde até 8.192 tokens. Para evitar editar o código de vez, leia o id de uma segunda variável com std::env::var("CHEAPTOKENS_. Se você não tem certeza de quais ids sua chave enxerga, liste os modelos com GET /v1/models.
Se não funcionar#
environment variable not foundlogo no início: a chave não foi exportada neste terminal. Exporte-a novamente na mesma janela onde você executacargo run.- Um erro 401 da API: a chave está errada ou tem um espaço ou aspas sobrando em volta.
- Um erro 404: verifique se a URL base termina com
/v1e se o id do modelo é o completo, com o prefixodeepseek-ai/. API 401 ou 404: chave, URL base, id do modelo percorre isso. - O compilador não encontra
create_byot: o recursobyotnão está habilitado. Execute novamente a linhacargo addda configuração.
Para um problema de conexão que não seja nenhum desses, veja os erros de conexão comuns.
A mesma primeira requisição existe para outras linguagens: Go e Ruby. Para mais sobre a API em si, abra a documentação do CheapTokens.


