API और SDKगाइड
async-openai के साथ Rust में पहला अनुरोध: बेस URL, कुंजी, उपयोग
tokio और async-openai के साथ एक छोटा Rust प्रोग्राम जो CheapTokens को एक चैट पूर्णता भेजता है और उत्तर और टोकन गणना प्रिंट करता है।
इस पृष्ठ पर
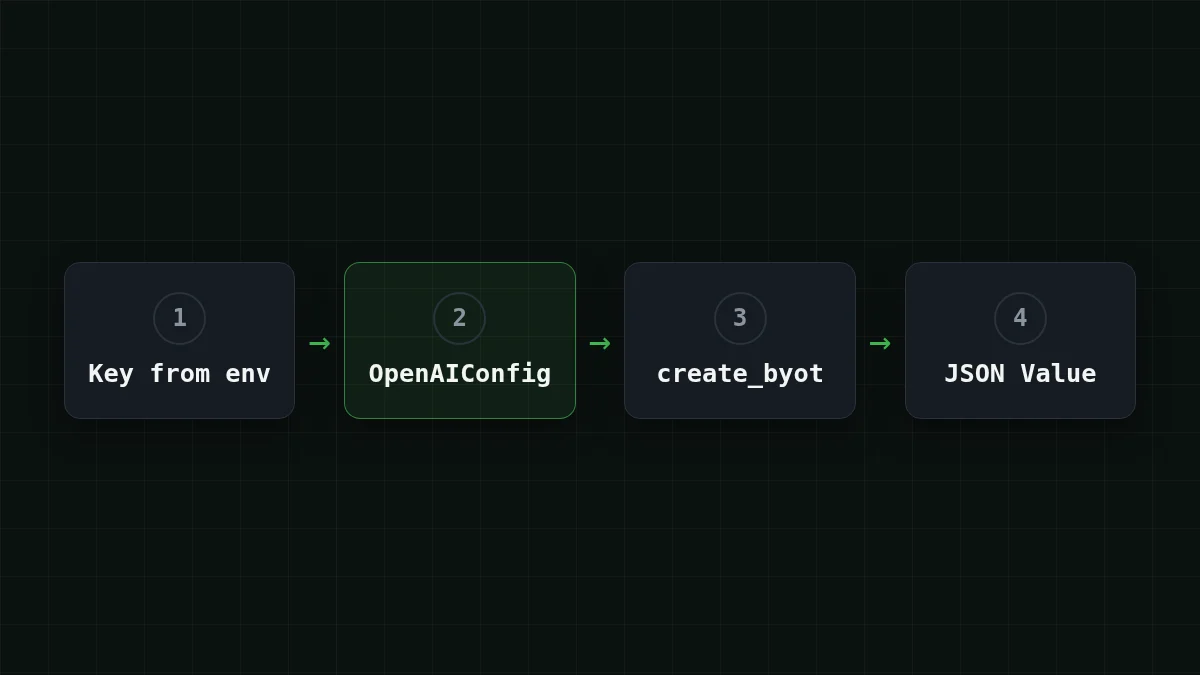
Rust में async-openai के साथ CheapTokens को कॉल करने के लिए, बेस URL https:/ और अपनी कुंजी के साथ एक OpenAIConfig बनाएं, फिर create_byot और एक JSON बॉडी के साथ अनुरोध भेजें। उत्तर पाठ और टोकन गणना वापस आने वाले JSON से प्राप्त होते हैं। यह लगभग 25 पंक्तियों का कोड है, और एक स्ट्रिंग बदलने के बाद वही प्रोग्राम CheapTokens मॉडल पृष्ठ पर किसी भी मॉडल के लिए काम करता है।
क्रेट का docs.rs पृष्ठ (8 नवंबर 2026 को जाँचा गया) MIT लाइसेंस के तहत संस्करण 0.43.0 सूचीबद्ध करता है, और यह गाइड उसी संस्करण का पालन करती है।
टाइप्ड अनुरोधों के बजाय create_byot क्यों#
async-openai सामान्य रूप से आपको एक टाइप्ड अनुरोध बिल्डर देता है: आप एक स्ट्रक्ट भरते हैं, यह आपको एक स्ट्रक्ट वापस देता है। यह तब तक आरामदायक है जब तक कोई गेटवे ऐसा फ़ील्ड नहीं लौटाता जिसे स्ट्रक्ट नहीं जानते। byot सुविधा ("अपने प्रकार लाएं") *_byot विधियाँ जोड़ती है जो कोई भी JSON बॉडी लेती हैं और कोई भी प्रकार लौटाती हैं जिसे आप डीसेरियलाइज़ कर सकते हैं, जिसमें सादा serde_ भी शामिल है।
पहले अनुरोध के लिए यह बिल्कुल वही है जो आप चाहते हैं। आप वही JSON लिखते हैं जो आप curl कॉल में डालते, और आप सीधे प्रतिक्रिया से usage पढ़ते हैं, बिना किसी प्रकार को देखे।
प्रोजेक्ट सेट करें#
चरण दर चरण
प्रोजेक्ट बनाएं और कुंजी सेट करें
क्रेट्स जोड़ें
एक नए प्रोजेक्ट में (cargo new cheaptokens-), तीन निर्भरताएँ जोड़ें। async-openai को यहाँ दो सुविधाओं की आवश्यकता है: create_byot विधियों के लिए byot और चैट अनुभाग के लिए chat-completion।
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
कुंजी को पर्यावरण चर में रखें
अपने CheapTokens खाते में कुंजी बनाएं और इसे स्रोत कोड से बाहर रखें। यदि आप लंबा संस्करण चाहते हैं, तो API कुंजी को सुरक्षित रूप से कैसे संग्रहीत करें देखें।
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell पर वही पंक्ति $env:CHEAPTOKENS_ है।
प्रोग्राम चलाएं
अगले अनुभाग से कोड को src/main.rs में पेस्ट करें और इसे शुरू करें।
cargo runप्रोग्राम#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
तीन पंक्तियाँ पूरा विचार रखती हैं। with_api_base वह जगह है जहाँ CheapTokens जाता है: बेस URL /v1 पर समाप्त होता है, और async-openai स्वयं एंडपॉइंट पथ जोड़ता है। with_api_key वह मान लेता है जो हमने पर्यावरण से पढ़ा। और model पूर्ण आईडी deepseek- है — मूल्य तालिकाओं के छोटे नाम API द्वारा स्वीकार नहीं किए जाते।
एक Value को अनुपस्थित कुंजी के साथ इंडेक्स करने पर पैनिक के बजाय null मिलता है, इसलिए फ़ील्ड नाम में टाइपो आउटपुट में null के रूप में दिखता है, क्रैश के रूप में नहीं। यह प्रतिक्रिया का पता लगाते समय उपयोगी है।
क्या वापस आता है#
गेटवे OpenAI Chat Completions प्रारूप बोलता है, इसलिए प्रतिक्रिया का सामान्य आकार होता है (यहाँ छोटा किया गया, ... उन फ़ील्ड को चिह्नित करता है जिन्हें हम छोड़ते हैं):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
usage में संख्याएँ आपके अनुरोध के लिए वास्तविक गणनाएँ हैं, इसलिए वे चलाने पर शून्य को प्रतिस्थापित करती हैं। prompt_tokens वह है जो आपने भेजा, completion_ वह है जो मॉडल ने लिखा। उनका बिल अलग-अलग कीमतों पर होता है, जो उन्हें प्रिंट करने का उद्देश्य है। यदि अंतर आपके लिए नया है, तो इनपुट बनाम आउटपुट टोकन इसे पाँच मिनट में समझाता है।
स्वयं आज़माएँइसे आज़माएँ: "max_tokens" को 5 पर सेट करें और फिर से चलाएँ। finish_reason क्या कहता है?उत्तर दिखाएँ
OpenAI Chat Completions प्रारूप में यह length कहता है। मॉडल आपकी सीमा तक पहुँच गया और वाक्य बीच में कट गया। सामान्य उत्तर के साथ यह stop कहता है। यदि आप वास्तविक कार्य में length देखते हैं, तो max_tokens बढ़ाएँ — यह लेख समाधान को कवर करता है।
एक अनुरोध की लागत#
मान लें कि आप इस कॉल को लूप में चलाते हैं, एक छोटा प्रश्न अंदर और एक छोटा उत्तर बाहर: प्रत्येक 300 इनपुट टोकन और 200 आउटपुट टोकन। DeepSeek-V4-Flash पर यह प्रति अनुरोध $0.000025 है, $0.015 प्रति 1M इनपुट टोकन और $0.10 प्रति 1M आउटपुट टोकन की लाइव कीमत से। इनपुट और आउटपुट, दोनों को मिलाकर गिनने पर, यह OpenRouter से सस्ता है, और मॉडल 380K संदर्भ रखता है और 32,768 टोकन तक उत्तर देता है।
नीचे दी गई तालिका हर मॉडल पर वही अनुरोध दिखाती है, 1,000 गुना।
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
प्रति अनुरोध 300 इनपुट और 200 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कीमतें मूल्य पृष्ठ पर रहती हैं।
मॉडल बदलना#
मॉडल बदलने पर कोड नहीं बदलता; केवल "model" में स्ट्रिंग बदलती है। उदाहरण के लिए, zai- में 390K संदर्भ है और 8,192 टोकन तक उत्तर देता है। कोड को बिल्कुल भी संपादित करने से बचने के लिए, std::env::var("CHEAPTOKENS_ के साथ दूसरे चर से आईडी पढ़ें। यदि आप सुनिश्चित नहीं हैं कि आपकी कुंजी कौन सी आईडी देखती है, तो GET /v1/models के साथ मॉडल सूचीबद्ध करें।
यदि यह काम नहीं करता है#
environment variable not foundबिल्कुल शुरुआत में: कुंजी इस टर्मिनल में निर्यात नहीं की गई है। इसे उसी विंडो में फिर से निर्यात करें जहाँ आपcargo runचलाते हैं।- API से 401 त्रुटि: कुंजी गलत है या उसके चारों ओर कोई अतिरिक्त स्थान या उद्धरण है।
- 404 त्रुटि: जाँचें कि बेस URL
/v1पर समाप्त होता है और मॉडल आईडी पूर्ण है,deepseek-ai/उपसर्ग के साथ। API 401 या 404: कुंजी, बेस URL, मॉडल आईडी इसे समझाता है। - कंपाइलर
create_byotनहीं ढूँढ पा रहा है:byotसुविधा सक्षम नहीं है। सेटअप सेcargo addपंक्ति फिर से चलाएँ।
यदि कोई कनेक्शन समस्या इनमें से कोई नहीं है, तो सामान्य कनेक्शन त्रुटियाँ देखें।
वही पहला अनुरोध अन्य भाषाओं के लिए भी मौजूद है: Go और Ruby। API के बारे में अधिक जानने के लिए, CheapTokens दस्तावेज़ खोलें।


