API और SDKगाइड
openai gem के साथ Ruby में पहला request: base_url, key, usage
एक छोटी Ruby स्क्रिप्ट: आधिकारिक openai gem, custom base_url और env से key। reply text और token usage print करती है।
इस पृष्ठ पर
हाँ, आधिकारिक openai gem CheapTokens के साथ काम करता है: base_ और अपनी key को OpenAI::Client. में पास करें, client. कॉल करें, और choices. से टेक्स्ट पढ़ें। इस पेज का बाकी हिस्सा पूरी स्क्रिप्ट है, जो वापस आता है उसे कैसे पढ़ें, और जब यह न चले तो क्या जाँचें।
मान लीजिए आपके पास एक rake task है जो support tickets को label करता है, या एक background job है जो किसी note को सेव करने से पहले उसका सारांश बनाता है। आपको आधिकारिक SDK चाहिए, हाथ से लिखा HTTP नहीं, और आप देखना चाहते हैं कि हर कॉल में कितने tokens लगे। यही यह स्क्रिप्ट है।
शुरू करने से पहले आपको क्या चाहिए#
RubyGems पर gem पेज (8 नवंबर 2026 को जाँचा गया) openai 0.120.0 सूचीबद्ध करता है, जो 5 नवंबर 2026 को रिलीज़ हुआ, Apache-2.0। इसे Ruby 3.3.0 या नया चाहिए; अगर आप Ruby 3.2 पर अटके हैं, तो gem के अपने नोट्स 0.75.x लाइन की ओर इशारा करते हैं। पैकेज अभी भी 0.x है और तेज़ी से बदलता है, इसलिए version pin करें।
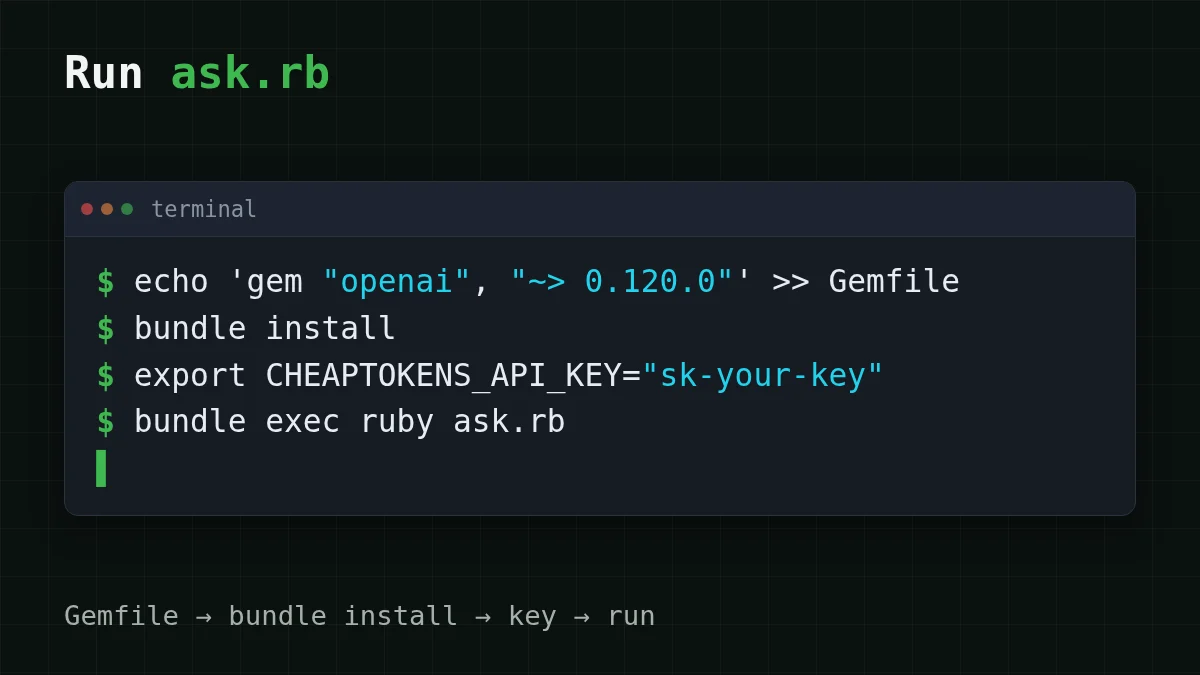
अपने Gemfile में:
gem "openai", "~> 0.120.0"फिर bundle install। Bundler के बिना, gem install openai - वही काम करता है।
आपको अपने CheapTokens account से एक API key भी चाहिए। इसे code से बाहर रखें: इसे एक environment variable में डालें, और अगर .gitignore शब्द आपके लिए नया है, तो keys को सुरक्षित रखने पर यह गाइड पाँच मिनट का पाठ है।
export CHEAPTOKENS_API_KEY="sk-your-key"स्क्रिप्ट#
ask.rb बनाएँ:
require "openai"

client = OpenAI::Client.new(
  api_key: ENV.fetch("CHEAPTOKENS_API_KEY"),
  base_url: "https://api.cheaptokens.dev/v1"
)

completion = client.chat.completions.create(
  model: "deepseek-ai/DeepSeek-V4-Flash-0731",
  messages: [
    { role: "user", content: "Explain in one sentence what a token is." }
  ]
)

choice = completion.choices.first
puts choice.message.content
puts "finish_reason: #{choice.finish_reason}"
puts completion.usage
इसे ruby ask.rb से चलाएँ। तीन चीज़ें दोबारा देखने लायक हैं।
ENV[...] के बजाय ENV.fetch। अगर variable मौजूद नहीं है, तो fetch तुरंत एक KeyError के साथ रुक जाता है जो उसका नाम बताता है। ENV[...] चुपचाप nil पास कर देता है और आपको कुछ लाइनों बाद एक भ्रमित करने वाला authentication error मिलता है।
base_url: ही एकमात्र लाइन है जो gem के README में दिए OpenAI उदाहरणों से अलग है। बाकी सब वही code है, और OpenAI-compatible API का पूरा मतलब यही है। अगर यह विचार नया है, तो base_url क्या है और कैसे बदलें इसे एक restaurant analogy के साथ समझाता है।
Model id पूरा वाला है, deepseek-। किसी price table से छोटा नाम API स्वीकार नहीं करता; ids CheapTokens docs से या GET /v1/models से लें।
जो वापस आता है उसे पढ़ना#
Reply एक object है, hash नहीं, इसलिए आप उस पर methods कॉल करते हैं। टेक्स्ट completion. पर है; gem का README भी यही path इस्तेमाल करता है।
पहले दिन से दो और लाइनें print करने लायक हैं:
finish_reasonबताता है कि model क्यों रुका।stopसामान्य अंत है।lengthका मतलब है कि किसी length limit ने जवाब काट दिया। अगर आपको यह कभी दिखे, तो जवाब क्यों कट जाते हैं और इसे कैसे ठीक करें।usageमें वे tokens होते हैं जिनके लिए कॉल का बिल बना: आपने जो भेजा और model ने जो लिखा। स्क्रिप्टputs completion.के साथ पूरा object print करती है, इसलिए आप दोनों संख्याएँ वैसे ही देखते हैं जैसे API ने लौटाईं।usage
इन्हें log क्यों करें? क्योंकि tokens ही बिल हैं। एक वाक्य का सवाल और एक वाक्य का जवाब बहुत छोटा है, लेकिन दिन में हज़ार बार चलने वाला job नहीं। Input vs output tokens समझाता है कि दूसरी संख्या का प्रति token खर्च आमतौर पर ज़्यादा क्यों होता है।
ऐसी कॉल की लागत#
CheapTokens पर DeepSeek-V4-Flash $0.015 प्रति 1M input tokens और $0.10 प्रति 1M output tokens है, दिन के किसी भी घंटे में वही कीमत। एक ticket-labeling job लें: प्रति ticket लगभग 300 tokens अंदर, 150 tokens बाहर। एक ticket की लागत $0.00002 है। हज़ार tickets ऐसे दिखते हैं, अगली column में OpenRouter का reference price:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0225 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.042 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.45 |
प्रति अनुरोध 300 इनपुट और 150 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
Model 380K tokens तक context और एक जवाब में 32,768 tokens तक लेता है, इसलिए summarizing job शायद ही कभी दीवार से टकराता है। अगर आप उसी स्क्रिप्ट से दूसरा model आज़माना चाहें, तो सिर्फ़ model: string को zai- में बदलें (390K context, 8,192 output tokens तक)।
अगर यह न चले#
पहली बार चलाने की ज़्यादातर विफलताएँ पाँच में से एक होती हैं। जो आपकी स्क्रीन से मेल खाए उसे चुनें।
अपना मामला चुनें
आपको क्या दिखता है?
उत्तर देखने के लिए एक विकल्प चुनें
KeyError: key not found: "CHEAPTOKENS_API_KEY"
Variable इस terminal में सेट नहीं है। export लाइन फिर चलाएँ, या नया shell खोलें और echo $CHEAPTOKENS_ से जाँचें।
401 Unauthorized
Key मौजूद है पर गलत है: कोई अतिरिक्त space या quote, अधूरा paste, या पुरानी key। इसे अपने account से फिर copy करें।
404 Not Found
पहले base_url जाँचें: यह /v1 पर खत्म होता है और इसके बाद कोई अतिरिक्त path नहीं है। फिर model id जाँचें: यह deepseek-ai/ prefix वाला पूरा id है।
cannot load such file -- openai
Gem इस Ruby के लिए install नहीं है। bundle install चलाएँ और स्क्रिप्ट bundle exec ruby ask. से शुरू करें।
Bundler कोई काम करने वाला version नहीं ढूँढ पा रहा
ruby -v जाँचें। 0.120.x लाइन को Ruby 3.3.0 या नया चाहिए; 3.2 पर इसके बजाय 0.75.x लाइन pin करें।
401 और 404 वाले मामले हर SDK में आते हैं, सिर्फ़ Ruby में नहीं; API 401 या 404: गलत key, base URL या model id इन्हें क्रम से समझाता है।
त्वरित जाँच
finish_reason "length" आपको क्या बताता है?
उत्तर दिखाएँ
उत्तर: जवाब किसी length limit से काट दिया गया
stop सामान्य अंत है; length का मतलब है कि model के पूरा होने से पहले जवाब किसी limit पर पहुँच गया।
आगे कहाँ जाएँ#
अब आपके पास सबसे छोटा उपयोगी loop है: भेजें, टेक्स्ट पढ़ें, tokens log करें। यहाँ से, कॉल को एक method में लपेटें, और अपने logger में usage संख्याएँ जोड़ें। अगर आपका stack मिला-जुला है तो यही pattern दूसरी भाषाओं में भी है: Go, Java और C#। models और कीमतों की पूरी सूची models page पर है, और API reference docs में है।


