API e SDKGuida
Prima richiesta in Ruby con la gem openai: base_url, chiave, usage
Uno script Ruby breve: la gem openai ufficiale, un base_url personalizzato e una chiave da env. Stampa il testo della risposta e l'usage dei token.
In questa pagina
Sì, la gem ufficiale openai funziona con CheapTokens: passa base_ e la tua chiave a OpenAI::Client., chiama client. e leggi il testo da choices.. Il resto di questa pagina è lo script completo, come leggere ciò che torna indietro e cosa controllare quando non funziona.
Immagina di avere un rake task che etichetta i ticket di supporto, o un job in background che riassume una nota prima di salvarla. Vuoi l'SDK ufficiale, non HTTP scritto a mano, e vuoi vedere quanti token ha usato ogni chiamata. Questo script fa esattamente questo.
Cosa ti serve prima di iniziare#
La pagina della gem su RubyGems (verificata l'8 novembre 2026) riporta openai 0.120.0, rilasciata il 5 novembre 2026, Apache-2.0. Richiede Ruby 3.3.0 o superiore; se sei bloccato su Ruby 3.2, le note della gem stessa rimandano alla linea 0.75.x. Il pacchetto è ancora 0.x e si muove veloce, quindi fissa la versione.
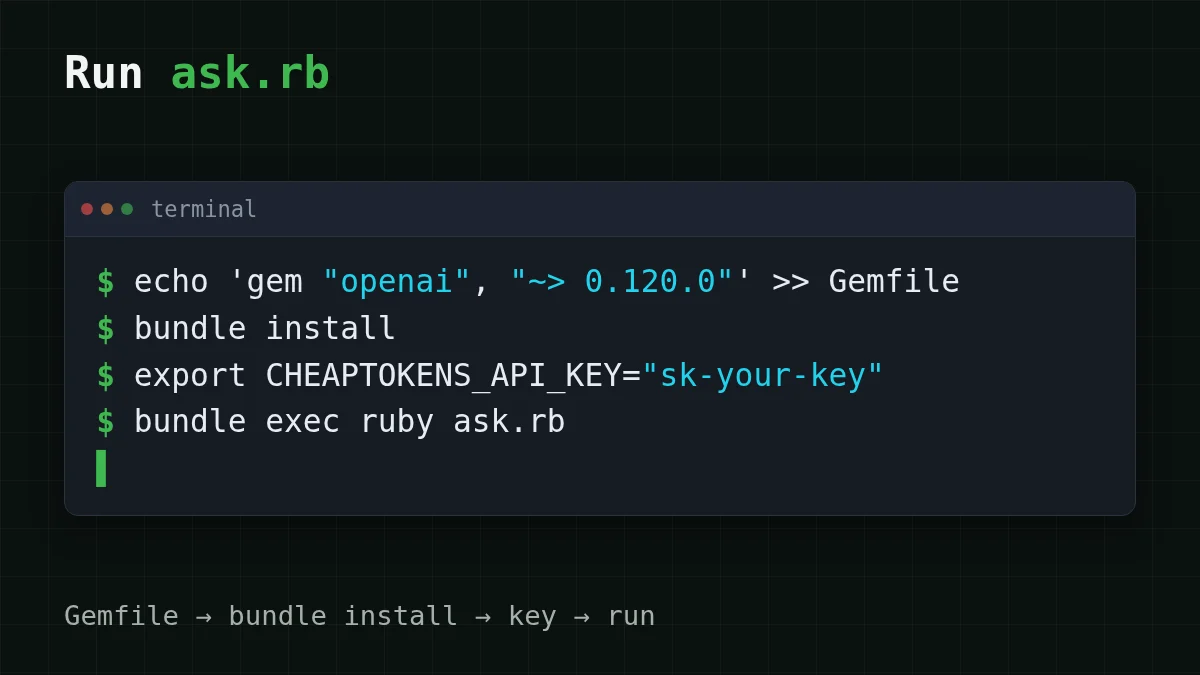
Nel tuo Gemfile:
gem "openai", "~> 0.120.0"Poi bundle install. Senza Bundler, gem install openai - fa lo stesso.
Ti serve anche una chiave API dal tuo account CheapTokens. Tienila fuori dal codice: mettila in una variabile d'ambiente e, se la parola .gitignore è nuova per te, questa guida su come tenere al sicuro le chiavi è una lettura da cinque minuti.
export CHEAPTOKENS_API_KEY="sk-your-key"Lo script#
Crea ask.rb:
require "openai"

client = OpenAI::Client.new(
  api_key: ENV.fetch("CHEAPTOKENS_API_KEY"),
  base_url: "https://api.cheaptokens.dev/v1"
)

completion = client.chat.completions.create(
  model: "deepseek-ai/DeepSeek-V4-Flash-0731",
  messages: [
    { role: "user", content: "Explain in one sentence what a token is." }
  ]
)

choice = completion.choices.first
puts choice.message.content
puts "finish_reason: #{choice.finish_reason}"
puts completion.usage
Eseguito con ruby ask.rb. Tre cose meritano un secondo sguardo.
ENV.fetch invece di ENV[...]. Se la variabile manca, fetch si ferma subito con un KeyError che la nomina. ENV[...] passa silenziosamente nil e ottieni un errore di autenticazione confuso qualche riga dopo.
base_url: è l'unica riga che differisce dagli esempi OpenAI nel README della gem. Tutto il resto è lo stesso codice, che è esattamente il punto di un'API compatibile con OpenAI. Se l'idea è nuova, cos'è base_url e come cambiarlo lo spiega con l'analogia del ristorante.
L'id del modello è quello completo, deepseek-. Il nome breve di una tabella prezzi non è accettato dall'API; prendi gli id dalla documentazione CheapTokens o da GET /v1/models.
Leggere ciò che torna indietro#
La risposta è un oggetto, non un hash, quindi chiami metodi su di esso. Il testo si trova in completion.; è il percorso usato anche dal README della gem.
Altre due righe meritano di essere stampate fin dal primo giorno:
finish_reasonti dice perché il modello si è fermato.stopè una fine normale.lengthsignifica che un limite di lunghezza ha interrotto la risposta. Se ti capita, perché le risposte vengono troncate e come risolvere.usagecontiene i token fatturati per la chiamata: quelli che hai inviato e quelli che il modello ha scritto. Lo script stampa l'intero oggetto conputs completion., così vedi entrambi i numeri come li ha restituiti l'API.usage
Perché registrarli? Perché i token sono la bolletta. Una domanda di una frase con una risposta di una frase è poca cosa, ma un job che gira mille volte al giorno no. Token di input vs output spiega perché il secondo numero di solito costa di più per token.
Quanto costa una chiamata così#
DeepSeek-V4-Flash su CheapTokens costa $0.015 per 1M token di input e $0.10 per 1M token di output, con lo stesso prezzo a qualsiasi ora del giorno. Prendi un job di etichettatura ticket: circa 300 token in input, 150 token in output per ticket. Un ticket costa $0.00002. Mille ticket si presentano così, con il prezzo di riferimento di OpenRouter nella colonna accanto:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0225 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.042 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.45 |
300 token di input e 150 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Il modello supporta fino a 380K token di contesto e fino a 32.768 token in una singola risposta, quindi un job di riassunto raramente sbatte contro un muro. Se preferisci provare un secondo modello con lo stesso script, cambia solo la stringa model: in zai- (390K di contesto, fino a 8.192 token di output).
Se non funziona#
La maggior parte dei fallimenti al primo avvio è uno di cinque casi. Scegli quello che corrisponde al tuo schermo.
Scegli il tuo caso
Cosa vedi?
Scegli un'opzione per vedere la risposta
KeyError: key not found: "CHEAPTOKENS_API_KEY"
La variabile non è impostata in questo terminale. Esegui di nuovo la riga export, oppure apri una nuova shell e controlla con echo $CHEAPTOKENS_.
401 Unauthorized
La chiave c'è ma è sbagliata: uno spazio o una virgoletta di troppo, un incolla troncato o una chiave vecchia. Copiala di nuovo dal tuo account.
404 Not Found
Controlla prima base_url: termina con /v1 e non ha percorsi extra dopo. Poi controlla l'id del modello: è l'id completo con il prefisso deepseek-ai/.
cannot load such file -- openai
La gem non è installata per questo Ruby. Esegui bundle install e avvia lo script con bundle exec ruby ask..
Bundler can't find a version that works
Controlla ruby -v. La linea 0.120.x richiede Ruby 3.3.0 o superiore; su 3.2 fissa invece la linea 0.75.x.
I casi 401 e 404 si presentano con ogni SDK, non solo con Ruby; API 401 o 404: chiave, base URL o id del modello sbagliati li affronta in ordine.
Verifica rapida
Cosa ti dice finish_reason "length"?
Mostra risposta
Risposta: La risposta è stata troncata da un limite di lunghezza
stop è una fine normale; length significa che la risposta ha raggiunto un limite prima che il modello avesse finito.
Dove andare adesso#
Ora hai il ciclo utile più piccolo: invia, leggi il testo, registra i token. Da qui, avvolgi la chiamata in un metodo e aggiungi i numeri usage al tuo logger. Lo stesso schema esiste in altri linguaggi se il tuo stack è misto: Go, Java e C#. L'elenco completo di modelli e prezzi è nella pagina dei modelli, e il riferimento API è nella documentazione.


