API e SDKGuida
Prima richiesta in Java con openai-java: URL di base, chiave, utilizzo
Un programma Java 8+ eseguibile: openai-java puntato a CheapTokens, un completamento chat e la stampa di risposta, finish_reason e utilizzo dei token.
In questa pagina
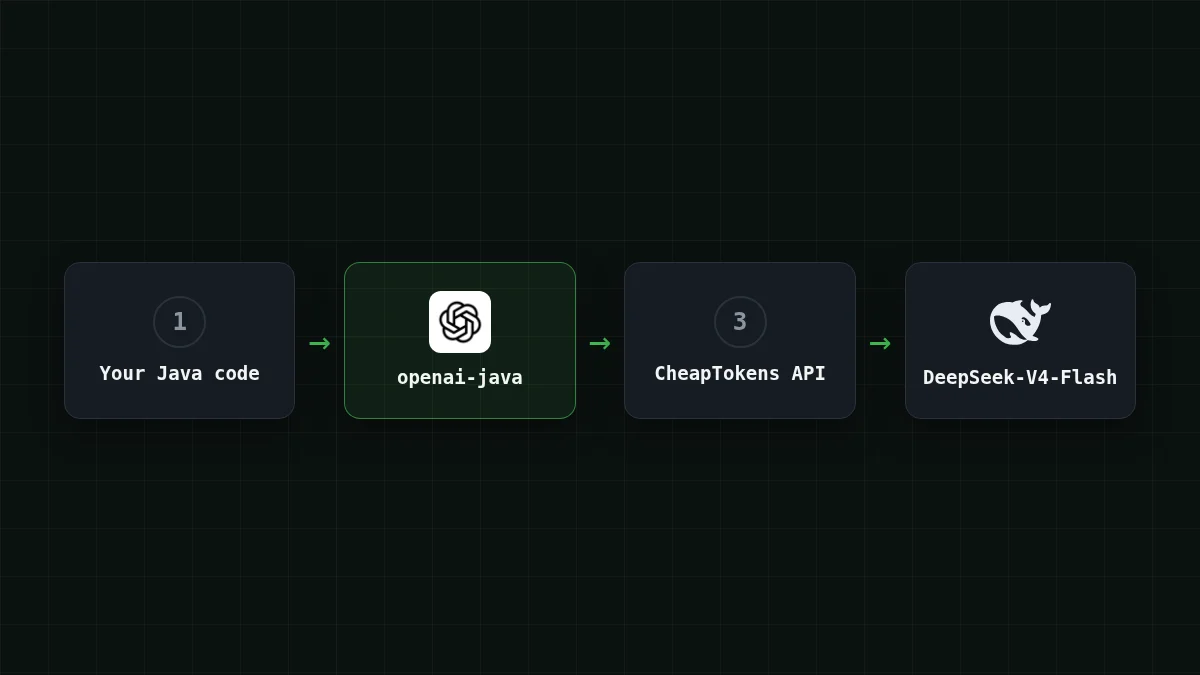
Per chiamare CheapTokens da Java, mantieni l'SDK ufficiale openai-java e cambia tre cose: l'URL di base (https:/), la chiave API e l'id del modello, passato come semplice String. Il programma qui sotto invia un completamento chat e stampa la risposta, il finish_reason e l'utilizzo dei token. Richiede Java 8 o successivo.
Se il tuo team ha già un servizio Spring che parla con OpenAI, questa è l'intera migrazione: nessun nuovo client, nessuna nuova classe di richiesta.
Aggiungi la dipendenza#
Il README dell'SDK (github.com/openai/openai-java, verificato il 4 novembre 2026) mostra la versione 4.99.0, gruppo com.openai, artifact openai-java. Il README non riporta una data di rilascio, quindi controlla il repository per la versione più recente prima di copiare questo.
Aggiungi openai-java alla tua build
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")Gli artifact framework-neutral girano su Java 8+, quindi un JDK aziendale più vecchio non è un ostacolo.
Imposta la chiave e l'URL di base fuori dal codice#
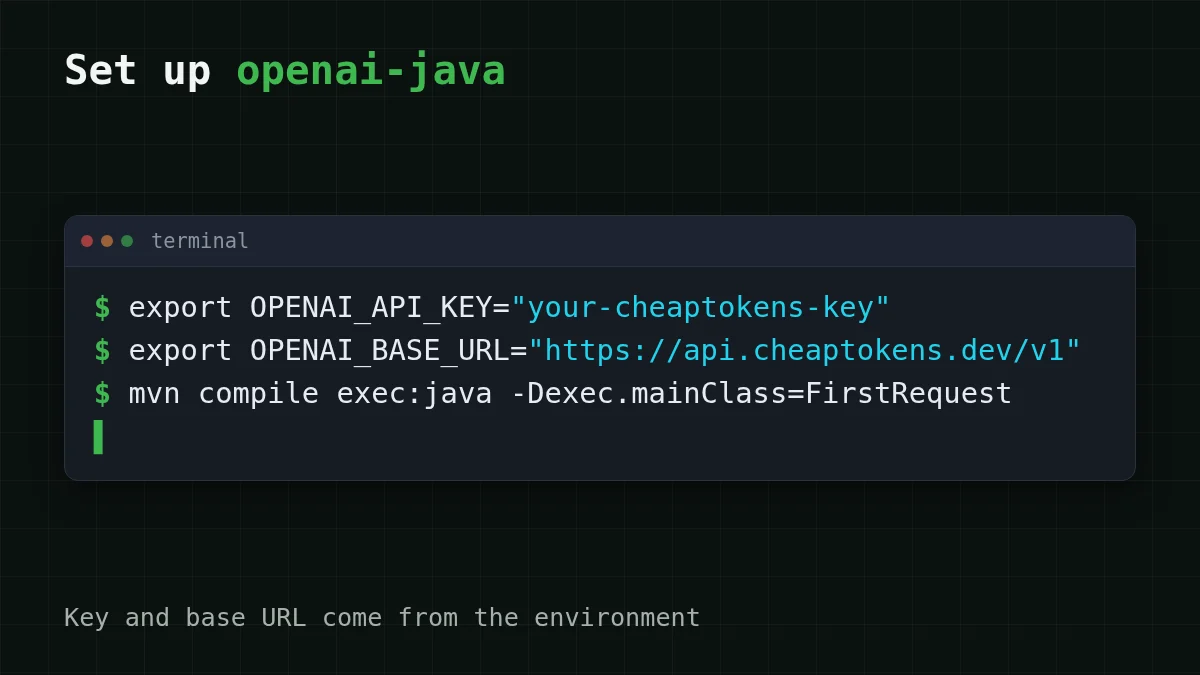
L'SDK legge due variabili d'ambiente: OPENAI_API_KEY e OPENAI_BASE_URL. OpenAIOkHttpClient. le preleva entrambe, così la chiave non finisce mai nei tuoi file sorgente. (Funzionano anche le proprietà di sistema openai.apiKey e openai.baseUrl, che hanno precedenza sulle variabili.)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
L'URL di base predefinito dell'SDK è https:/. Salta la seconda riga e la tua richiesta va lì, con una chiave CheapTokens che non conosce. È uno dei modi per ottenere un 401 al primo avvio. Per dove conservare la chiave e come tenerla fuori da git, vedi conservare una chiave API in modo sicuro.
Il programma#
Crea FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
Alcune righe meritano un secondo sguardo.
.. Gli esempi nel README dell'SDK usano costanti tipizzate comemodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel., ma il builder ha anche un overloadGPT_ 5_ 2 model(String), quindi qualsiasi id funziona. Usa l'id completo dalla documentazione di CheapTokens: il nome brevedeepseek-è come vengono etichettati i prezzi sul sito; l'API vuole l'id completo con il prefissov4- flash- 0731 deepseek-ai/. Non sei sicuro di un id? Elenca i modelli con GET /v1/models... Un limite alla lunghezza della risposta, comemaxCompletionTokens(300L) long. DeepSeek-V4-Flash consente fino a 32.768 token di output per risposta, quindi 300 qui è una scelta per mantenere breve la demo, non un limite del modello.content()è unOptional. Ecco perché il programma haorElse. Una risposta fatta solo di tool call non ha testo.usage()è anch'esso unOptional.ifPresentlo stampa quando il server lo invia.
Compilalo ed eseguilo come fa la tua build (mvn compile exec:java -, o un task JavaExec in Gradle). Dovresti ottenere la spiegazione di un token, poi una riga finish_reason: … con stop al suo interno, poi una riga con i conteggi dei token di input e output. Se finish_reason dice length, la risposta ha raggiunto il tuo limite di 300 token ed è stata troncata: aumenta il numero (perché succede).
usage() restituisce i conteggi dei token di prompt, completion e totali (promptTokens(), completionTokens(), totalTokens()).
Imposta i valori esplicitamente con il builder#
I test, o un servizio con più client, a volte richiedono valori espliciti. Lo stesso client, costruito a mano:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
Tutto ciò che segue questa riga, i parametri e la chiamata create, resta esattamente come sopra. Continua a leggere la chiave dall'ambiente anche qui; un letterale stringa in un file .java finisce nel tuo repository.
Tre errori che incontrerai per primi#
Abbina le coppie
Abbina il sintomo alla causa
Tocca un elemento a sinistra, poi il suo abbinamento
- 401 Unauthorizedla chiave è vuota o errata, oppure la richiesta è andata a api.openai.com perché
OPENAI_BASE_URLnon è impostata - 404 Not Foundall'URL di base manca
/v1, oppure l'id del modello non esiste - finish_reason dice length
maxCompletionTokensè inferiore a quanto serve alla risposta
Una variabile d'ambiente vuota è facile da trascurare in un IDE: una configurazione di esecuzione avviata dalla toolbar potrebbe non ereditare le variabili che hai esportato nel terminale. Se la chiave "è impostata" ma ricevi comunque 401, aggiungi le variabili alla configurazione di esecuzione. Altro su questi codici: API 401 o 404: chiave, URL di base, id del modello.
Quanto costa una richiesta#
Poiché stampi usage, puoi calcolare il prezzo della richiesta prima di scalarla. Supponiamo che il tuo servizio invii circa 200 token di input e ne riceva 300. Ai prezzi attuali quella richiesta costa $0.000033 su DeepSeek-V4-Flash. Input e output vengono fatturati insieme, e in totale è più economico di OpenRouter. La tabella lo ripete per 1.000 richieste sui nostri modelli:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Ora inserisci il tuo traffico. Trascina gli slider ai numeri della tua prima riga usage stampata:
Calcolatore di costi
Un servizio di supporto con 2.000 richieste al giorno
Token di input per richiesta: 200 · Token di output per richiesta: 300 · Richieste al giorno: 2000
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
Per più spazio per risposta o una diversa forma di carico di lavoro, DeepSeek-V4-Flash offre una finestra di contesto di 380K e un prezzo unico a qualsiasi ora del giorno; GLM-5.3-Flash (zai-) è un sostituto drop-in nello stesso programma: cambia l'id, nient'altro. I prezzi attuali per tutti i modelli sono sulla pagina dei prezzi, e la documentazione mostra la stessa richiesta in altre lingue. Lo fai in Go? Vedi la versione openai-go.


